はじめに
#6 の EKF と UKF は、線形でない対象を扱えるようにしたカルマンフィルタでした。ただし、どちらも分布を平均と共分散の 2 つの数で表します。#6 の検証の章では、この表し方そのものが原因で救えない例が 2 つ残りました。
1 つ目は sin θ の鏡像です。1 軸の加速度センサは g sin θ を測るので、70° と 110° を区別できません。#6 では、真値 70° に対して UKF は 110° へ行き、真値 120° に対して EKF は 60° へ行きました。2 つ目は ρ = 19 の距離と方位です(ρ は #6 で導いた、測定の分布がどれだけ弓なりかを表す数)。この条件 C では UKF でも NEES(真の誤差を P で割って大きさをそろえた検証量。理想は状態の数)が 49 で、理想の 4 から大きく外れました。
この 2 つで分布がどんな形をしているのかを描いたのが次の図です。
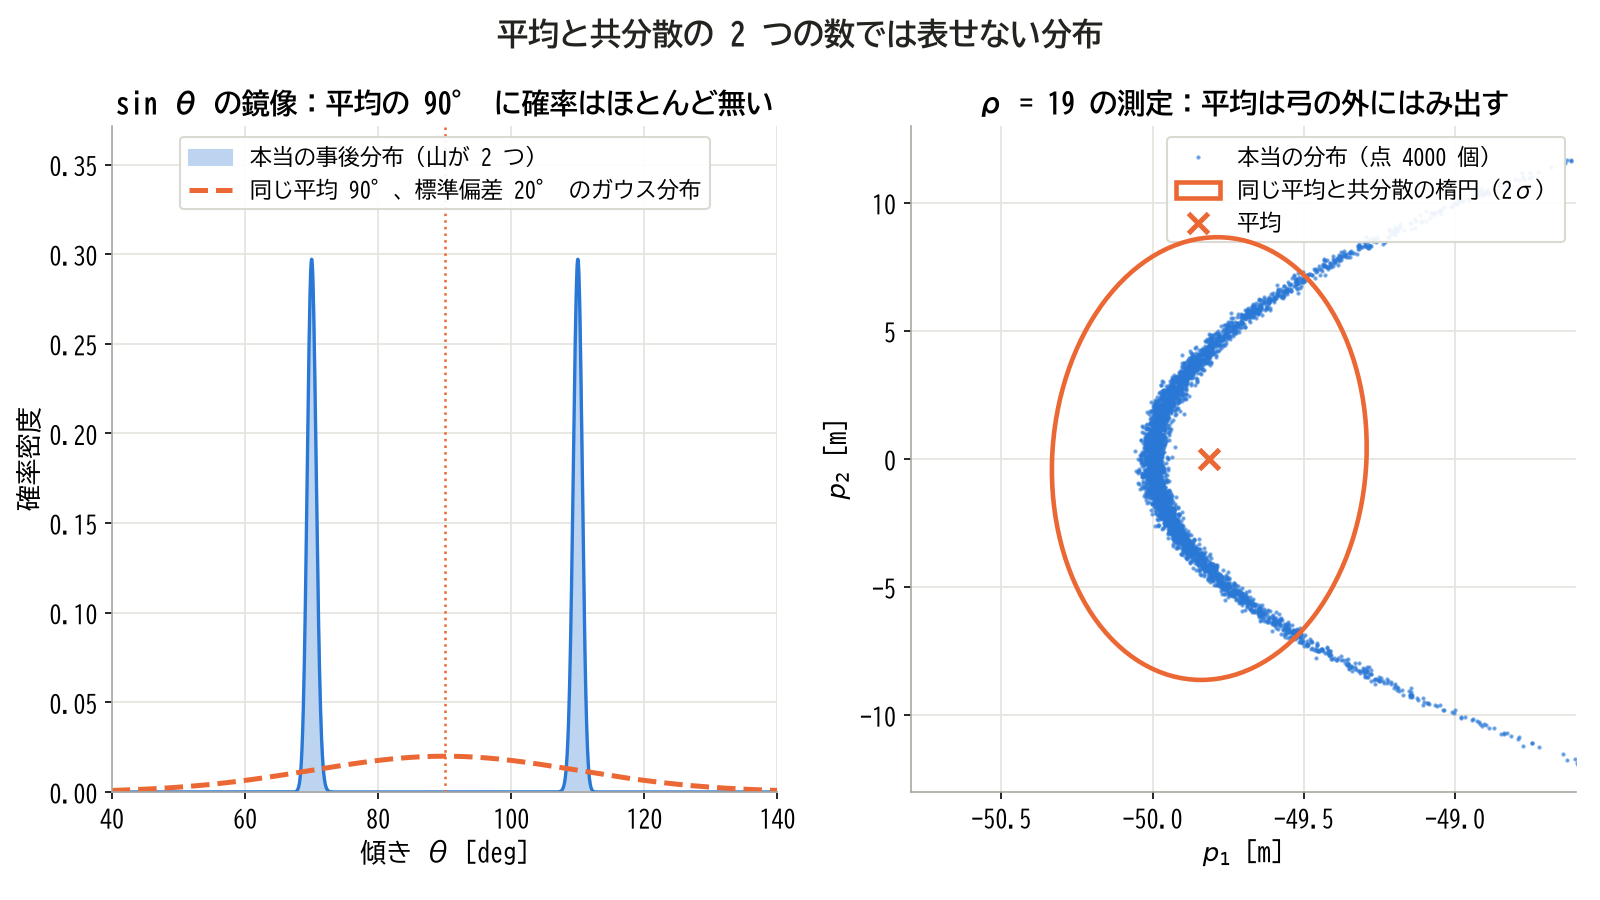
左:平均は山のない 90°。同じ平均と分散のガウス分布は、どちらの山も表せない。右:点の雲の平均は弓の内側に出て、楕円の中心には点がない
左の図の青が、測定を 1 回受けたあとの本当の分布です。平均は 90°、標準偏差は 20° で、この 2 つの数からガウス分布を作るとオレンジの破線になります。確率のある 70° と 110° はほとんど覆えず、確率のない 90° がいちばん高くなります。右の図も同じです。点は細い円弧の上に乗っているのに、平均は弓の内側で、点がない場所を指します。
平均と共分散をどれだけ正確に計算しても、この形は表せません。そこで、分布そのものを多数の点で持つことにします。これがパーティクルフィルタです。
この記事のゴールは、分布がガウス分布に近くない対象に対してパーティクルフィルタを設計し、必要な粒子の数を見積もり、正しく動いているかを数字で判定できるようになることです。モンテカルロ積分から 1 段ずつ導出し、手計算で 1 周回し、線形の対象で #5 のカルマンフィルタに戻ることを確かめます。そのうえで、#6 の 2 つの例を解き、廊下を動くロボットの位置を推定します。実機は使わず、すべて計算と数値シミュレーションで示します。
- #1 基礎編 — サンプリング、伝達関数、ボード線図、効き目の測り方、C の骨格
- #2 ローパス — 移動平均、1 次 IIR、2 次バターワースを同じカットオフで比べる
- #3 ハイパス — DC とドリフトを消す
- #4 バンドパスとノッチ — Q と Audio EQ Cookbook で狙った周波数を扱う
- #5 カルマンフィルタ — モデルと分散で切り分ける
- #6 EKF・UKF — 線形でない対象へ広げる
- #7 パーティクルフィルタ(この記事) — 分布をサンプルで持つ
- #8 適応フィルタ — 入力と誤差から係数を学習する
- #9 以降 用途別のフィルタ(予定)
この記事で分かること: パーティクルフィルタがカルマンフィルタの何を捨てて何を得たのか、サンプルで積分すると誤差がなぜ 1/√N で減るのか、重みの式がどこから出るのか、リサンプリング(重みに比例して粒子を選び直す操作)がなぜ要るのか、粒子が足りなくなるのはどんな条件か、そして線形カルマン、EKF、UKF、パーティクルフィルタを何にどう使い分けるかの勘所が分かります。
読み終えたときにできること: 状態方程式と尤度(その状態のときに今の測定が出る確率)からパーティクルフィルタを書き、Python と C で動かせます。有効サンプル数(重みの偏りを「実質何個の粒子か」で表した数)を見てリサンプリングの時期を決め、粒子の数と提案分布を選び、95 % 区間に真値が入る割合で設計を判定できます。
#5 カルマンフィルタ の予測と更新、ベイズの定理、#6 EKF・UKF の非線形の状態空間表現、NIS、NEES、ρ を読んだ方を想定しています。記号は #5、#6 を引き継ぎますが、#6 で状態の数を表していた N を、この記事では粒子の数に使い、状態の数は d と書きます。 #6 の式を引くときも d に読み替えます。確率の用語は使う場所で説明します。
🧭 パーティクルフィルタとは
パーティクルフィルタは、状態の分布を多数のサンプルで表し、測定の列から再帰的に推定するアルゴリズムです。定義を 1 文で書きます。
測定を受けたあとの状態の分布(事後分布)を、N 個のサンプル(粒子)とその重みで表す推定法。予測では各粒子を状態方程式に乱数つきで通し、更新では測定の尤度に応じて重みを掛け直し、重みが偏ったら重みに比例して粒子を選び直す(リサンプリング)。逐次モンテカルロ法(Sequential Monte Carlo、SMC)とも呼ぶ。
語をほどきます。
- 事後分布:測定を見たあとの、状態についての確率分布。測定を見る前の分布は事前分布と呼ぶ
- サンプル:分布から乱数で取り出した 1 個の値。たくさん集めると、値の濃いところが確率の高いところになる
- 粒子(パーティクル):フィルタが持つサンプル。1 個の粒子が「状態はこの値かもしれない」という仮説を 1 つ表す
- 重み:その仮説の確からしさ。全粒子の和が 1 になるように正規化する
- 尤度:状態が x のときに今の測定 y が出る確率 p(y|x)。y を固定して x の関数として見たもの
- モンテカルロ法:乱数のサンプルで積分や平均を計算する方法
EKF は分布を線形化で運び、UKF は代表点で運びましたが、どちらも最後は平均と共分散にまとめ直しました。パーティクルフィルタはまとめ直しません。ガウス近似も線形化も使わない代わりに、精度は粒子の数 N で決まります。 N を増やせば正しい分布に近づき、足りなければ外れます。「十分な N」がいくつなのかが、この記事の主な論点です。
何を渡すと何が返るのか
#5、#6 の表との違いを並べます。
| 区分 | 線形カルマン | EKF、UKF | パーティクル |
|---|---|---|---|
| 対象の式 | 行列 A、B、C | 関数 f、h | f から乱数で引く手順と尤度 |
| 分布の持ち方 | 平均と共分散 | 平均と共分散 | N 個の粒子と重み |
| 出力 | x̂ と P | x̂ と P | 分布そのもの |
| 1 ステップの f、h | 各 1 回 | EKF は各 1 回 | 各 N 回 |
出力が分布そのものであることが、これまでとの大きな違いです。平均や分散は、必要なら粒子から計算します。山が 2 つあるなら 2 つあるまま返せますし、「90° 付近の確率」のような問いにも、その範囲の粒子の重みを足すだけで答えられます。
名前の由来
モンテカルロという名前は、Metropolis の回想によると、Ulam におじがいて「どうしてもモンテカルロへ行かなければ」と親戚から金を借りていたことにちなんで、Metropolis が提案したものです。方法の名前として論文に出たのは Metropolis と Ulam の 1949 年の論文です。
フィルタの呼び名はいくつもあります。分布をサンプルで運ぶ考え方自体は古く、Handschin と Mayne の 1969 年の論文に、モンテカルロで非線形フィルタの条件付き期待値を計算する手法が出てきます。現在の形に必要なリサンプリングが入り、広まったのは 1990 年代です。
- ブートストラップフィルタ:Gordon、Salmond、Smith の 1993 年の論文の名前。この記事の基本形はこれ
- モンテカルロフィルタ:北川源四郎の 1996 年の論文の名前
- 相互作用粒子系による近似:Del Moral が 1996 年に、物理の相互作用粒子系の言葉で数学的に整理した
- パーティクルフィルタ:統計の歴史をまとめた Robert と Casella によると、「粒子」の語が使われたのは 北川(1996)から、「パーティクルフィルタ」の語は Carpenter、Clifford、Fearnhead の 1997 年の報告から
- CONDENSATION:Isard と Blake が 1998 年に発表した、画像の追跡への応用(Conditional Density Propagation)
同じ時期に別の分野で見つかったので、名前が多いのです。
予測と更新の 2 段は同じ
処理の流れは #5、#6 と同じループです。箱の中身が変わり、3 つ目の箱が増えます。
f に通して乱数を足す"] B --> C["更新
測定の尤度を重みに掛ける"] C --> E["重みが偏ったら
リサンプリング"] E --> A
カルマンフィルタの更新は、ゲイン K で状態を動かしました。パーティクルフィルタの更新は、粒子を動かしません。 粒子の位置はそのままで、重みだけを変えます。測定に近い粒子の重みが増え、遠い粒子の重みが減ることで、分布が測定の側へ寄ります。
前提
ブートストラップフィルタに必要なものは、次の 3 つです。カルマンフィルタより少ないことに注目してください。
- モデルから乱数で引ける:今の状態を与えると、次の状態のサンプルを 1 個作れること。式で書けなくても、シミュレータでもかまわない
- 尤度が計算できる:p(y|x) の値を、定数倍を除いて計算できること。ガウス分布である必要はない
- 状態のどの成分にも揺らぎが入る:プロセスノイズがまったく入らない成分があると、リサンプリングのたびに値の種類が減る。この問題は後の章で扱う
ノイズがガウス分布でも、f や h が線形でなくても、微分できなくてもかまいません。扉の有無のように 0 か 1 かで出るセンサもそのまま扱えます。
🎲 分布をサンプルで持つ
パーティクルフィルタの計算は、すべて「サンプルで積分する」操作です。まずこの土台を確かめます。カルマンフィルタの式はガウス分布の積から出ましたが、ここから先の式は積分の近似から出ます。
モンテカルロ積分
分布 p(x) に従う x について、関数 ψ(x) の期待値(確率で重みを付けた平均)を求めたいとします。
\mathrm{E}[\psi(x)] = \int \psi(x)\,p(x)\,dxψ(x) = x なら平均、ψ(x) = x² なら分散の計算につながります。特定の範囲で 1、それ以外で 0 の関数を選べば、その範囲の確率です。この積分は、線形でない関数ではたいてい手で解けません。そこで、p から N 個のサンプルを引いて、ただの平均を取ります。
\mathrm{E}[\psi(x)] \approx \hat{\psi}_N = \frac{1}{N}\sum_{i=1}^{N} \psi\bigl(x^{(i)}\bigr)x^{(i)} の肩の (i) は i 番目のサンプルを表す番号で、べき乗ではありません。この近似の精度は、次の定理で決まります。
サンプルが互いに独立で、ψ(x) の分散 σψ² が有限なら、N を大きくしたとき、推定の誤差 ψ̂_N − E[ψ(x)] の分布は、平均 0、分散 σψ²/N のガウス分布に近づく。
分散だけなら、1 行で出せます。独立な N 個の和の分散は 1 個の分散の N 倍で、それを N で割ると N² 分の 1 になるからです。
\mathrm{Var}[\hat{\psi}_N] = \frac{1}{N^2}\cdot N\sigma_\psi^2 = \frac{\sigma_\psi^2}{N}誤差の RMS(2 乗平均の平方根)は \sigma_\psi/\sqrt{N} です。N を 100 倍にして、誤差がやっと 1/10 になります。 この 1/√N は x の次元の数を含みません。格子の上で数値積分すると、次元が増えるにつれて格子点が指数で増えますが、モンテカルロ積分の式に次元は現れません。これがサンプルで持つ理由です。ただし、次元が定数 σψ を通じて効いてくる話は、後の章で扱います。
重要度サンプリング
モンテカルロ積分には弱点があります。p からサンプルを引けないと使えないのです。事後分布は、まさに知りたい分布で、そこから直接は引けません。
そこで、引きやすい別の分布 q から引いて、差を重みで補正します。式の変形は、p/q を掛けて q で割るだけです。
\begin{aligned} \mathrm{E}_p[\psi(x)] &= \int \psi(x)\,\frac{p(x)}{q(x)}\,q(x)\,dx \\ &\approx \frac{1}{N}\sum_{i=1}^{N} \psi\bigl(x^{(i)}\bigr)\,\frac{p\bigl(x^{(i)}\bigr)}{q\bigl(x^{(i)}\bigr)} \end{aligned}2 行目のサンプルは q から引きます。これが重要度サンプリング(importance sampling)で、q を提案分布と呼びます。比 p/q が、そのサンプルの重みです。p が濃いのに q が薄い場所のサンプルは大きく数え、逆は小さく数えます。
q から引いた和の期待値は、1 行目の積分そのものなので、この推定は不偏です(期待値が真の値に等しいこと)。q(x) が 0 の場所に p の確率があると成り立たないので、q は p より広く取ります。
事後分布は、たいてい定数倍が分かりません(ベイズの定理の比例の記号 ∝ の部分です)。そこで、重みの和が 1 になるように割って使います。
\begin{gathered} \tilde{W}^{(i)} = \frac{p\bigl(x^{(i)}\bigr)}{q\bigl(x^{(i)}\bigr)},\quad W^{(i)} = \frac{\tilde{W}^{(i)}}{\sum_{j=1}^{N} \tilde{W}^{(j)}} \\ \mathrm{E}_p[\psi(x)] \approx \sum_{i=1}^{N} W^{(i)}\,\psi\bigl(x^{(i)}\bigr) \end{gathered}割り算を入れたので厳密な不偏ではなくなりますが、ずれは N が大きいと消えます。記号は次のとおりです。
| 記号 | 意味 | 備考 |
|---|---|---|
| N | 粒子(サンプル)の数 | #6 の状態の数とは別 |
| d | 状態の数(次元) | #6 の N に当たる |
| x⁽ⁱ⁾ | i 番目の粒子 | 肩の (i) は番号 |
| W̃⁽ⁱ⁾ | 正規化する前の重み | p/q |
| W⁽ⁱ⁾ | i 番目の粒子の重み | 和は 1。#6 のシグマ点の重みと同じ「代表点の重み」 |
| p(x) | 狙う分布 | |
| q(x) | 提案分布 | #5 の連続時間ノイズ強度 q とは別物 |
| ψ(x) | 期待値を取りたい関数 | |
| ψ̂_N | N 個で計算した推定値 | |
| σψ² | ψ(x) の分散 | |
| w[n] | プロセスノイズ | 重みと混ざらないよう、重みに小文字 w を使わない |
q の選び方で定数が変わる
重要度サンプリングでも誤差は 1/√N で減りますが、定数は q で変わります。式で見ておきます。p と q がどちらも分散 1 のガウス分布で、平均が μ だけ離れているとします。重みの 2 乗の平均を計算すると、次の値になります。
\mathrm{E}_q\!\left[\left(\frac{p}{q}\right)^{\!2}\right] = e^{\mu^2}この値が 1 なら重みはすべて同じで、大きいほど重みがばらつきます。後で定義する有効サンプル数で言うと、N 個のサンプルが実質 N e^{-\mu^2} 個に減ります。μ = 2 なら e⁻⁴ で、実質 1.8 % です。
次の図は、左がモンテカルロ積分の誤差、中と右が重要度サンプリングです。右の図で、2 本の線の傾きが同じで、高さが違うことを見てください。
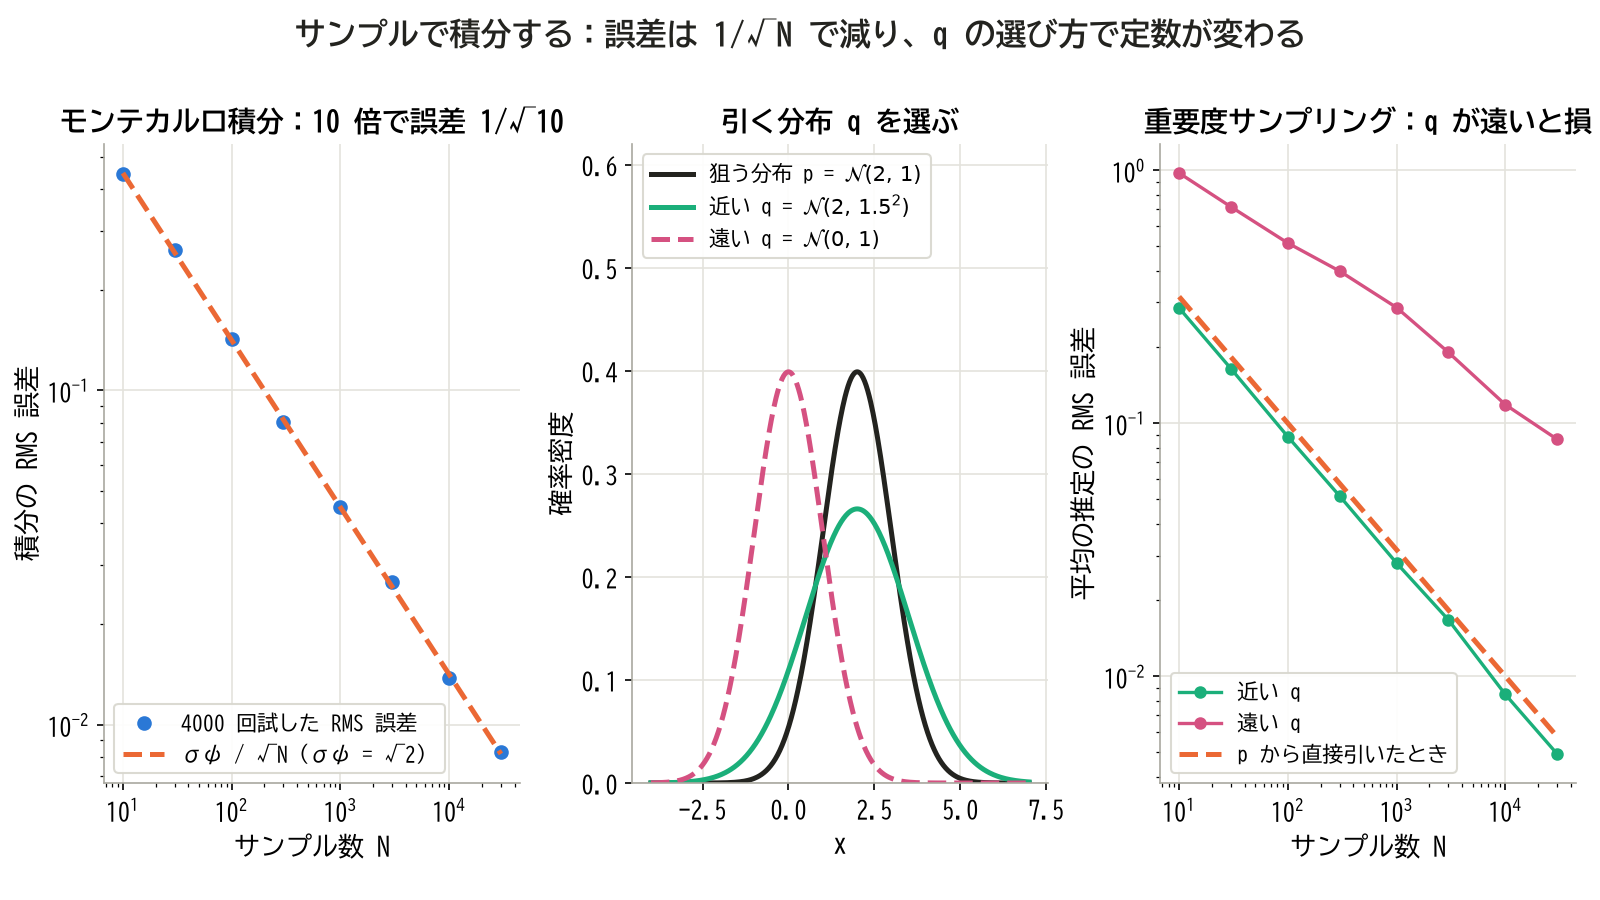
左:E[x²] の RMS 誤差は理論の 1/√N に乗る。右:遠い q は同じ N でも誤差が 10 倍ほど大きい
左の図は 4000 回試した RMS 誤差で、N = 1000 で 0.0447、理論値 √(2/1000) も 0.0447 です。右の図の N = 1000 では、遠い q の誤差が 0.29、近い q の誤差が 0.028 です。近い q は、p から直接引いたときの 0.032 より少し小さくなっています。p より広い q は、平均の計算には有利なことがあるのです。提案分布は「p に近い」だけでなく「狙う量に合っている」ことが大事です。
この 2 つの式で、サンプルで積分する道具はそろいました。次の章では、これを時間方向に積み上げます。
🧮 逐次重要度サンプリング(SIS)の導出
カルマンフィルタと同じように、測定が来るたびに分布を更新したいわけです。毎回 N 個を引き直すのではなく、前の粒子を使い回して重みだけ更新する形に変形します。これを逐次重要度サンプリング(Sequential Importance Sampling、SIS)と呼びます。
ベイズフィルタの再帰
#5 で更新の式を出すときに使った、ベイズの定理に戻ります。 y[1{:}n] は 1 番目から n 番目までの測定の全部を表します。分布の再帰は、予測と更新の 2 本です。
\begin{aligned} &p(x[n] \mid y[1{:}n-1]) \\ &\quad = \int p(x[n] \mid x[n-1]) \\ &\qquad \times p(x[n-1] \mid y[1{:}n-1]) \\ &\qquad dx[n-1] \end{aligned} \begin{aligned} &p(x[n] \mid y[1{:}n]) \\ &\quad \propto p(y[n] \mid x[n])\,p(x[n] \mid y[1{:}n-1]) \end{aligned}1 本目は「前の分布を状態方程式で 1 歩進める」、2 本目は「尤度を掛ける」という意味です。 p(x[n] \mid x[n-1]) は状態遷移の確率で、#6 の式なら平均 f(x[n−1])、共分散 Q の分布です。 p(y[n] \mid x[n]) が尤度です。
これがベイズフィルタで、推定の理論上の正解です。線形でガウス分布なら、両方の積分が閉じて #5 の 5 本の式になります。EKF と UKF は、この積分をガウス近似で解いたものです。パーティクルフィルタは、同じ積分をサンプルで解きます。
経路の分布を分ける
重要度サンプリングを当てるのは、状態の経路 x[0{:}n] (時刻 0 から n までの状態の列)の分布です。ベイズの定理と、状態が 1 つ前だけで決まること、測定がその時刻の状態だけで決まることを使うと、経路の分布は次のように分けられます。
\begin{aligned} &p(x[0{:}n] \mid y[1{:}n]) \\ &\quad \propto p(y[n] \mid x[n])\,p(x[n] \mid x[n-1]) \\ &\qquad \times p(x[0{:}n-1] \mid y[1{:}n-1]) \end{aligned}提案分布も同じ形に作ります。「これまでの経路はそのまま残し、新しい点だけを足す」という意味です。
\begin{aligned} &q(x[0{:}n] \mid y[1{:}n]) \\ &\quad = q(x[n] \mid x[n-1],\,y[n]) \\ &\qquad \times q(x[0{:}n-1] \mid y[1{:}n-1]) \end{aligned}重みの再帰
重みは p/q でした。上の 2 つの式の比を取ると、最後の因子どうしの比が、1 つ前の時刻の重みそのものになります。
各時刻でやることは 2 つです。粒子ごとに q から新しい点を 1 個引き、この式で重みを更新します。最後に全粒子の和が 1 になるよう割ります。これで、事後分布は次の和で表されます。
\begin{aligned} &p(x[n] \mid y[1{:}n]) \\ &\quad \approx \sum_{i=1}^{N} W^{(i)}[n]\;\delta\bigl(x[n] - x^{(i)}[n]\bigr) \end{aligned}δ はデルタ関数で、その 1 点にだけ面積 1 が集中した関数です。つまり「分布を、重み付きの点の集まりで置き換える」という式です。この和に ψ を掛けて積分すると、前の章の重み付き平均に戻ります。
| 記号 | 意味 | 備考 |
|---|---|---|
| x⁽ⁱ⁾[n] | 時刻 n の i 番目の粒子 | d × 1 |
| W⁽ⁱ⁾[n] | 時刻 n の i 番目の重み | 和は 1 |
| y[1:n] | 1〜n 番目の測定の全部 | |
| p(y[n] | x[n]) | 尤度 | 定数倍は不要 |
| p(x[n] | x[n−1]) | 状態遷移の確率 | f と Q から決まる |
| q(x[n] | x[n−1], y[n]) | 提案分布 | 選べる |
| δ | デルタ関数 | 1 点に集中した分布 |
ブートストラップ:提案分布を状態遷移にする
q は自由に選べます。いちばん単純な選び方は、状態遷移そのものを提案分布にすることです。
\begin{aligned} &q\bigl(x[n] \mid x[n-1],\,y[n]\bigr) \\ &\quad = p\bigl(x[n] \mid x[n-1]\bigr) \end{aligned}すると、重みの再帰の分子と分母で状態遷移の確率が消えて、尤度だけが残ります。
W^{(i)}[n] \propto W^{(i)}[n-1]\;p\bigl(y[n] \mid x^{(i)}[n]\bigr)粒子を進める操作は「f に通して乱数を足す」だけで、重みの更新は「尤度を掛ける」だけです。Q の行列も、その逆行列も、確率密度の値も要りません。これがブートストラップフィルタが広く使われる理由です。#6 の形で測定ノイズがガウス分布なら、イノベーション ν(測定と予測の差)を使って、掛ける値は次のとおりです。
\begin{gathered} p\bigl(y \mid x^{(i)}\bigr) \propto \exp\!\left(-\tfrac{1}{2}\,{\nu^{(i)}}^{\mathsf{T}} R^{-1} \nu^{(i)}\right) \\ \nu^{(i)} = y - h\bigl(x^{(i)}\bigr) \end{gathered}代わりに、q が測定を見ていません。粒子は測定を知らずに散らばり、当たった粒子の重みが増えるのを待つだけです。測定が精密なときに起きる問題は、後の章で調べます。
重みの退化
SIS をそのまま回すと、必ず破綻します。Doucet、Godsill、Andrieu の 2000 年の論文に、次の命題があります。
測定も確率変数と見たとき、重要度の重みの分散は時間とともに増える(Doucet ら 2000、Proposition 1。Kong、Liu、Wong の定理の拡張)。
重みのばらつきは減らず、増える一方です。数ステップで 1 個の粒子に重みが集まり、残りの粒子の重みはほぼ 0 になります。これを重みの退化と呼びます。計算は N 個分しているのに、推定に効いているのは 1 個だけという状態です。
退化の度合いは、有効サンプル数で測ります。Kong、Liu、Wong の 1994 年の論文の考え方で、重みのばらつきを「実質何個のサンプルに相当するか」に換算します。定義と、計算に使う式は次のとおりです。
\begin{gathered} N_{\mathrm{eff}} = \frac{N}{1 + \mathrm{CV}^2} \\ \widehat{N}_{\mathrm{eff}} = \frac{1}{\sum_{i=1}^{N}\bigl(W^{(i)}\bigr)^2} \end{gathered}CV は重みの標準偏差を平均で割った変動係数です。重みの和が 1 のとき、重みの平均は 1/N なので 1 + \mathrm{CV}^2 = N\sum_i (W^{(i)})^2 となり、左の式から右の式が出ます。
| 記号 | 意味 | 備考 |
|---|---|---|
| N_eff | 有効サンプル数 | 1 以上 N 以下 |
| CV | 重みの変動係数 | 標準偏差 ÷ 平均 |
重みがすべて 1/N なら N_eff = N、1 個に全部集まれば N_eff = 1 です。
例で見ます。x[n+1] = x[n] + w、y[n] = x[n] + v、Q = R = 1 の 1 次元の対象に、N = 1000 のブートストラップを回します。比べるのは、重みをそのまま掛け続ける SIS(オレンジ)と、N_eff が N/2 を切ったら次の章のリサンプリングをする場合(青)です。左の図の最大の重みと、中の図の N_eff の落ち方を見てください。
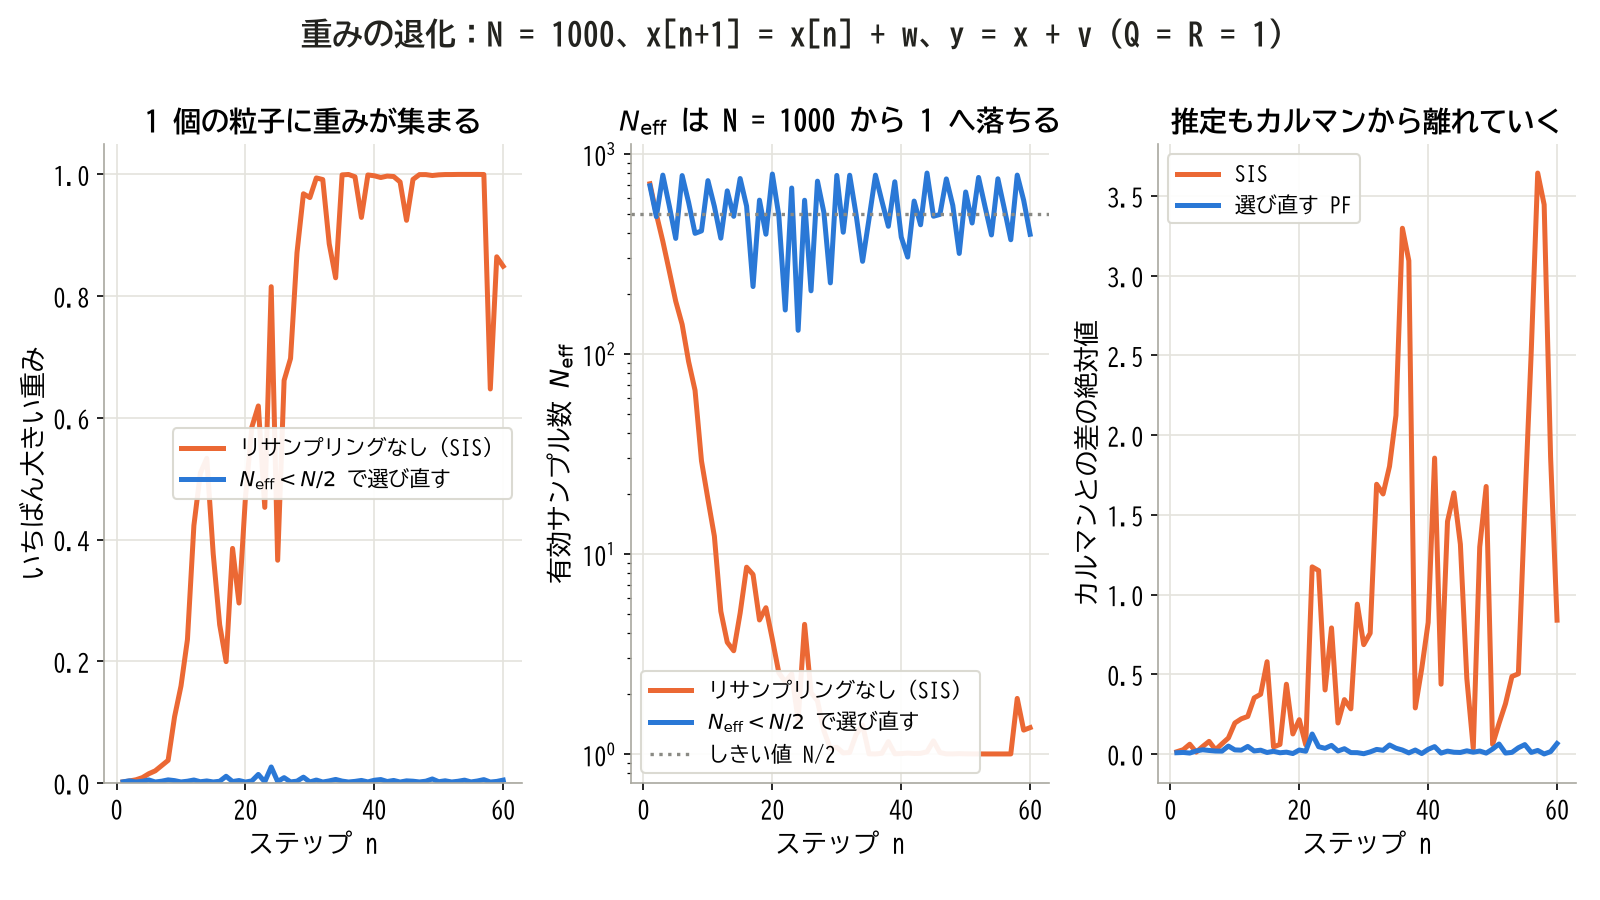
左、中:SIS の N_eff は 10 ステップで 19、20 ステップで 3.7 まで落ちる。右:重みが 1 個に集まると、推定はカルマンの厳密解から離れていく
N = 1000 で始めたのに、SIS の N_eff は 10 ステップで 19、20 ステップで 3.7、60 ステップで 1.4 です。この対象の厳密解であるカルマンフィルタとの差の RMS は、後半の 30 ステップで 1.7 になります。リサンプリングを入れると、60 ステップの全体で差の RMS は 0.03 です。
重みの再帰だけでは足りないことが分かりました。次の章では、偏った重みを粒子の数に変換し直します。
🔁 リサンプリング
リサンプリングは、重み付きの粒子の集まりから、重みに比例した確率で N 個を選び直し、重みをすべて 1/N に戻す操作です。重みの大きい粒子は複製され、重みの小さい粒子は消えます。
なぜ要るのか
退化の問題は、重みの小さい粒子に計算を使い続けることでした。リサンプリングは、確率の低い仮説を捨てて、確率の高い場所の周りに粒子を集め直します。選び直した直後の分布は、期待値で見ると、選び直す前と同じ分布を表します。粒子 i が選ばれる個数の期待値が N W^{(i)} なので、複製された粒子の平均は重み付き平均に一致するからです。
複製された粒子は同じ値ですが、次の予測で別々の乱数が足されて散らばります。これで分布が保たれます。
なぜ毎回はよくないのか
リサンプリングには、2 つの代償があります。
- 推定に乱数の揺らぎを足す:重み付き平均は分布をそのまま使いますが、選び直すと、選び方の乱数の分だけ揺らぐ
- 粒子の種類が減る:複製で同じ値の粒子が増え、消えた仮説は戻らない。これをサンプル貧困化(sample impoverishment)と呼ぶ
そこで、N_eff がしきい値 N_T を下回ったときだけ選び直します。この記事では N_T = N/2 とします。
4 つの方式
N 個の整数を選ぶ方法は、重みの累積和(1 番目からの和)を階段として描くと、まとめて説明できます。0〜1 の値 u を横線として階段に当てて、その高さの段の粒子を選びます。方式の違いは、u の作り方だけです。
- 多項リサンプリング:u を N 個、独立に一様乱数で作る。もっとも素直
- 層化リサンプリング:0〜1 を N 等分し、各区間から u を 1 個ずつ引く
- 系統リサンプリング:一様乱数 U を 1 個だけ引いて、U、U + 1/N、U + 2/N… と等間隔に置く
- 残差リサンプリング:まず \lfloor N W^{(i)} \rfloor 個(記号は切り捨て)を確定で複製し、残りの枠だけを乱数で選ぶ
手計算の章で使う 5 個の重みで、4 つの方式を描いたのが次の図です。青の階段が累積和、オレンジの点が選ばれた粒子です。左から 3 つの図で、横線の間隔の違いを見てください。多項は片寄り、層化と系統は均等に並びます。
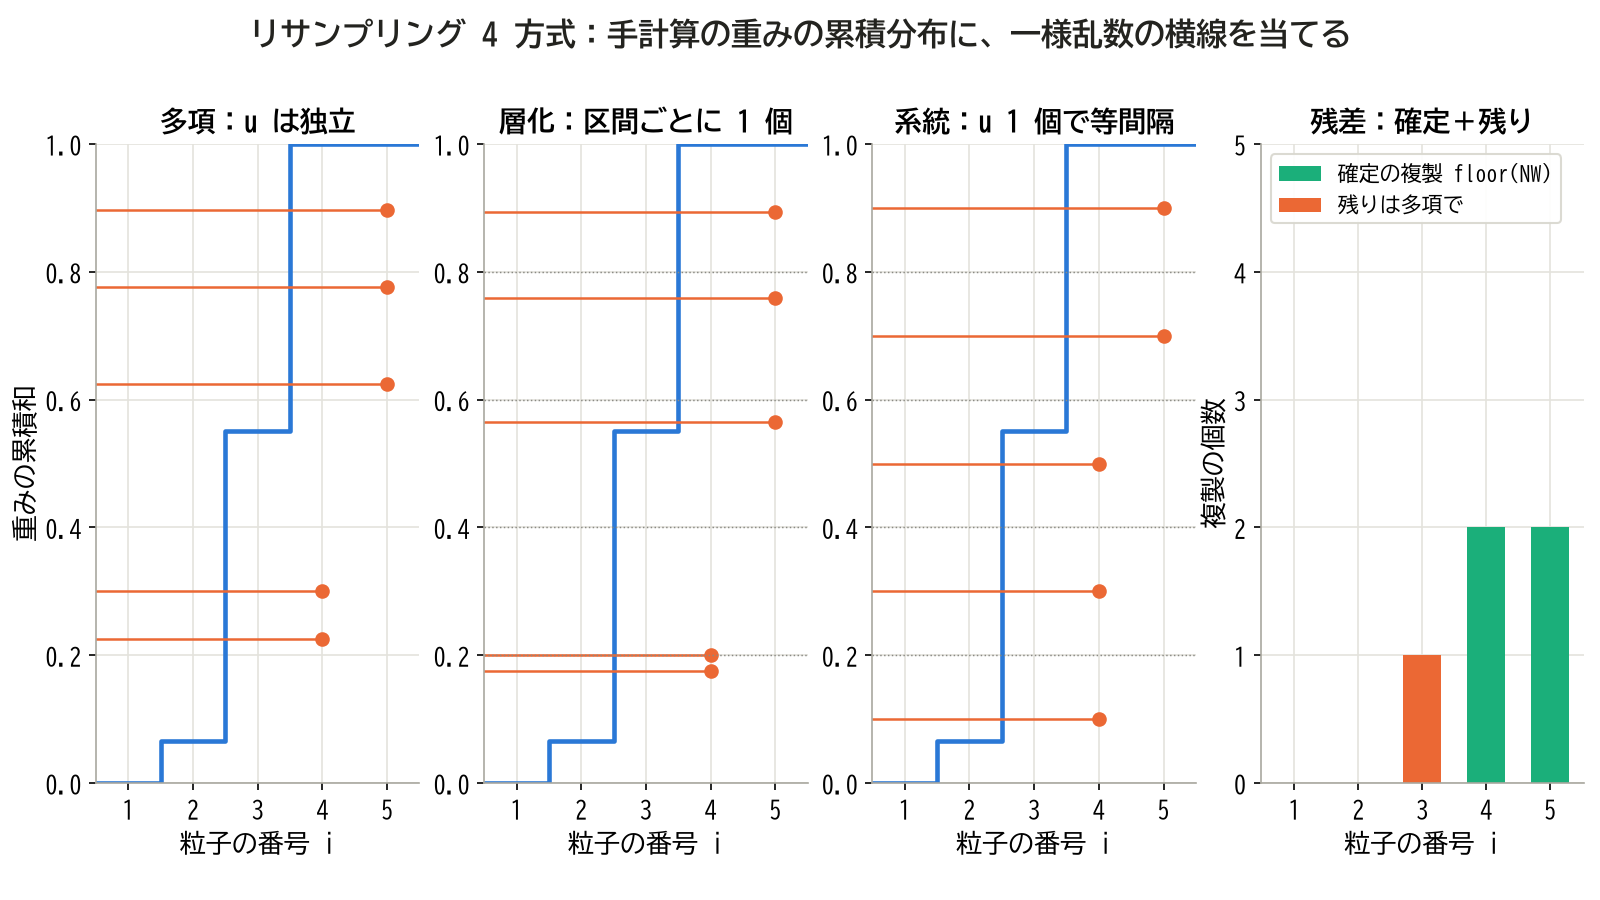
多項:横線は片寄る。層化:区間ごとに 1 本。系統:等間隔で、乱数は 1 個だけ。残差:4、5 番目の粒子を確定で 2 個ずつ複製し、残り 1 枠を乱数で選ぶ
どの方式でも、粒子 i が選ばれる個数の期待値は N W^{(i)} です。違いは揺らぎの大きさと計算量です。リサンプリング後の平均の分散を、乱数で 4 万回試して測りました。重みは N = 100 の粒子に付けて、3 通りの並びで比べています。
| 方式 | 値の順に並べる | ばらばらの順 | 2 値の交互 |
|---|---|---|---|
| 多項 | 2.18×10⁻³ | 2.17×10⁻³ | 1.86×10⁻³ |
| 層化 | 6.8×10⁻⁶ | 1.07×10⁻³ | 1.26×10⁻³ |
| 系統 | 7.9×10⁻⁵ | 4.3×10⁻⁴ | 6.25×10⁻² |
| 残差 | 1.43×10⁻³ | 1.43×10⁻³ | 1.25×10⁻³ |
いちばん右の「2 値の交互」は、Douc、Cappé、Moulines の 2005 年の論文に出てくる反例です。2 種類の値が交互に並び、片方の重みの合計が 0.75 のときです。論文の式の値は多項 1.875×10⁻³、層化と残差 1.25×10⁻³、系統 6.25×10⁻² で、数値と一致します。系統だけが 30 倍以上悪く、しかも N を増やしても減りません。
この表から、次のことが言えます。
- 層化と残差は多項より悪くならない:どんな重みでも条件付き分散が多項以下になることが、Douc らの論文で示されている
- 系統は、そうとは言い切れない:ふつうの場面では表のように小さい。Douc らも、並びをばらばらにすれば反例はほぼ消えること、実用上は 3 方式が同程度であること、実装の単純さから系統がよく選ばれることを書いている
- 層化と系統は並びの順に左右される:Douc らの指摘どおりで、表の 1 列目と 2 列目の差がそれに当たる。残差は順序に左右されない
Hol、Schön、Gustafsson の 2006 年の比較は、品質と計算量の両方で層化と系統を多項より有利とし、一様に並ぶ度合いの点では系統が理論上いちばん良いと結論しています。系統の分散の解析は、粒子が互いに独立でないので難しく、同じ論文も分散の結果としては示していません。この記事は、計算量が O(N)(N に比例)で乱数が 1 個で済む系統リサンプリングを使います。
系統リサンプリングの手順
1 段ずつ書きます。累積和を 1 回なぞるだけで、ループの総回数は 2N 回以下です。
- 一様乱数 U を 0〜1/N の範囲で 1 個引く
- 累積和を W⁽¹⁾、番号 j を 1、値 u を U と置く
- i = 1〜N について、次を繰り返す
- 累積和が u より小さい間、j を 1 増やして累積和に W⁽ʲ⁾ を足す
- 新しい粒子 i に、古い粒子 j の値をコピーする
- u に 1/N を足す
- 重みをすべて 1/N に戻す
手計算で 1 周回す
#5、#6 と同じ趣旨で、1 ステップを手で回します。対象は x[n+1] = x[n] + w、y[n] = x[n] + v の 1 次元で、R = 0.25 です。N = 5 の粒子を用意し、乱数も与えてしまいます。
① 予測。 重みはすべて 0.2 です。粒子に、引いた乱数 w を足します。
| i | 前の x⁽ⁱ⁾ | 乱数 w | 予測の x⁽ⁱ⁾ |
|---|---|---|---|
| 1 | −1.2 | +0.2 | −1.0 |
| 2 | −0.4 | −0.3 | −0.7 |
| 3 | 0.3 | +0.1 | 0.4 |
| 4 | 1.0 | +0.4 | 1.4 |
| 5 | 1.8 | −0.2 | 1.6 |
② 尤度。 測定 y = 1.4 が来ました。重みはすべて同じなので、重みの比は尤度の比です。ν = y − x として、 \exp(-\nu^2/(2R)) = \exp(-2\nu^2) を計算します。
| i | ν | −2ν² | 尤度 |
|---|---|---|---|
| 1 | 2.4 | −11.52 | 0.00001 |
| 2 | 2.1 | −8.82 | 0.00015 |
| 3 | 1.0 | −2.00 | 0.13534 |
| 4 | 0.0 | 0.00 | 1.00000 |
| 5 | −0.2 | −0.08 | 0.92312 |
③ 正規化。 尤度の和は 2.05861 です。各尤度をこれで割り、累積和も並べます。
| i | 重み W⁽ⁱ⁾ | 累積和 |
|---|---|---|
| 1 | 0.000005 | 0.000005 |
| 2 | 0.000072 | 0.000077 |
| 3 | 0.065741 | 0.065818 |
| 4 | 0.485765 | 0.551583 |
| 5 | 0.448417 | 1.000000 |
④ 有効サンプル数と推定。 重みの 2 乗の和は 0.44137 なので、N_eff = 2.27 です。重み付きの平均と分散は次の値です。
\begin{gathered} \hat{x} = \sum_i W^{(i)} x^{(i)} = 1.4238 \\ \hat{P} = \sum_i W^{(i)} \bigl(x^{(i)} - \hat{x}\bigr)^2 = 0.0835 \end{gathered}⑤ リサンプリング。 N_eff = 2.27 はしきい値 N/2 = 2.5 より小さいので、選び直します。U = 0.1 とすると、u は 0.1、0.3、0.5、0.7、0.9 です。累積和の階段に当てると、0.1 と 0.3 と 0.5 は 4 番の段(0.0658〜0.5516)、0.7 と 0.9 は 5 番の段に入ります。
新しい粒子は 1.4、1.4、1.4、1.6、1.6 で、重みはすべて 0.2 です。この 5 個の平均は 1.48、分散は 0.0096 になります。推定値は、④ の 1.4238 を使います。リサンプリングの前の値のほうが揺らぎが少ないからです。
この 1 周を描いたのが次の図です。上から順に、点が動き、棒の高さが変わり、棒の本数が減る様子を見てください。
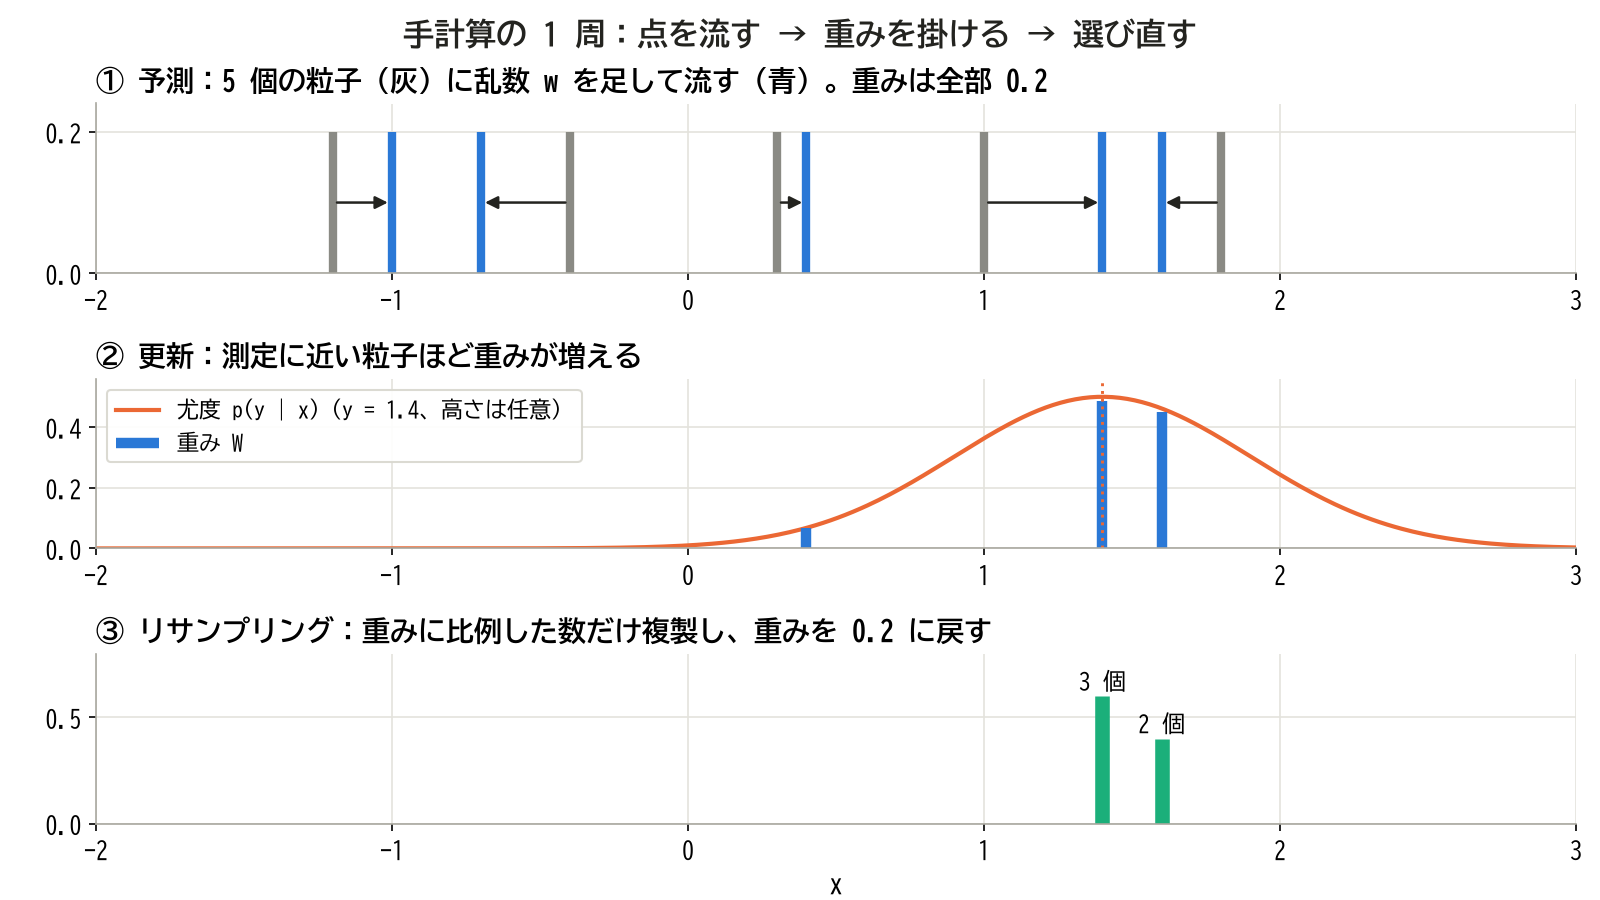
① 点を流す ② 測定に近い 2 個の重みが増える ③ 重みに比例して複製し、測定から遠い 3 個は消える
上の数字は、後の実装の章の Python のコード(systematic(W, rng, u=0.1) など)の出力と一致します。粒子が 5 個しかないので、1 周で値の種類が 2 つに減りました。実際の N はもっと大きく、次の予測で乱数が足されるので、また散らばります。
これで 1 周の中身がそろいました。線形の対象にかければカルマンフィルタと同じ答えが返るはずです。次の章で、その検算をします。
📊 周波数と制御工学の道具で見る
#5 と #6 では、定常状態のゲインや動作点を伝達関数で読みました。パーティクルフィルタには、そのままでは伝達関数がありません。リサンプリングという乱数の操作が入るので、線形の式で書けないからです。
ただし、線形でガウス分布の対象なら、厳密なベイズフィルタはカルマンフィルタです。パーティクルフィルタがベイズフィルタの近似なら、N を増やすとカルマンフィルタの答えに一致するはずで、それは伝達関数 H(z) でも確かめられるはずです。これが、この記事でもっとも強い検算です。
収束の定理
理論の裏付けから書きます。粒子は重み付けとリサンプリングで互いに影響し合うので、独立なサンプルを前提にした中心極限定理は、そのままでは使えません。この場合の結果は Crisan と Doucet の 2002 年の解説にまとまっています。
適当な条件のもとで、値が一定の範囲に収まる(有界な)関数 ψ について、パーティクルフィルタの推定の平均 2 乗誤差は、N に依らない定数 c[n] を使って次で抑えられる。
\begin{gathered} \bar{\psi}[n] = \mathrm{E}\bigl[\psi(x[n]) \mid y[1{:}n]\bigr] \\ \mathrm{E}\Bigl[\bigl(\hat{\psi}_N[n] - \bar{\psi}[n]\bigr)^2\Bigr] \le \frac{c[n]\,\|\psi\|^2}{N} \end{gathered}‖ψ‖ は ψ の絶対値の最大値です。N を増やせば誤差は 1/N で減る、つまり RMS は 1/√N で減ります。ただし、定数 c[n] は対象と時刻で決まります。時間が進んでも c[n] が増えないことを言うには、対象に強い条件が要ります。この定理は「いつかは収束する」ことを言うだけで、「この N で足りる」とは言いません。足りるかどうかは、後の章の検証で確かめます。
カルマンに戻せるかを確かめる
#5 の等速モデルをそのまま使います。T = 1、 \sigma_a = \sigma_v = 1 で、定常ゲインは K_\infty = [\,0.75\ \ 0.5\,] でした。同じ測定の列に、#5 のカルマンフィルタとパーティクルフィルタをかけ、100 回の平均を取ります(200 ステップのうち最初の 50 ステップを除く)。
| 方式 | 位置の RMSE(誤差の RMS) | カルマンとの差の RMS | 差 × √N |
|---|---|---|---|
| カルマン | 0.8608 | — | — |
| PF N = 100 | 0.9044 | 0.2704 | 2.70 |
| PF N = 1000 | 0.8639 | 0.0655 | 2.07 |
| PF N = 10000 | 0.8612 | 0.0202 | 2.02 |
カルマンとの差に √N を掛けた右の列が、N を増やすと一定の値に落ち着きます。これが 1/√N の線に乗るということです。N = 100 だけ少し大きいのは、N が小さいと 1/N の項より高い次数の影響が残るからです。
RMSE も確かめられます。カルマンフィルタは最小分散の推定なので、誤差とカルマンからの差は直交し、2 乗が足し算になるはずです。0.8608² + 0.2704² = 0.814 で、N = 100 の 0.9044² = 0.818 と合います。
次の図の中央は、白色ノイズ(どの周波数も同じ強さのノイズ)を測定として入れて、入力と出力のクロススペクトル(2 つの信号の周波数ごとの相関)から周波数応答を推定したものです。#1 の Welch 法(信号を区間に分けてスペクトルを平均する方法)と同じ流儀で、窓はハン窓、1 区間 1024 点、50 % オーバーラップです。太い線が #5 の H(z) です。
H(z) = \frac{0.75 - 0.25\,z^{-1}}{1 - 0.75\,z^{-1} + 0.25\,z^{-2}}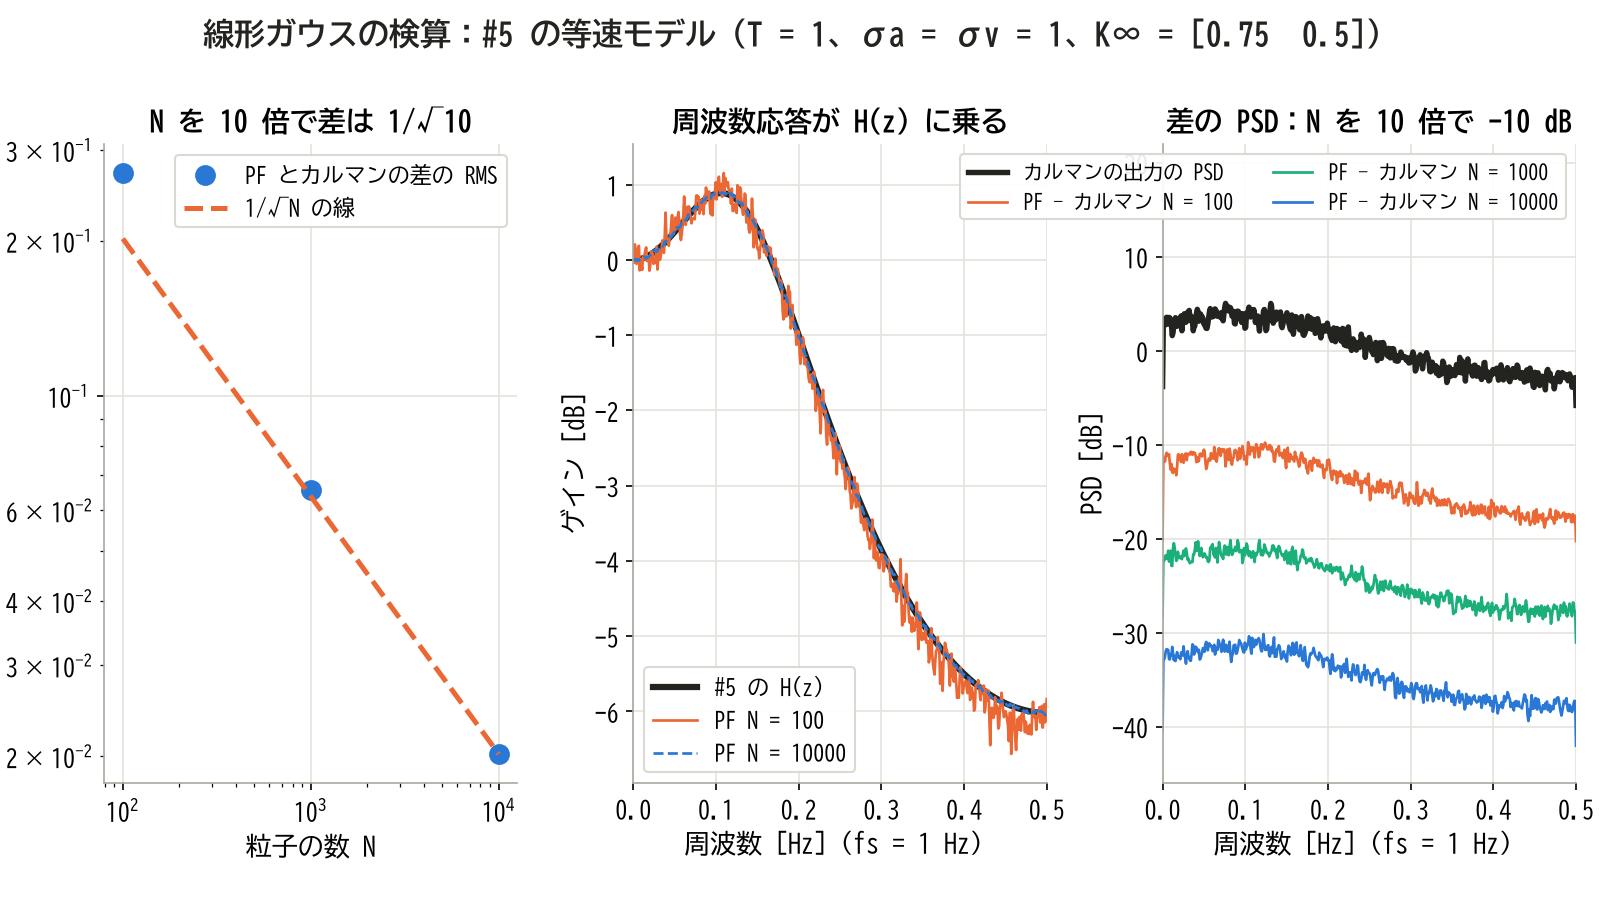
左:差は 1/√N で減る。中:N = 10000 は H(z) に完全に重なり、N = 100 はそのまわりで揺れる。右:差の PSD は N を 10 倍にするごとに 10 dB 下がる
見るのは中央の図です。リサンプリングの入った非線形の処理なのに、周波数応答が H(z) に乗っています。H(z) との差の RMS は、N = 100 で 0.18 dB、N = 10000 で 0.014 dB でした。
右の図は、PF の出力からカルマンの出力を引いた差の PSD(パワースペクトル密度)です。これがモンテカルロの揺らぎで、推定に残るノイズの床に当たります。中央値は N = 100 で −14.2 dB、N = 1000 で −24.6 dB、N = 10000 で −34.5 dB と、N を 10 倍で 10 dB 下がりました。1/N の定理そのものです。この床より下の信号は、粒子の数を増やさないと見えません。
線の形が平らでなく、カルマンの出力に似ていることにも注目してください。リサンプリングで入った揺らぎも、そのあとフィルタの中を回るので、ループの伝達特性で形が付きます。
パーティクルフィルタは、線形の対象ではカルマンフィルタに戻ることが確かめられました。線形の対象ならカルマンのほうが軽くて厳密なので、PF を使う理由はありません。使う理由があるのは、次の章のように分布が崩れる対象です。ただし、その前に、粒子が足りなくなる条件を調べます。
🧪 粒子が足りなくなる条件
#6 には「曲率 × 分散」という、線形化が破れる条件がありました。パーティクルフィルタの対応する問いは、N 個の粒子で分布を覆えなくなるのはいつかです。条件は 3 つあります。どれも、尤度が強い場所に粒子がいない、という同じ現象の別の顔です。
条件 1:状態の次元が高い
d 次元の状態の各成分が互いに独立で、平均 0、分散 1 のガウス分布に従い、測定も各成分を分散 1 のノイズで直接測るとします。#5 の線形ガウスの、もっとも簡単な対象です。粒子を事前分布から N 個引き、1 回だけ更新します。
次の図の左は、N を増やしたときの最大の重みの平均です。右は、最大の重みの平均が 0.1 を切るのに必要な N です。左の図で、線が次元ごとに右へずれていくことを見てください。
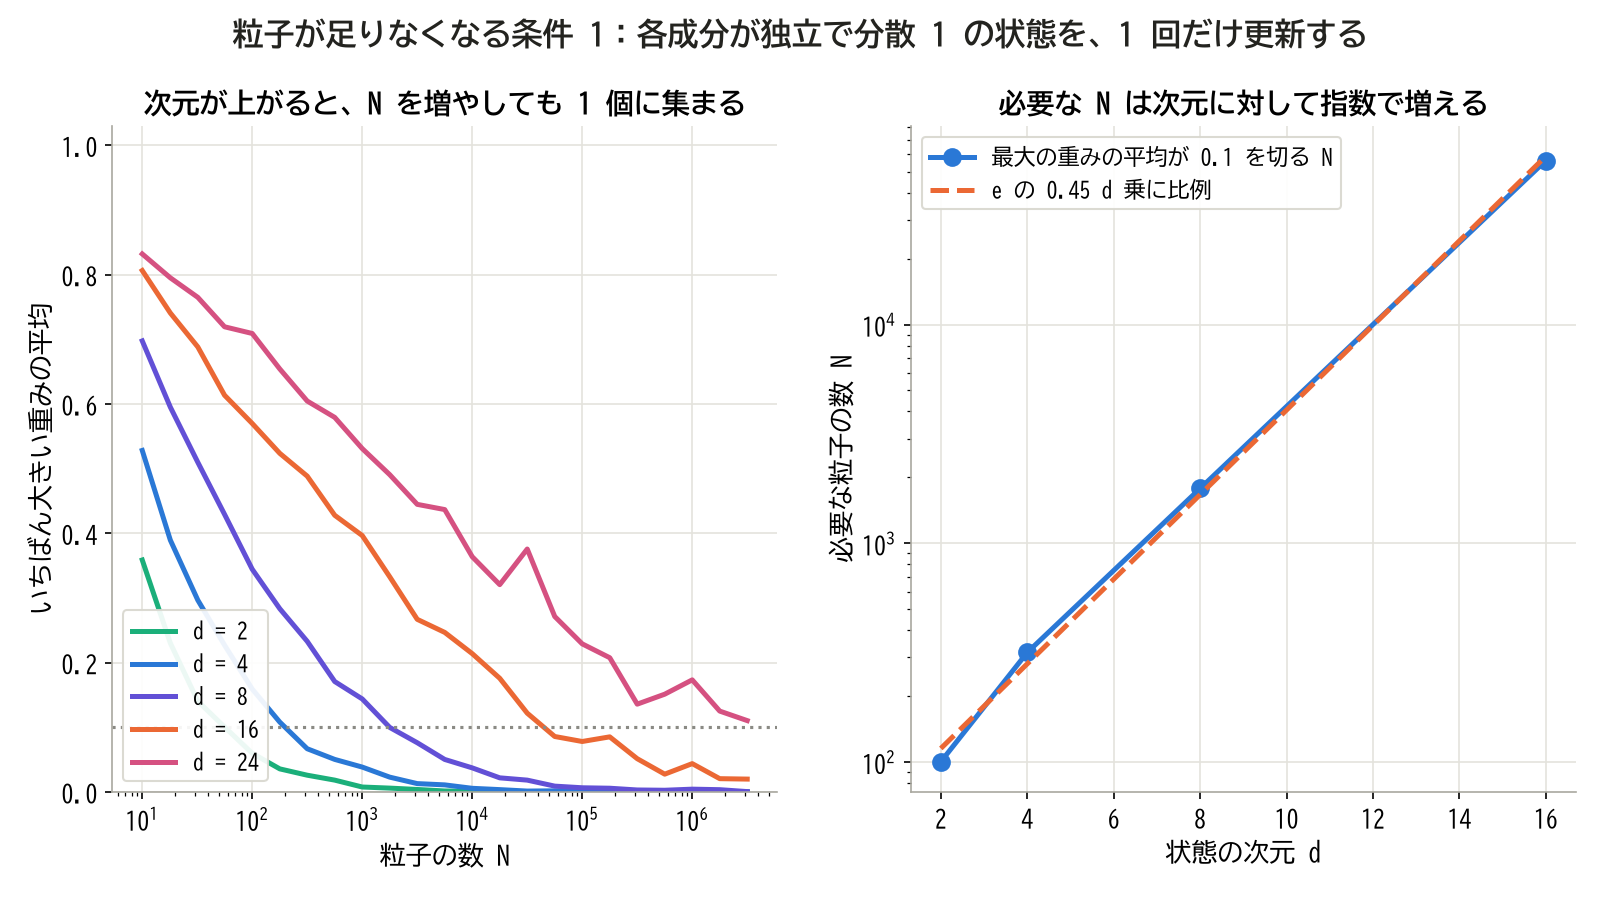
左:d = 24 では 300 万個でも最大の重みが 0.1 を切らない。右:必要な N は片対数の図で直線、つまり次元に対して指数で増える
数値は次の表のとおりです。
| 次元 d | N = 1000 の最大の重み | 最大の重みが 0.1 を切る N |
|---|---|---|
| 2 | 0.008 | 約 100 |
| 4 | 0.039 | 約 320 |
| 8 | 0.144 | 約 1800 |
| 16 | 0.397 | 約 5.6 万 |
| 24 | 0.531 | 300 万でも届かず |
必要な N は、d が 1 増えるごとにおよそ 1.6 倍(e の 0.45 乗)になります。カルマンフィルタなら一瞬で解ける線形の対象で、16 次元で 5 万個以上です。これが次元の呪いです。モンテカルロ積分の式に次元は入っていませんでしたが、定数の σψ が次元で増えるのです。
Snyder、Bengtsson、Bickel、Anderson の 2008 年の論文は、この現象を気象のデータ同化(観測で大規模な数値モデルを補正する計算)の文脈で調べました。同じ設定の 200 次元の例で、少なくとも 10¹¹ 個の粒子が要ると報告しています。そして、必要な粒子の数を決めるのは次元そのものではなく、観測の対数尤度の分散 τ² だと示しました。この例では τ² が測定の数に比例して増えるので、次元に対して指数で増えて見えます。τ² は上の例で 2.5d です(1 成分の分散が 1/2 + y² で、y² の平均が 2 だから)。
設計の見積もりとして使えます。1 回の更新で、対数尤度がどれだけばらつくかを計算すれば、粒子の足りなさが分かります。状態の次元が高くても、測定が少ない成分しか見ていなければ τ² は小さいのです。
条件 2:測定が精密すぎる
ブートストラップの提案分布は測定を見ません。プロセスノイズで広がった粒子の中に、測定で決まる狭い範囲に入るものがなければ、重みは退化します。
対象は x[n+1] = x[n] + w、y[n] = x[n] + v で、Q = 1 のまま R だけを小さくします。N = 100 です。比べるのは 3 つです。ブートストラップ、測定を見て粒子を動かす最適提案分布、そして Pitt と Shephard の補助粒子フィルタです。
最適提案分布は、「重みの分散を最小にする q」として Doucet らが示したもので、前の状態と今の測定の両方で条件を付けた分布です。
\begin{aligned} &q\bigl(x[n] \mid x[n-1],\,y[n]\bigr) \\ &\quad = p\bigl(x[n] \mid x[n-1],\,y[n]\bigr) \end{aligned}線形の測定とガウスのノイズなら、この分布は閉じた形で書けます。粒子 1 個ごとにカルマンの更新を 1 回するのと同じ式で、1 次元なら次のとおりです。
\begin{gathered} K = \frac{Q}{Q + R} \\ m = x' + K(y - x') \\ x^{(i)}[n] \sim \mathcal{N}\bigl(m,\ (1-K)Q\bigr) \\ W^{(i)}[n] \propto W^{(i)}[n-1] \\ \times \mathcal{N}\bigl(y;\ x',\ Q + R\bigr) \end{gathered}x′ は x^{(i)}[n-1] の略、m は提案分布の平均、 \mathcal{N}(y;\,x',\,Q+R) は平均 x′、分散 Q + R のガウス分布の y での値です。K は #5 のカルマンゲインと同じ形をしています。重みが新しい点ではなく前の点 x′ で決まるので、新しい点の乱数が重みを揺らしません。
補助粒子フィルタは、状態遷移の平均のような代表点で先に尤度を計算し、測定と合いそうな粒子を選んでから進める方法です。Pitt と Shephard は、SIR(ブートストラップと同じ形のフィルタ)が外れ値と鋭い尤度に弱いことを動機に挙げています。
結果が次の図です。右へ行くほど測定が精密です。左の図で、オレンジと紫の線が 1 から離れていく点を見てください。
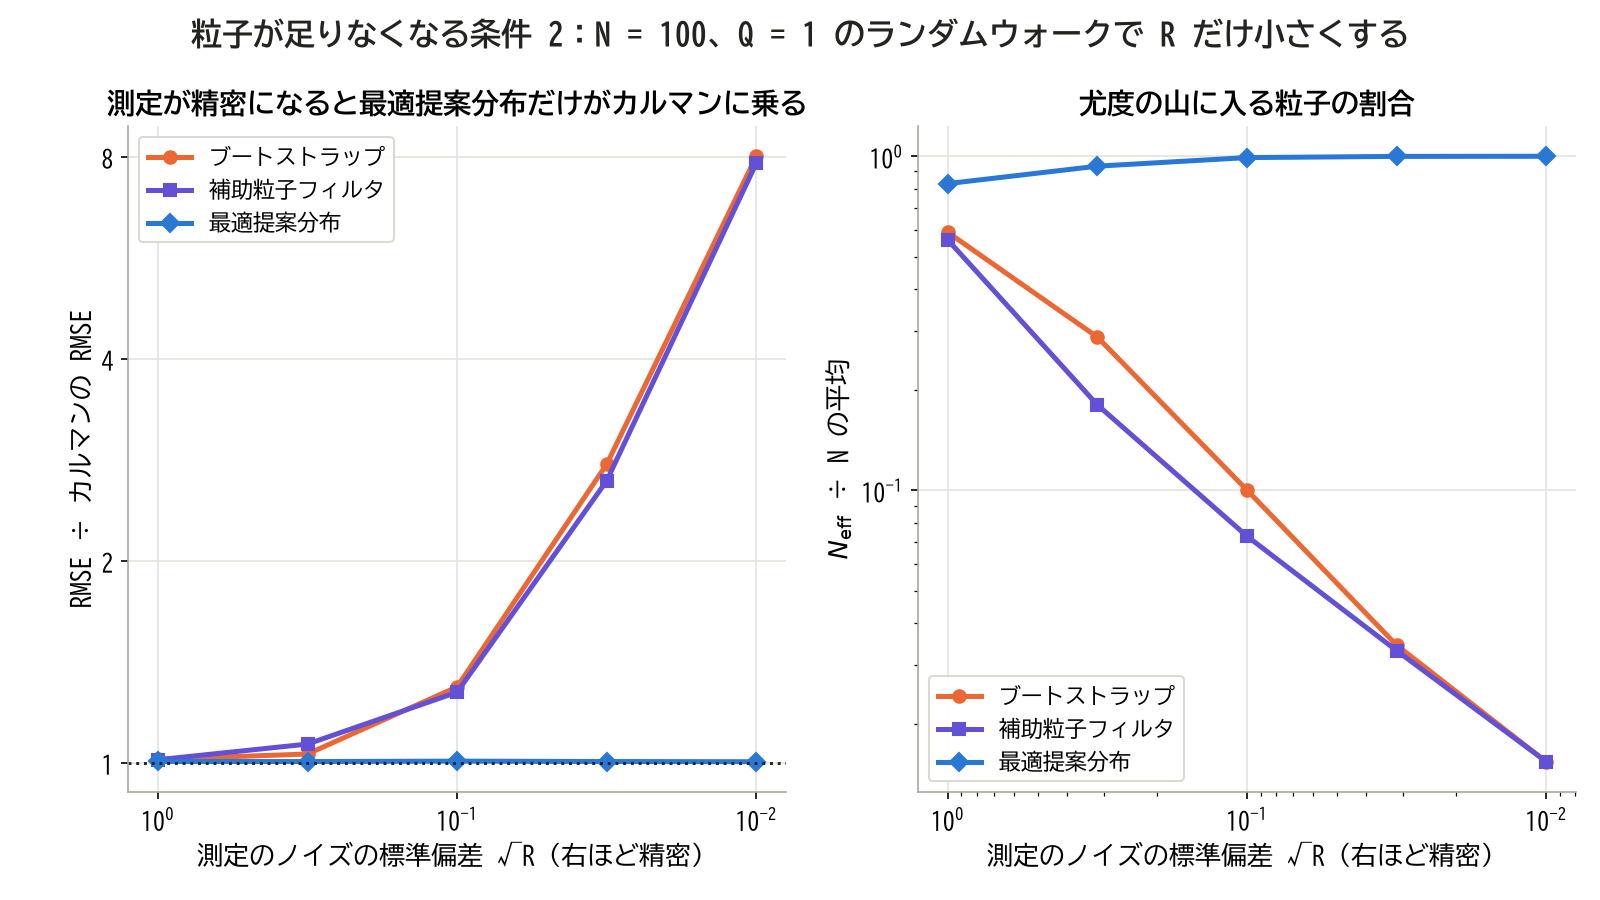
左:√R = 0.01 でブートストラップの RMSE はカルマンの 8 倍。最適提案分布は 1.005 倍のまま。右:ブートストラップの N_eff は N の 1.5 % まで落ちる
同じ結果を表にします。
| √R | ブートストラップ | 補助粒子フィルタ | 最適提案分布 |
|---|---|---|---|
| 1 | 1.01 倍 | 1.01 倍 | 1.01 倍 |
| 0.1 | 1.30 倍 | 1.28 倍 | 1.01 倍 |
| 0.03 | 2.79 倍 | 2.63 倍 | 1.01 倍 |
| 0.01 | 8.02 倍 | 7.84 倍 | 1.00 倍 |
値は RMSE をカルマンの RMSE で割ったものです。最適提案分布は √R = 0.01 でも N = 100 でカルマンに乗ったままです。
補助粒子フィルタは、この例ではほとんど効きませんでした。理由は対象にあります。先に選ぶときの代表点は前の粒子 x′ で、この対象は毎回乱数を足して動くので(ランダムウォークと呼びます)、x′ と次の x が √Q ほど離れます。測定の幅 0.01 に比べて遠すぎて、x′ の良し悪しが次の x の良し悪しを表さないのです。補助粒子フィルタが効くのは、1 ステップの動きが尤度の幅に比べて小さいときです。
線形の測定でないときは、最適提案分布は閉じません。その場合は、粒子ごとに EKF や UKF の更新を 1 回かけて提案分布にする方法があります。Doucet らの論文の、局所的に線形化した提案分布がこれに当たります。
条件 3:動かない状態
パラメータのように時間で変わらない状態(Q = 0)は、予測で粒子が散らばりません。リサンプリングのたびに値の種類が減り、増えることはないので、最後は 1 点に潰れます。
対象は y[n] = θ + v、R = 1 で、θ は動きません。厳密解はカルマンフィルタと同じで、標準偏差は 1/√(n+1) で減っていきます。N = 100 で、乱数を変えた 20 回の中央値を比べます。
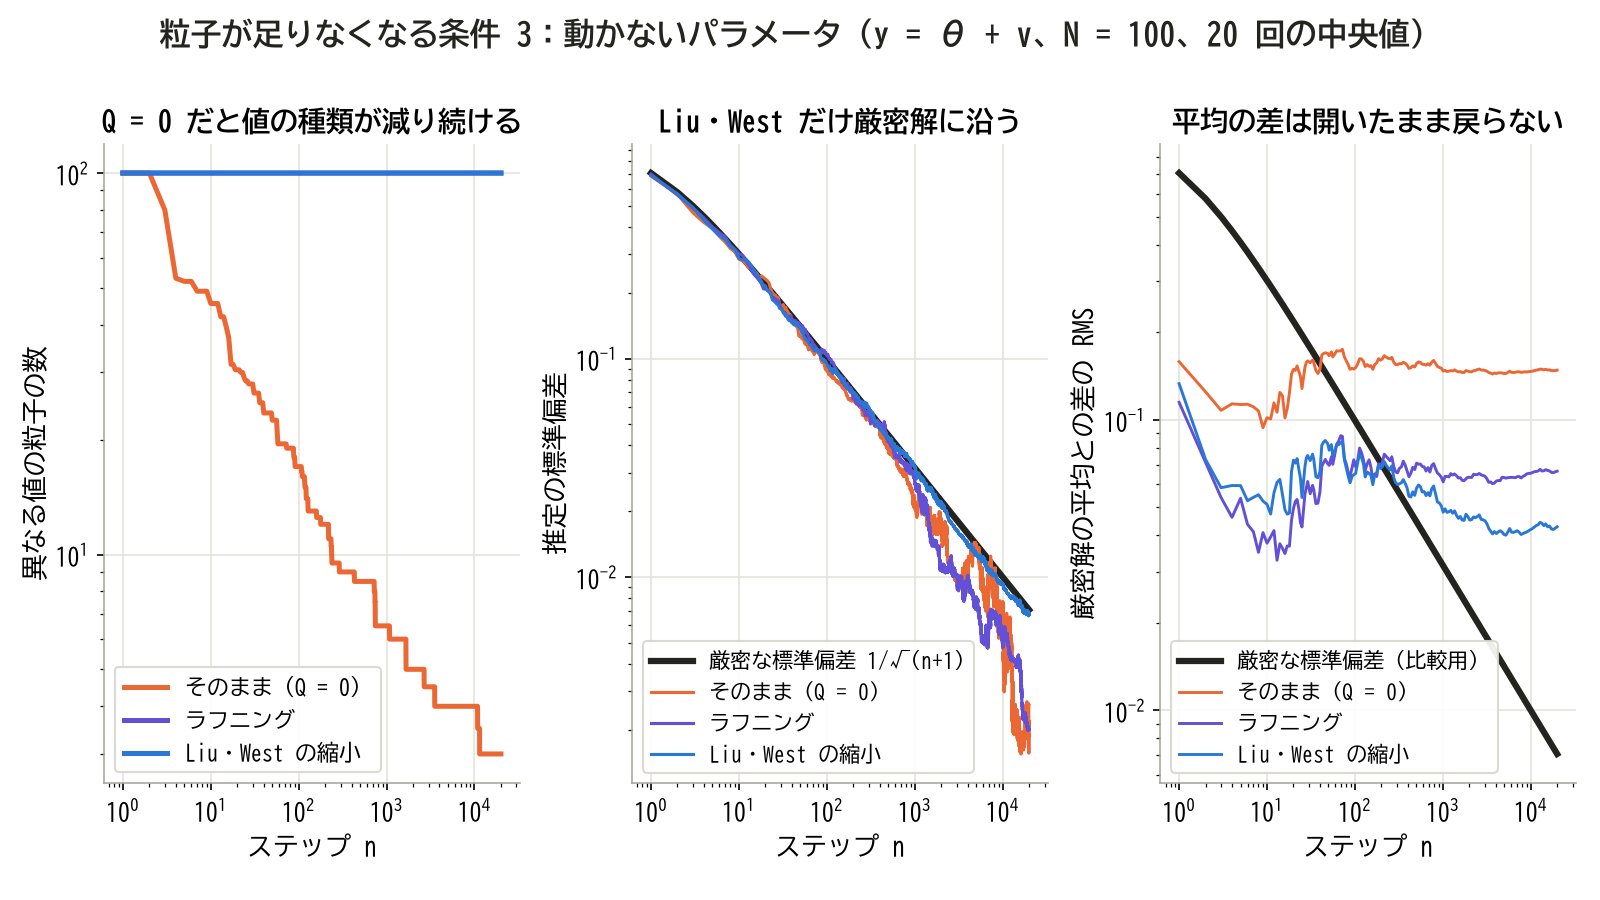
左:何もしないと異なる値の粒子が減り続ける。中:標準偏差はそのままとラフニングで厳密解より下へ外れ、Liu と West の縮小だけが沿う。右:標準偏差が縮みすぎると平均の差が残る
左の図で、何もしない場合の異なる値の粒子は、2 万ステップで 3 個まで減りました。2 万ステップの標準偏差は、厳密解の 0.0071 に対して、何もしないと 0.0021、ラフニングで 0.0020、Liu と West の縮小で 0.0067 です。値の種類が 1 つになると標準偏差は 0 になり、測定がどれだけ来ても推定値は動きません。フィルタは「もう完全に分かった」と言っているのに、値は止まっています。
救い方は 2 つあります。どちらも、リサンプリングのあとに人工の揺らぎを足します。
ラフニングは、Gordon らの 1993 年の論文にある方法です。各成分に、平均 0 で次の標準偏差のガウス分布の乱数を足します。
\sigma_j = \lambda\,D_j\,N^{-1/d}D_j は j 番目の成分の粒子の範囲(最大 − 最小)、λ は調整の数で、#6 のシグマ点の λ(広がりを決める数)とは別物です。以下ラフニングの係数と呼びます。N 個の点が d 次元の範囲に広がると、点の間隔はおよそ D_j N^{-1/d} です。つまり「粒子の間隔の λ 倍だけ揺らす」という意味です。分散を人工的に足すので、分布は少し広がります。
この考え方をカーネル密度推定(点の集まりを滑らかな山の和に直す統計の方法)として整理したのが、Musso らの正則化パーティクルフィルタです。
Liu と West の縮小は、広がりの分を中心へ縮めて打ち消します。粒子を重み付き平均の側へ a 倍に縮めてから、分散 s^2 V の乱数を足します。
\begin{gathered} x^{(i)} \leftarrow a\,x^{(i)} + (1-a)\,\hat{x} + s\sqrt{V}\,\varepsilon \\ a^2 + s^2 = 1,\quad a = \frac{3\zeta - 1}{2\zeta} \end{gathered}V は粒子の分散、 \hat{x} は重み付き平均、ε は標準正規乱数、ζ は調整の数(原論文では δ と書かれる割引の数。#5 の減衰比 ζ とは別)で、0.95〜0.99 程度です(図は 0.99)。a² + s² = 1 なので、平均と分散が変わりません。図の青の線が厳密解に沿うのは、この性質のためです。ラフニングは足した分散を打ち消さず、範囲 D_j で揺らぎの大きさを決めるので、N = 100 では長い時間で標準偏差が外れました。原論文はこれを補助粒子フィルタと組み合わせていますが、ここではリサンプリングのあとに当てる簡略版を示しました。
線形な部分をカルマンに任せる
条件 1 と 3 に効く、もっとも強い方法があります。状態の一部が線形でガウス分布なら、その部分は粒子で持たずに、粒子ごとのカルマンフィルタで解いてしまうのです。これをラオ・ブラックウェル化(Doucet ら 2000)、または周辺化パーティクルフィルタ(Schön ら 2005。周辺化は一部の変数を積分で消すこと)と呼びます。名前は統計学の定理に由来します。解析的に積分できる部分を積分すると分散が減る、という定理です。
#6 の IMU は、まさにこの形です。傾き θ を決めれば、バイアス b は線形の式で推定できます。そこで θ だけを粒子にして、b は粒子ごとに平均 \hat{b}^{(i)} と分散 P_b を持ちます。ω はジャイロの読みです。1 ステップの計算は次のとおりです。
\begin{gathered} S = T^2 P_b + Q_1 \\ \eta^{(i)} = \sqrt{S}\,\varepsilon^{(i)} \\ \theta^{(i)} \leftarrow \theta^{(i)} + T\bigl(\omega - \hat{b}^{(i)}\bigr) + \eta^{(i)} \\ \hat{b}^{(i)} \leftarrow \hat{b}^{(i)} - \frac{T P_b}{S}\,\eta^{(i)} \\ P_b \leftarrow \frac{P_b\, Q_1}{S} + Q_2 \end{gathered}| 記号 | 意味 | 備考 |
|---|---|---|
| θ⁽ⁱ⁾ | 粒子の傾き | 粒子はこれだけ |
| b̂⁽ⁱ⁾ | 粒子ごとのバイアスの平均 | θ の動きから学ぶ |
| P_b | バイアスの分散 | 全粒子で同じ値になる |
| Q₁、Q₂ | Q の対角(θ の分、b の分) | #6 の値 |
| S | θ の予測の分散 | b の不確かさの分を含む |
| η⁽ⁱ⁾ | θ の動きの乱数 | θ の予測からのずれ。測定のイノベーション ν とは別 |
| ω | ジャイロの読み | 既知の入力 |
| ε⁽ⁱ⁾ | 標準正規乱数 |
読み方はこうです。θ が予測より大きく動いたら、それは「b が思ったより小さかった」という情報です。粒子ごとの小さなカルマンフィルタが、θ の動きを測定に見立てて b を更新します。 P_b の式に θ が入らないので、全粒子で共通の 1 個で済み、メモリは 2 状態のブートストラップと同じです。効果は、次の章の設計例で数字にします。
粒子が足りなくなる 3 つの条件と、その救い方がそろいました。
| 条件 | 起きること | 救い方 |
|---|---|---|
| 次元が高い | 必要な N が指数で増える | ラオ・ブラックウェル化、測定を分ける |
| 測定が精密 | 尤度の山に粒子が入らない | 最適提案分布、線形化した提案分布 |
| 動かない状態 | 粒子が 1 点に潰れる | ラフニング、Liu と West の縮小 |
次の章では、これを使って設計します。
🛠️ 設計例
3 つの対象を、#5、#6 と同じ順で設計します。要件を決め、モデルを書き、Q と R を決め、粒子の数と提案分布とリサンプリングの方式を選び、初期分布を決めて、結果を確かめます。
設計例 1:IMU の鏡像
要件: 1 軸の加速度センサとジャイロで、傾き θ を 0〜180° の範囲で推定したい。起動時の向きは分からない。静止している間は 70° と 110° を区別できないので、「どちらか分からない」と正直に返し、動いたら正しい側へ絞りたい。
モデル: #6 の設計例 1 と同じです。fs = 200 Hz、状態は θ と b、測定は h = g sin θ です。動きは、70° で 8 秒静止、50° へ動いて静止、16〜20 秒で 90° へ動いて 25 秒まで保持、そして 50° へ戻る、とします。
Q と R: #6 の値をそのまま使います。ジャイロのノイズ 0.5 deg/s、バイアスの 1 サンプルの動き 0.002 deg/s、加速度の測定ノイズ 4 mg から、Q = diag(1.90×10⁻⁹, 1.22×10⁻⁹)、R = 1.54×10⁻³ です。
粒子の数と提案分布: 山が 2 つなので PF にします。次元が 2 なら数千個で足りるはずですが、θ の 1 サンプルの動きは 0.0025°、測定の幅は θ に直して 0.67° で、前の章の条件 2 に当たります。比べるのは、θ と b の両方を粒子にするブートストラップと、前の章のラオ・ブラックウェル化(θ だけを粒子にする)の 2 つです。リサンプリングは系統、しきい値は N/2 です。
初期分布: 事前分布を「sin θ が一様で、90° の左右に半々」とします。0〜180° の全体に広がる分布です。これを一様に撒いて最初の測定を受けると、測定の幅に入る粒子は 2 つの山を合わせて 3 % ほどしかありません。そこで、最初の測定で条件を付けた分布から直接引きます。この事前分布なら条件付きの分布は sin θ についてのガウス分布なので、次の式で引けます。
\theta^{(i)} = \arcsin\!\left(\frac{y[0] + \sigma_v\,\varepsilon^{(i)}}{g}\right)粒子の半分は、さらに 180^\circ - \theta^{(i)} に置いて鏡像の側へ配ります。 \sigma_v は測定ノイズの標準偏差です。バイアスの初期の標準偏差は 2 deg/s です。
結果: N = 5000 の 1 回の結果が次の図です。上の段が粒子の分布の時間変化、中の段が点推定、下の段が標準偏差です。上の段の 8 秒付近で、110° の線が消える瞬間を見てください。
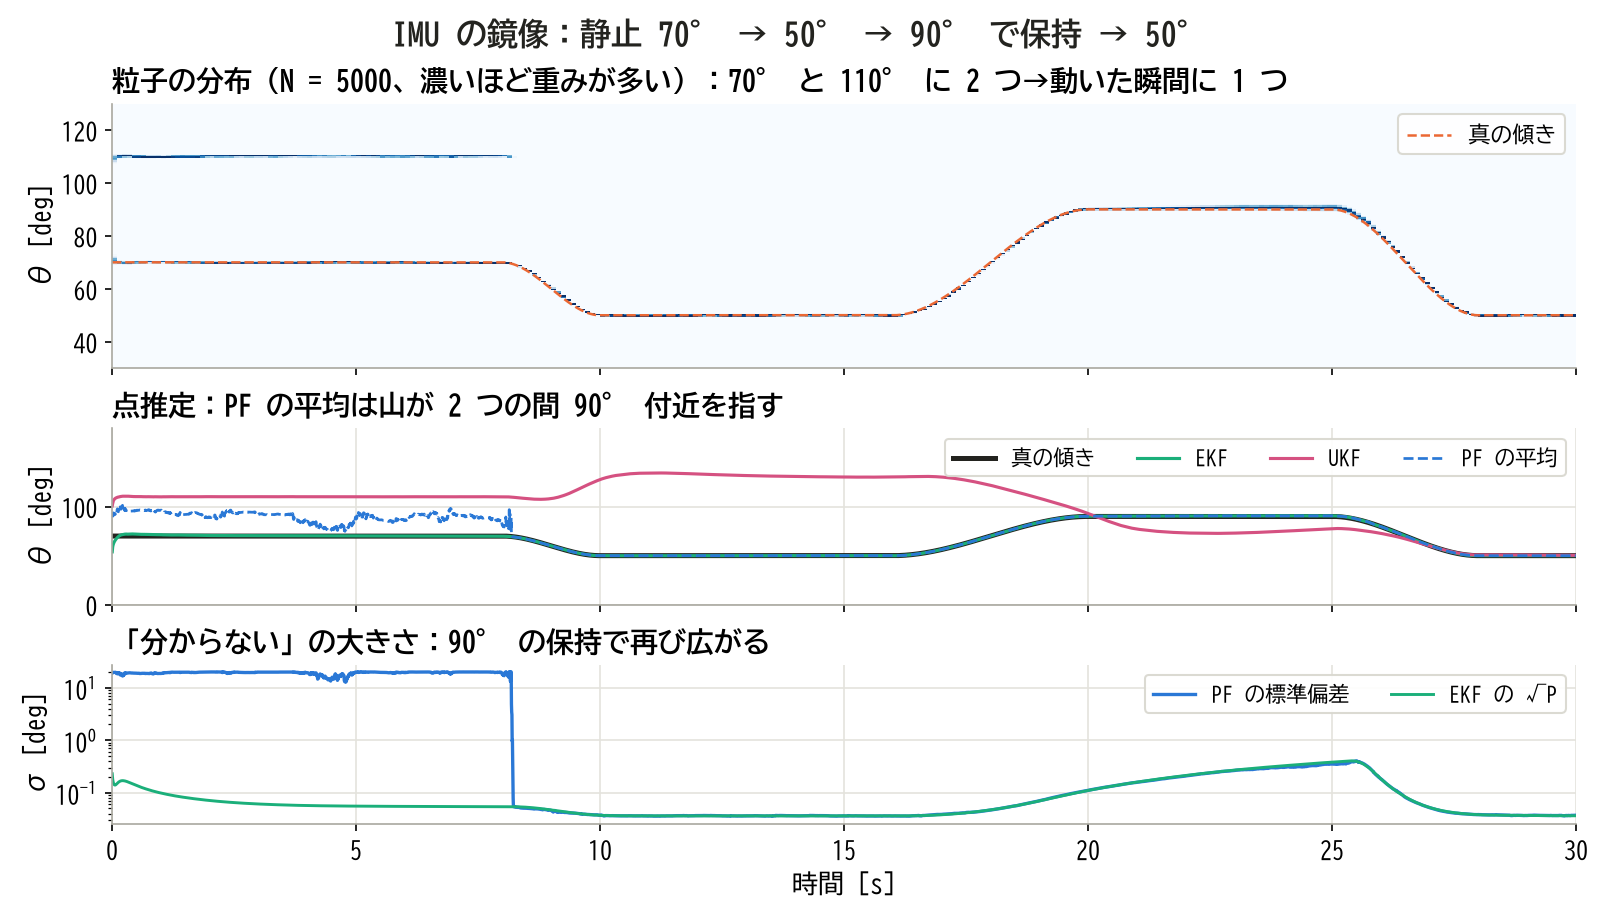
上:動き始めて 0.2 秒で 110° の山が消える。中:UKF は鏡像の側に残り、13 秒で 131.7°(真値 50°)。下:PF の標準偏差は「2 つの山の距離」の 20° から一気に 0.04° へ落ちる
静止している 7 秒の時点で、90° より下の山の重みは 0.45、残りの 0.55 が 110° の山にあります。粒子は 2 つの仮説を持ち続けています。このときの平均は 91.8°、標準偏差は 20.0° で、点推定としての平均には意味がありません。 意味があるのは分布のほうです。EKF は 69.9°、UKF は 110.0° を、それぞれ小さな P で返しています。どちらも片方に決め打ちしていて、UKF は外れています。
8 秒でジャイロが動きを伝えます。θ が減ると、70° の側なら sin θ は減り、110° の側なら sin θ は増えます。粒子はどちらもジャイロの読みの分だけ動くので、測定と合わない山の尤度が急に落ちます。動き始めて 0.2 秒、傾きが 0.6° 変わっただけで、110° の山は消えました(8.2 秒)。#6 が「測定を足すことが対策」と書いた鏡像の問題が、ジャイロの情報を分布の形のまま持ち越すことで解けたわけです。
UKF は 110° の側にいたので、この動きを別の説明で解釈しました。13 秒で 131.7° と、真値 50° から 80° 以上離れています。この例では、90° を通る動きのあとに戻りました。
保持の 90° では、θ の標準偏差が 0.04° から 0.25° まで広がりました。21〜24.5 秒の平均で、EKF の √P の 0.26° とほぼ同じです。#6 で見た感度 0 の領域で、測定が傾きをほとんど教えてくれないので、分布が広がることで「分からない」を返しています。この 1 回の実際の誤差の RMS は 0.57° で、標準偏差の 2 倍ほどです。1 回の結果なので、確かめるには次の表のように回数を重ねます。
100 回のモンテカルロ: 信号を変えて 100 回回しました。「正しい山に残った回数」は、11〜15 秒の RMSE が 1° 未満だった回数です。RMSE と被覆率(真の値が 95 % 区間に入った割合。検証の章で定義)は、正しい山に残った回だけで計算しました。
| 方式と N | 正しい山に残った回数 | RMSE | 被覆率 |
|---|---|---|---|
| ブートストラップ 256 | 55 | 0.033° | 95.1 % |
| ブートストラップ 1000 | 79 | 0.034° | 94.1 % |
| ブートストラップ 5000 | 96 | 0.035° | 93.4 % |
| θ だけ粒子 256 | 75 | 0.033° | 95.8 % |
| θ だけ粒子 1000 | 93 | 0.034° | 94.8 % |
| θ だけ粒子 5000 | 100 | 0.033° | 95.3 % |
この表の読み方が、この設計例の結論です。
- 山が残れば、どの N でも精度は同じ:RMSE は 0.033〜0.035°。N が効くのは精度ではない
- N が効くのは、山を失わないこと:N が足りないと、静止の間に片方の山の粒子が乱数で全部消え、半々の確率で正しい山を失う。N = 256 のブートストラップの 55 回は、ほぼコイントスである
- ラオ・ブラックウェル化は N を減らす:同じ回数の成績に要る N が数分の 1 になる。同じメモリで計算量もほぼ同じなので、使わない理由がない
静止の時間が長いほど、山を失う機会は増えます。この表は 8 秒静止の場合の数字です。
設計例 2:ρ = 19 の距離と方位
要件: #6 の条件 C です。距離 50 m、距離のノイズ 2 cm、方位のノイズ 5° で、平面を動く物体の位置と速度を 10 Hz で推定したい。EKF は NEES が大きく、UKF も理想の 4 に届かなかった対象です。
モデル: #6 の設計例 2 と同じ等速モデルで、T = 0.1 s、 \sigma_a = 0.02 m/s²、d = 4、R = diag(σr², σφ²) です。残差の方位は #6 の wrap で巻き戻します。
粒子の数と提案分布: 状態は 4 次元ですが、測定が見ているのは 2 つです。ブートストラップから始めます。リサンプリングは系統、しきい値は N/2 です。
初期分布: 最初の測定で距離と方位に乱数を足した点から作り、速度は平均 0、標準偏差 2 m/s です。測定の弓の形がそのまま初期分布になります。
ラフニング: Q がとても小さい対象です。1 ステップの位置の揺らぎは \sigma_a T^2/2 = 0.1 mm しかなく、複製された粒子がほとんど散らばりません。条件 3 に近い状態で、ラフニングの係数を λ = 0.1 とします。決め方は検証の章で示します。
結果: ある 1 回について、粒子の雲と、同じ時刻の UKF、EKF の楕円(2σ)を重ねたのが次の図です。縦軸と横軸の縮尺が違うことに注意してください。粒子の雲の形と、楕円の向きを比べてください。
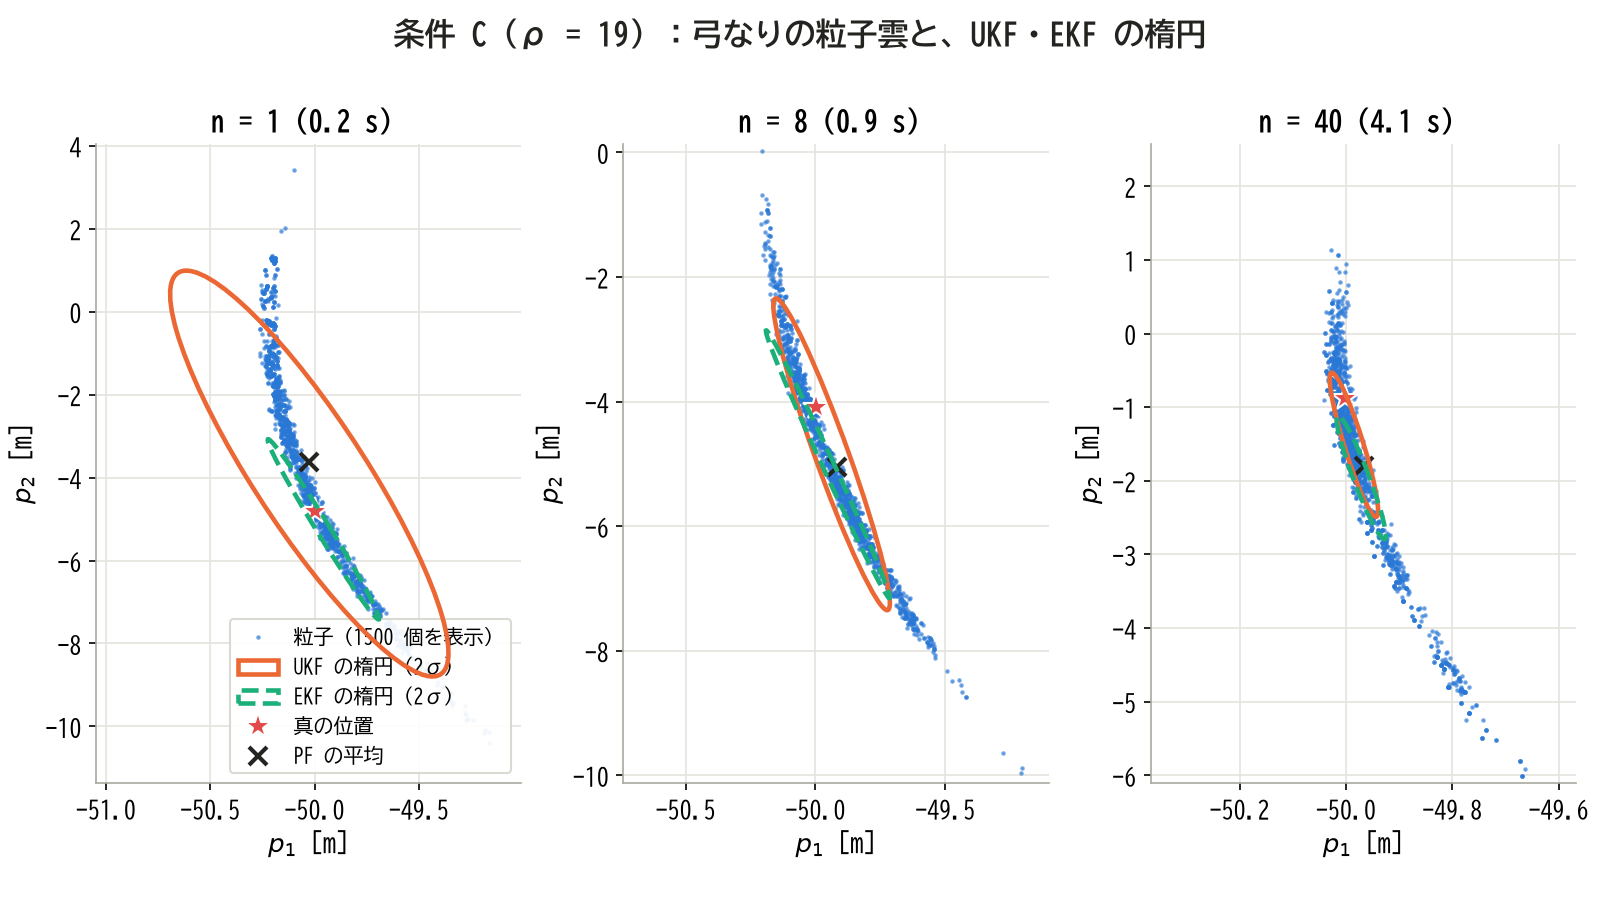
n = 1:粒子の雲は弓なりで、楕円の主軸は雲の向きと合わない。n = 40:UKF の標準偏差は p₂ で 0.49 m まで縮むが、粒子の雲はまだ 1.4 m ある
粒子の雲は、方位の誤差の分だけ細い弧に沿って伸びています。楕円は弧を直線で近似するので、向きがずれた場所に真の位置を置いてしまいます。4.1 秒の時点の p₂ の標準偏差は、粒子の雲が 1.36 m、UKF が 0.49 m です。UKF は不確かさを 3 倍近く小さく見積もっていて、これが NEES が大きくなる原因です。
100 回のモンテカルロで、#6 と同じ条件のまま、同じ信号に 5 つの方式を当てた結果です。
| 方式 | 位置の RMSE | NEES | 発散 |
|---|---|---|---|
| EKF | 1.71 m | 163 | 17 |
| UKF | 1.15 m | 55.8 | 7 |
| 変換+線形カルマン | 1.62 m | 2183 | 1 |
| PF N = 1000 | 0.93 m | 4.8 | 7 |
| PF N = 5000 | 0.80 m | 3.0 | 0 |
RMSE と NEES は 100 回の中央値で、最初の 1 秒を除いています。発散は #6 と同じ定義で、最後の時刻の位置誤差が、この表のいちばん良い RMSE の 5 倍(4.0 m)を超えた回数です。#6 の表の 546/49/2371 とは値が違います。信号の乱数が違うことと、発散する試行が NEES の値を大きく動かすことが理由で、順序関係は同じです。seed を変えた結果は検証の章に載せます。
PF は N = 5000 で、RMSE が UKF の 0.7 倍になり、NEES は 55.8 から 3.0 になり、発散もありません。平均と共分散では表せなかった分布を、粒子がそのまま持てたことの効果です。
N を変えたのが次の図です。左が RMSE、中が NEES、右が被覆率です。青とオレンジの線の差が、ラフニングの有無です。実験ごとに信号の乱数列が別なので、前の表とは値が少し違います。
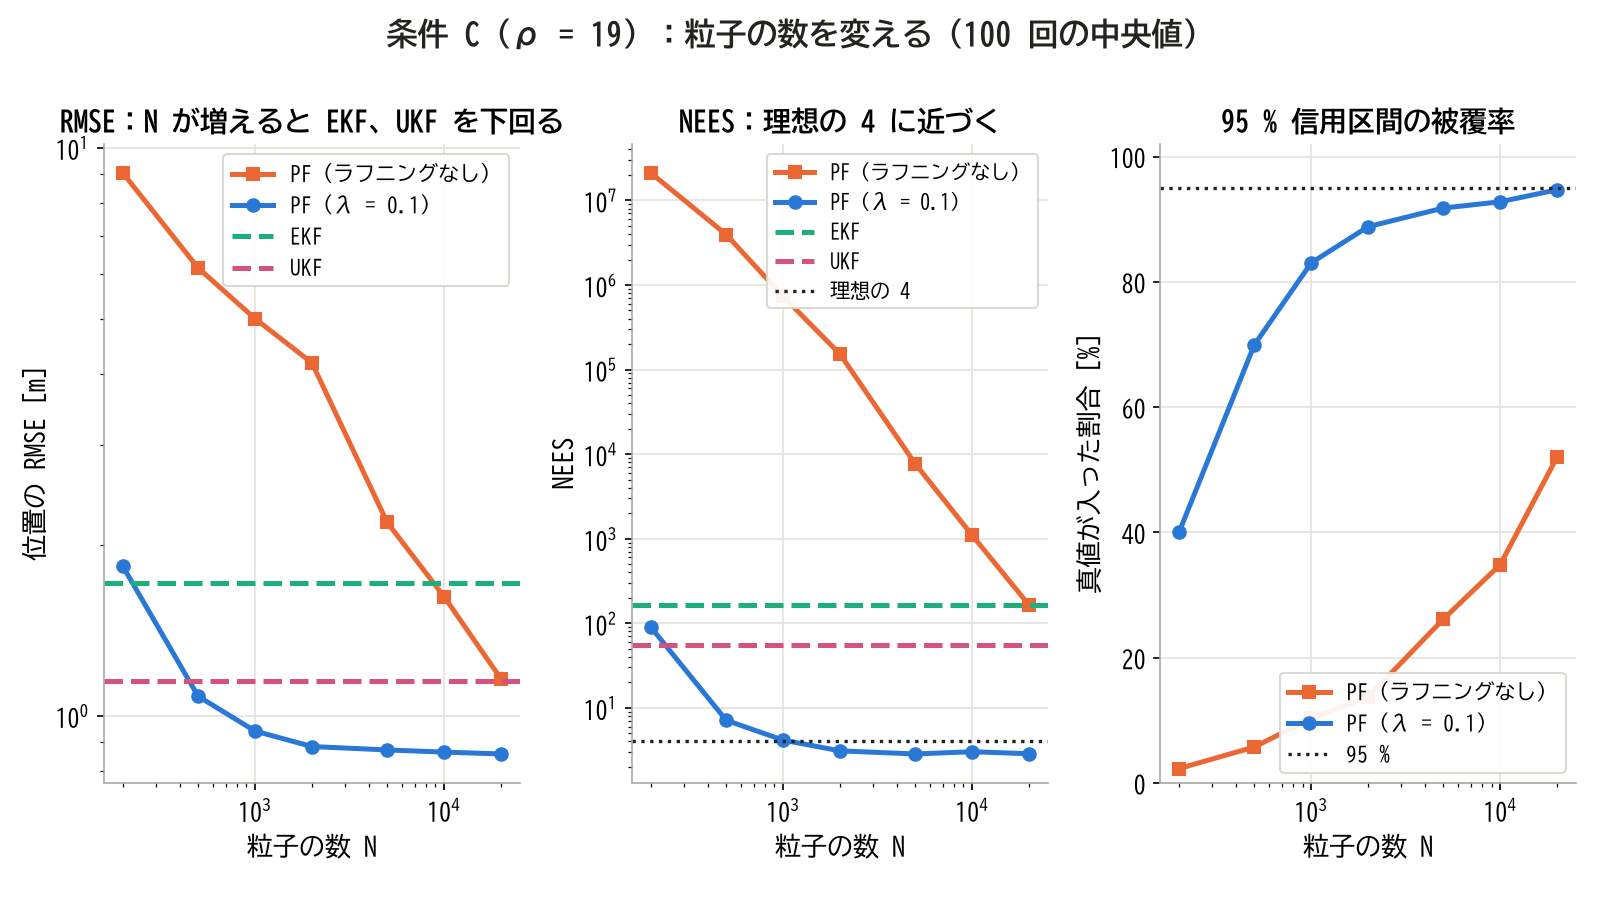
ラフニングあり(青):N = 500 付近で UKF に並び、N = 2000 で落ち着く。なし(オレンジ):N = 20000 でも NEES は 164、被覆率は 52 %
数値は次の表のとおりです。
| N | RMSE(λ = 0.1) | NEES(λ = 0.1) | NEES(λ = 0) |
|---|---|---|---|
| 200 | 1.83 m | 89 | 2.1×10⁷ |
| 500 | 1.08 m | 7.1 | 3.9×10⁶ |
| 1000 | 0.94 m | 4.2 | 7.3×10⁵ |
| 2000 | 0.88 m | 3.1 | 1.5×10⁵ |
| 5000 | 0.87 m | 2.9 | 7.7×10³ |
| 20000 | 0.86 m | 2.9 | 164 |
ラフニングなしは、N を 100 倍にしても追いつきません。Q が小さい対象で足りないのは粒子の数ではなく、粒子の値の種類です。N を増やす前に、人工の揺らぎを足すほうが効きます。
逆に、λ = 0.1 でも N = 200 は UKF より悪い結果です。粒子が足りない PF は、EKF より悪くなります。
初期誤差 5 m の再現: #6 の検証の章で EKF が大きく崩れた例です。距離 5 m、σr = 2 cm、σφ = 2°、初期の位置の標準偏差 5 m です。同じ信号の 100 回の結果を比べます。
| 方式 | 位置の RMSE | NEES | 発散 |
|---|---|---|---|
| EKF | 0.335 m | 438 | 33 |
| UKF | 0.053 m | 3.8 | 0 |
| 変換+線形カルマン | 0.053 m | 4.8 | 0 |
| PF 事前分布から N = 20000 | 2.46 m | 4.5×10⁷ | 96 |
| PF 測定から N = 1000 | 0.066 m | 7.6 | 19 |
| PF 測定から N = 5000 | 0.052 m | 4.6 | 3 |
RMSE と NEES は最初の 1 秒を除いた値で、#6 の表は最初の 3 秒を除いているので、数字はそのままは比べられません。発散のしきい値は 0.26 m です。
この例は、PF にとっての破る例です。事前分布の円(半径 5 m)から粒子を撒くと、測定の細い弧(幅 4 cm)に入る粒子がほとんどありません。条件 2 そのもので、N = 20000 でも 96 回発散しました。
最初の測定から撒けば、N = 5000 で UKF と同じ水準になります。ただし、ρ は 0.3 で分布はガウス分布に近く、UKF で十分な対象です。PF が要るかどうかは、分布の形で決まります。
設計例 3:廊下のロボット
要件: 一周 100 m の廊下で、ロボットが自分の位置を知りたい。地図にある扉は 12 m、28 m、63 m の 3 つで、車輪の回転から移動量(オドメトリ)が分かる。扉センサは、扉の前(±1 m)で 90 %、それ以外で 10 % の確率で反応する。最初の位置は分からない。
モデル: 状態は位置 x だけで、毎ステップ 1 m 進みます。オドメトリの誤差の標準偏差は 0.1 m で、フィルタの中では 0.2 m と広めに見積もります。
尤度: 扉の前の粒子には、センサが反応したら 0.9、反応しなければ 0.1 を掛けます。それ以外の粒子には 0.1 と 0.9 です。ガウス分布でも連続でもありません。カルマン系では書けない尤度を、そのまま使える例です。
粒子の数: N = 2000、一様な事前分布、毎ステップ系統リサンプリングです。
結果: 次の図は横軸が時間、縦軸が位置で、濃いほど粒子の重みが多いことを表します。オレンジの点が真の位置です。赤い破線の時刻に、ロボットを持ち上げて 40 m 先へ置きました。これを kidnapped robot(誘拐されたロボット)問題と呼びます。Thrun らが、自己位置推定の失敗から回復できるかを試す問題として挙げているものです。
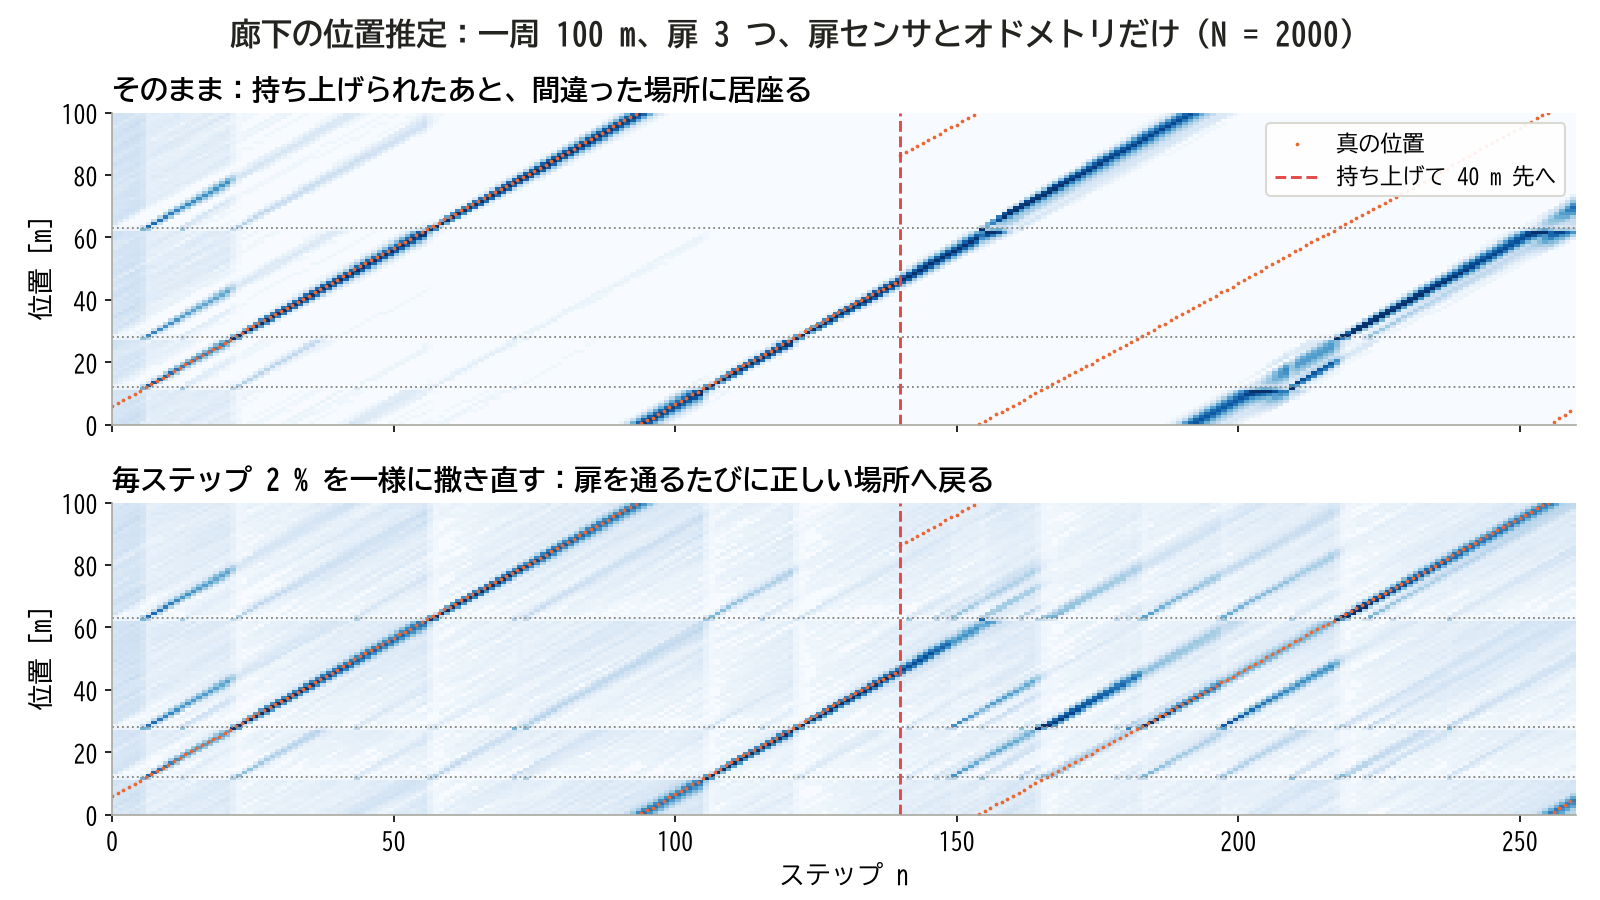
どちらも序盤は同じ:扉を通るたびに候補の線が絞られる。赤い破線のあと、上は誤った線に居座り、下は撒き直した粒子から真の線が育つ
序盤の 6 ステップ付近で、最初の扉の反応を受けて、扉の数と同じ 3 本の線が立ちます。モンテカルロ位置推定(MCL。地図の上の自分の位置を粒子で推定する方法)の型です。次の扉までの距離が場所によって違うので、2 つ目の扉で 1 本に絞られます。山が複数ある分布が、そのまま役に立っています。
上の段は持ち上げられたあと、粒子が真の位置の近くに 1 個も残っていないので、戻れません。Thrun らも、ふつうの MCL は持ち上げられたあとの近くに粒子が生き残らないと書いています。下の段は、毎ステップ 2 % の粒子を一様に撒き直しました。これが新しい仮説の種になり、扉を通るたびに正しい線が育ちます。
100 回の結果です。最後の 20 ステップの誤差の中央値が 3 m 未満なら「回復」と数えました。
| 方式 | 持ち上げ前の誤差 | 回復した回数 |
|---|---|---|
| そのまま | 0.33 m | 5 |
| 2 % を撒き直す | 0.72 m | 74 |
撒き直した場合の回復までの時間は、中央値で 47 ステップです。撒き直すと、ふだんの誤差は 0.33 m から 0.72 m に増えます。保険の代償です。Nav2 の AMCL の recovery_alpha_slow と recovery_alpha_fast は、平均の重みの短期と長期の比で、撒き直しを必要なときだけ入れる仕組みです。
✅ 検証
設計ができました。正しく動いているかを判定します。#5、#6 の道具のうち、何が使えて何が使えないのかを整理します。
NIS と NEES は目安にとどまる
粒子の重み付きの平均と共分散から、NIS も NEES も計算できます。ただし、どちらも「分布がガウス分布なら」χ² 分布(標準正規乱数の 2 乗の和が従う分布)に従う、という量です。PF を使う理由は分布がガウス分布でないことなので、前提が崩れています。
典型は鏡像です。静止の間の共分散は(20°)² で、真の値は平均から 20° 離れた山の上にいます。NEES の θ の分は 1 程度の「良い値」になりますが、分布の形については何も言っていません。
被覆率:区間に真の値が入る割合
そこで、分布そのものを検証します。粒子の重み付きの累積分布から、下から 2.5 % と 97.5 % の値を取ると、95 % の確率で真の値が入るはずの区間ができます。これを 95 % 信用区間と呼びます。シミュレーションでは真の値が分かるので、区間に入った割合を数えます。これが被覆率です。
95 % に近ければ、分布の広がりは正しいと言えます。大きく下回れば分布が狭すぎ、上回れば広すぎます。分布の形を仮定しないので、山が 2 つでも使えます。実機では真の値がないので、参照の測定器を使うか、シミュレーションで確かめてから持ち込みます。
| 対象 | N | 被覆率 |
|---|---|---|
| 線形(#5 の等速) | 100 | 91.6 % |
| 線形(#5 の等速) | 1000 | 94.8 % |
| 線形(#5 の等速) | 10000 | 94.6 % |
| IMU の鏡像(θ だけ粒子) | 5000 | 95.3 % |
| ρ = 19(λ = 0.1) | 1000 | 80.9 % |
| ρ = 19(λ = 0.1) | 5000 | 92.7 % |
| ρ = 19(λ = 0.1) | 20000 | 94.7 % |
線形の対象は N = 1000 で 95 % に乗ります。ρ = 19 は N = 5000 でも少し足りず、N = 20000 で届きます。同じ ρ = 19 の N = 5000 で、NEES は 3.0 と理想の 4 より小さく、「広すぎる」と読めますが、被覆率は 92.7 % で「少し狭い」と読めます。2 つの指標は逆を向いています。 分布がガウス分布でないので、共分散が裾の粒子に引っ張られて大きくなるのです。信じるべきは被覆率のほうです。
N_eff と調整の数
次の図の左は N_eff の時間変化、右はラフニングの係数 λ を振った結果です。右の図で、NEES と被覆率の両方が同時に良くなる範囲を見てください。
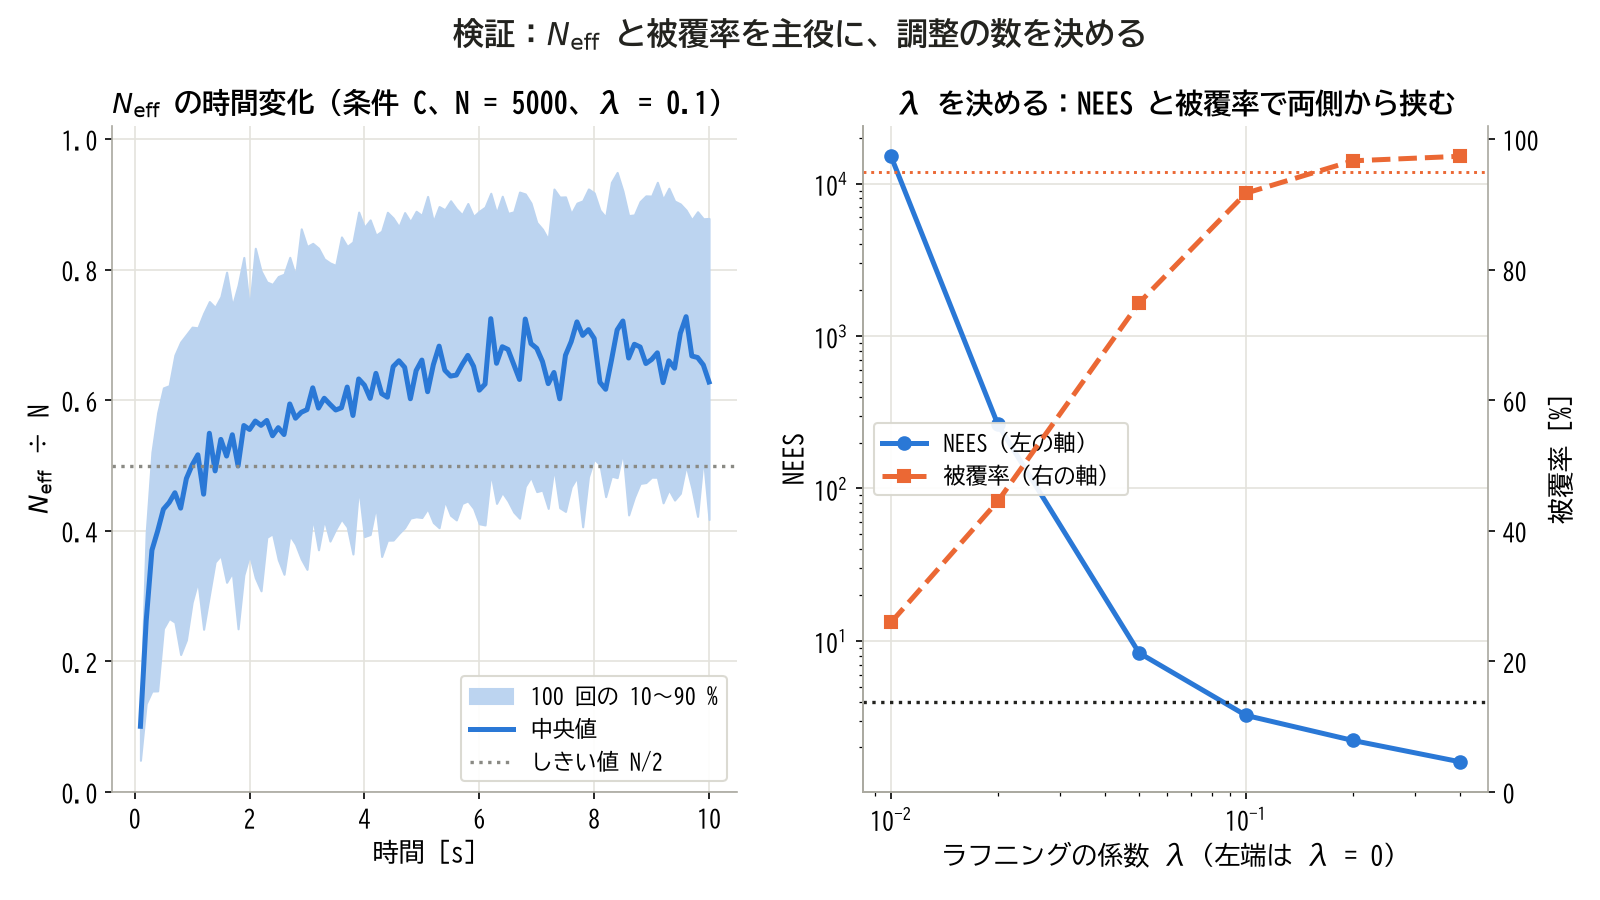
左:N_eff はしきい値の 0.5 と 1 の間を往復していて、健全な状態。右:λ が小さいと NEES が爆発し、大きいと被覆率が 95 % を超えて分布が広すぎる。0.1 付近が両方の境目
λ を振った結果を表にします。
| λ | RMSE | NEES | 被覆率 |
|---|---|---|---|
| 0 | 2.39 m | 1.5×10⁴ | 26 % |
| 0.05 | 0.98 m | 8.3 | 75 % |
| 0.1 | 0.87 m | 3.2 | 92 % |
| 0.2 | 0.88 m | 2.2 | 97 % |
| 0.4 | 1.11 m | 1.6 | 97 % |
N = 5000 で 60 回の結果です(信号の乱数列も回数も別の実験なので、λ = 0.1 の行は設計例 2 の表と少し違います)。RMSE は λ = 0.1〜0.2 で底になり、被覆率は 0.1 と 0.2 の間で 95 % を横切ります。λ は実効的に Q を足しているのと同じなので、#5 の「Q で見かけを整えない」と同じ注意が要ります。被覆率で両側から挟んで決めます。
N_eff が 1 付近に張り付いていたら、重みが 1 個に集まっています。N_eff が高いままでも、粒子の種類が減っていないかは別に見ます。
N と seed を変えて同じ結論か
1 回の設定で結論を出さないことも検証です。#5、#6 の 100 回のモンテカルロを、seed を変えて 3 通り回しました。ここも信号の乱数列が別の実験なので、seed 20261105 の行も設計例 2 の表とは値が少し違います。
| seed | UKF の RMSE/NEES | PF 1000 | PF 5000 |
|---|---|---|---|
| 20261105 | 1.18 m/45 | 0.92 m/4.6 | 0.88 m/3.1 |
| 1 | 1.04 m/24 | 1.00 m/4.6 | 0.85 m/3.1 |
| 2 | 1.10 m/37 | 0.94 m/4.5 | 0.83 m/3.0 |
PF の列の値はよくそろっています。UKF の NEES が seed で 2 倍近く動くのは、外れた試行が数字を動かすからです。結論は 3 通りとも同じです。
検証のチェックリストをまとめます。
- 線形に近い条件で、カルマンや EKF と同じ答えになるか
- N を 2 倍にして RMSE と被覆率が変わらないか、差が 1/√N で減るか
- 被覆率が 95 % に近いか
- N_eff がしきい値と 1 の間を往復しているか、1 付近に張り付いていないか
- seed を変えて同じ結論か
- 分布の山の数が変わる対象なら、山ごとの重みを追っているか
🕳️ 落とし穴
実装で踏みやすい穴をまとめます。どれも、動いているように見えて値が外れるものです。
重みのアンダーフロー
尤度をそのまま掛けると、値が小さくなりすぎて 0 になります。単精度の float で exp(−x) が 0 になるのは x が 104 くらいからで、ガウス尤度なら ν が標準偏差の 14.4 倍のときです。IMU の R なら、残差 0.57 m/s² で 0 です。全粒子の尤度が 0 になると、次の割り算が 0 ÷ 0 になり、すべてが NaN(数でない値)に変わります。
重みは対数のまま足して、正規化のときに最大値を引いてから exp に通します。
W^{(i)} = \frac{\exp\bigl(\ell^{(i)} - \ell_{\max}\bigr)}{\sum_j \exp\bigl(\ell^{(j)} - \ell_{\max}\bigr)}\ell^{(i)} は i 番目の対数重み、 \ell_{\max} はその最大値です。最大の粒子の exp は必ず 1 になるので、分母が 0 になりません。統計の分野で log-sum-exp と呼ばれる定番の書き方です。
毎回リサンプリングするか、N_eff で判定するか
#5 の等速モデル、N = 1000 で、しきい値だけを変えて、カルマンとの差の RMS を比べました。
| しきい値 | 選び直す割合 | カルマンとの差の RMS |
|---|---|---|
| 毎回 | 100 % | 0.0697 |
| N/2 | 63 % | 0.0689 |
| N/20 | 22 % | 0.1267 |
系統リサンプリングは揺らぎが小さいので、この対象では毎回選び直しても差はほとんど増えませんでした。N/2 にすると、同じ精度で選び直しの回数を 4 割ほど省けます。逆に、しきい値を N/20 まで下げると、重みが偏ったまま進むので差は 2 倍近くになります。迷ったら N_T = N/2 から始めてください。
サンプル貧困化
N_eff が高くても、粒子の値の種類が少なければ分布は表せません。N_eff は重みの偏りしか見ていないからです。Q が小さい対象では、複製された粒子がほとんど散らばらないので、種類が減り続けます。#6 の条件 C でラフニングが要ったのは、このためです。異なる値の粒子の数を数えると気づけます。
山の片方が消える
鏡像の例のように山が 2 つある分布では、片方の山の粒子が乱数で全部消えることがあります。一度消えた仮説は戻りません。測定で否定されたのではなく、ただ粒子が足りなくて消えるので、N_eff や NIS には現れません。設計例 1 の 100 回の表の「正しい山に残った回数」がこれです。数え方は単純で、山ごとの重みの合計を時間で追います。
次元の呪い
粒子を増やして解こうとする前に、必要な N を見積もります。対数尤度の分散 τ² が大きいなら、N を 2 倍にしても効きません。線形な部分をカルマンに任せるか、状態を減らします。
角度の巻き戻し
#6 と同じ穴が、平均の計算に出ます。−179° と +179° の粒子を普通に平均すると 0° になります。粒子の円平均(角度を単位円の上の点に直して平均し、角度に戻す計算)を使います。
\begin{aligned} \bar{\phi} = \mathrm{atan2}\Bigl(&\sum_i W^{(i)} \sin\phi^{(i)}, \\ &\sum_i W^{(i)} \cos\phi^{(i)}\Bigr) \end{aligned}尤度の残差の側も、#6 の wrap で巻き戻します。後の Python の mean_cov の angle と、gauss_loglik の res がこれに当たります。
外れ値に弱い尤度
ガウス尤度は、外れた測定を「極端にありえない」と扱い、重みを少数の粒子に集めます。そこで、裾の重い分布(中心から離れても確率が急に 0 にならない分布)を尤度に使います。パーティクルフィルタは尤度の形を問わないので、差し替えるだけです。x[n+1] = x[n] + w、y = x + v、σ = 0.1 の対象に、5.0(ノイズの 50 倍)の外れ値を 1 回入れて、直後の 10 ステップの最大誤差を比べました。ガウス尤度は 0.47、自由度 3 の t 分布の尤度は 0.17 です。
乱数の質と再現性
パーティクルフィルタの性能は乱数の質に依存します。C の rand() は周期や下位ビットの質が処理系に依存するので使いません。この記事の C のコードは xorshift32(シフトと排他的論理和だけで作る周期 2³² − 1 の乱数)です。seed を固定すると結果を再現できるので、不具合を調べるときに seed を記録します。同じ seed で別のコードと一致させたいときは、乱数を引く順序まで揃える必要があります。
💻 実装
式をコードにします。IMU の鏡像は C の float 版、汎用の版は Python です。
C:IMU の 2 状態(θ と b)
設計例 1 の、θ だけを粒子にしてバイアスを粒子ごとに持つ版です。#6 の ekf2_t と同じ見せ方で、N = 256 です。対数重み、系統リサンプリング、2 面バッファ(リサンプリングで書き込む先を別に持つ配列。同じ配列の中でコピーすると、まだ読んでいない粒子を壊すため)を使います。
#include <math.h>
#include <stdint.h>

#define PF_N 256             // 粒子の数

typedef struct {
    float T;                 // サンプリング周期 [s]
    float g;                 // 重力加速度 [m/s^2]
    float q1, q2;            // Q の対角(θ の分と b の分)
    float r;                 // 観測ノイズの分散 R
    float Pb;                // b の分散(全粒子で共通)
    float th[2][PF_N];       // 粒子の傾き [rad]。2 面バッファ
    float b[2][PF_N];        // 粒子ごとの b の平均 [rad/s]。2 面バッファ
    float logw[PF_N];        // 対数重み
    float w[PF_N];           // 正規化した重み(作業用)
    uint8_t cur;             // いま使っている面
    uint32_t s;              // 乱数の状態(0 以外)
    float spare;             // ガウス乱数の余り
    uint8_t has_spare;
    float mean, sd, neff;    // 出力
} pf2_t;

static float rand_u(pf2_t *f)            // xorshift32 で [0, 1) の一様乱数
{
    uint32_t x = f->s;
    x ^= x << 13; x ^= x >> 17; x ^= x << 5;
    f->s = x;
    return (float)(x >> 8) * (1.0f / 16777216.0f);
}

static float rand_n(pf2_t *f)            // ボックス・ミュラー法で標準正規乱数
{
    if (f->has_spare) { f->has_spare = 0; return f->spare; }
    float u = 1.0f - rand_u(f);          // (0, 1]
    float v = 6.2831853f * rand_u(f);
    float a = sqrtf(-2.0f * logf(u));
    f->spare = a * sinf(v);
    f->has_spare = 1;
    return a * cosf(v);
}

// 最初の測定から粒子を作る。半分を鏡像の側へ置く
void pf2_init(pf2_t *f, float y0, float sb0)
{
    float sv = sqrtf(f->r) / f->g;
    for (int i = 0; i < PF_N; i++) {
        float s = y0 / f->g + sv * rand_n(f);
        s = s > 1.0f ? 1.0f : (s < -1.0f ? -1.0f : s);
        float a = asinf(s);
        f->th[0][i] = (i < PF_N / 2) ? a : 3.14159265f - a;
        f->b[0][i] = 0.0f;
        f->logw[i] = 0.0f;
    }
    f->Pb = sb0 * sb0;
    f->cur = 0;
}

void pf2_step(pf2_t *f, float gyro, float y)
{
    float *th = f->th[f->cur], *b = f->b[f->cur];
    float S = f->T * f->T * f->Pb + f->q1;
    float sq = sqrtf(S);
    float K = -f->T * f->Pb / S;
    float lmax = -1e30f;

    for (int i = 0; i < PF_N; i++) {     // 予測と更新:点を流し、重みを掛ける
        float eta = sq * rand_n(f);
        th[i] += f->T * (gyro - b[i]) + eta;
        b[i] += K * eta;
        float e = y - f->g * sinf(th[i]);
        f->logw[i] -= 0.5f * e * e / f->r;
        if (f->logw[i] > lmax) lmax = f->logw[i];
    }
    f->Pb = f->Pb * f->q1 / S + f->q2;

    float s1 = 0.0f, s2 = 0.0f, m = 0.0f;
    for (int i = 0; i < PF_N; i++) {     // 最大値を引いてから exp(log-sum-exp)
        f->logw[i] -= lmax;
        f->w[i] = expf(f->logw[i]);
        s1 += f->w[i];
        s2 += f->w[i] * f->w[i];
        m += f->w[i] * th[i];
    }
    m /= s1;
    float v = 0.0f;
    for (int i = 0; i < PF_N; i++) {
        float d = th[i] - m;
        v += f->w[i] * d * d;
    }
    f->mean = m;
    f->sd = sqrtf(v / s1);
    f->neff = s1 * s1 / s2;

    if (f->neff < 0.5f * PF_N) {         // 系統リサンプリング O(N)
        float *th2 = f->th[!f->cur], *b2 = f->b[!f->cur];
        float step = s1 / PF_N;
        float u = step * rand_u(f);
        float c = f->w[0];
        int j = 0;
        for (int i = 0; i < PF_N; i++) {
            while (u > c && j < PF_N - 1) c += f->w[++j];
            th2[i] = th[j];
            b2[i] = b[j];
            f->logw[i] = 0.0f;
            u += step;
        }
        f->cur = !f->cur;
    }
}
使い方は #6 と同じです。gyro は 1 つ前のサンプルからの区間の読み [rad/s]、y はその時刻の加速度 [m/s²] です。設計例 1 の値なら、初期化は次のとおりです。
static pf2_t pf = {
    .T = 0.005f, .g = 9.80665f,
    .q1 = 1.904e-9f, .q2 = 1.218e-9f,    // (T sg)^2, sb^2
    .r = 1.539e-3f,                      // (4 mg)^2
    .s = 20261105u,                      // 乱数の seed(0 以外)
};

pf2_init(&pf, y0, 0.0349f);              // 最初の測定と、b の標準偏差 2 deg/s
pf2_step(&pf, gyro, y);                  // 毎サンプル。pf.mean、pf.sd、pf.neff が出力
設計例 1 の信号 100 本をこのコードに入れて、同じ信号の Python の倍精度版と比べました。乱数の列は別です。
| 比較 | 正しい山に残った回数 | RMSE(11〜15 s) | N_eff ÷ N |
|---|---|---|---|
| C(float、N = 256) | 69 / 100 | 0.0339° | 0.75 |
| Python(倍精度、N = 256) | 70 / 100 | 0.0337° | 0.73 |
float でも結果は同じ水準です。1 ステップの計算量とメモリを、#6 の EKF、UKF と同じ 2 状態で並べます。
| 方式 | f、h の回数 | exp と乱数 | メモリ |
|---|---|---|---|
| EKF | 各 1 回 | なし | 20 B |
| UKF | 各 5 回 | なし | 60 B |
| PF N = 256 | 各 256 回 | 各 256 回 | 6144 B |
メモリの内訳は、粒子が N × 状態の数 × 4 B × 2 面で 4096 B、対数重みと作業用の重みが 1024 B ずつです。乱数はボックス・ミュラー法(一様乱数 2 個からガウス乱数 2 個を作る式)で 256 個分、log と sqrt と sin と cos が 128 回ずつ入ります。EKF の 1 ステップの数百倍の計算です。 200 Hz なら 1 秒に h を 5 万回以上計算するので、手元のマイコンで sinf と expf に何サイクルかかるかを先に測ってから N を決めてください。
Python:汎用のパーティクルフィルタ
予測、更新、リサンプリング、平均と共分散を関数に分けた版です。f(X, n) と尤度の関数を渡すだけで動きます。粒子は行が粒子、列が状態の行列で持ち、関数も行列で受けて行列で返します。
import numpy as np


def normalize(logw):
    """対数重みを正規化する。最大値を引いてから exp に通す(log-sum-exp)。"""
    W = np.exp(logw - logw.max())
    return W / W.sum()


def neff(W):
    return 1.0 / np.sum(W ** 2)


def multinomial(W, rng):
    return np.searchsorted(np.cumsum(W), rng.uniform(size=len(W))).clip(0, len(W) - 1)


def stratified(W, rng):
    N = len(W)
    return np.searchsorted(np.cumsum(W), (np.arange(N) + rng.uniform(size=N)) / N).clip(0, N - 1)


def systematic(W, rng, u=None):
    N = len(W)
    u = rng.uniform(0, 1 / N) if u is None else u
    return np.searchsorted(np.cumsum(W), np.arange(N) / N + u).clip(0, N - 1)


def residual(W, rng):
    N = len(W)
    n = np.floor(N * W).astype(int)
    idx, r = np.repeat(np.arange(N), n), N - n.sum()
    if r > 0:
        Wr = (N * W - n) / r
        idx = np.r_[idx, np.searchsorted(np.cumsum(Wr), rng.uniform(size=r)).clip(0, N - 1)]
    return idx


RESAMPLE = dict(multinomial=multinomial, stratified=stratified, systematic=systematic, residual=residual)


def mean_cov(X, W, angle=()):
    """重み付きの平均と共分散。angle に挙げた列は円平均で計算する。"""
    m = W @ X
    d = X - m
    for j in angle:
        m[j] = np.arctan2(W @ np.sin(X[:, j]), W @ np.cos(X[:, j]))
        d[:, j] = (X[:, j] - m[j] + np.pi) % (2 * np.pi) - np.pi
    return m, (d.T * W) @ d


def gauss_loglik(h, R, res=None):
    """ガウス尤度のフックを作る。res は残差の関数(角度の巻き戻しなどに差し替える)。"""
    Ri = np.linalg.inv(R)
    res = res or (lambda y, H: y - H)
    def loglik(y, X):
        nu = res(y, h(X))
        return -0.5 * np.sum((nu @ Ri) * nu, axis=1)
    return loglik


def pf_run(f, loglik, noise, ys, X0, rng, method="systematic", thr=0.5, angle=(), rough=0.0, cb=None):
    """ブートストラップ PF。f(X, n)、loglik(y, X)、noise(N, rng) は行列で受けて行列で返す。"""
    X = X0.copy()
    N, d = X.shape
    logw = np.zeros(N)
    xs, Ps, ne = [], [], []
    for n, y in enumerate(ys):
        X = f(X, n) + noise(N, rng)             # 予測:点を流す
        logw = logw + loglik(y, X)              # 更新:重みを掛ける
        W = normalize(logw)
        m, P = mean_cov(X, W, angle)
        xs.append(m); Ps.append(P); ne.append(neff(W))
        if cb:
            cb(n, X, W)
        if ne[-1] < thr * N:                    # 偏ったら選び直す
            X = X[RESAMPLE[method](W, rng)]
            logw = np.zeros(N)
            if rough > 0:                       # ラフニング(λ × 範囲 × N^(−1/d) の揺らぎ)
                E = X.max(axis=0) - X.min(axis=0)
                X = X + rough * E * N ** (-1 / d) * rng.standard_normal((N, d))
    return np.array(xs), np.array(Ps), np.array(ne)
loglik(y, X) が尤度のフックです。ガウス尤度なら gauss_loglik(h, R, res) で作り、res を差し替えると角度の残差を巻き戻せます。扉のセンサや裾の重い尤度は、関数を直接書きます。angle に角度の列の番号を渡すと円平均になります。method で 4 方式を選べます。
戻り値は #6 の ekf_run、ukf_run と同じ順で、推定値、共分散、そして NIS の代わりに N_eff です。同じ条件で比べるのに使えます。手計算の章の値は、次のコードで確かめられます。
W = normalize(-0.5 * (1.4 - np.array([-1.0, -0.7, 0.4, 1.4, 1.6])) ** 2 / 0.25)
print(W.round(6), round(neff(W), 2))
print(systematic(W, None, u=0.1))
[5.00000e-06 7.20000e-05 6.57410e-02 4.85765e-01 4.48417e-01] 2.27
[3 3 3 4 4]
番号は 0 から始まるので、3 と 4 が本文の 4 番と 5 番です。
ライブラリを使うなら、FilterPy に monte_carlo モジュールがあり、リサンプリングの関数が入っています。
💡 活用事例
分野ごとに「なぜカルマン系ではなくパーティクルフィルタなのか」を見ます。共通するのは、分布の形が崩れるか、モデルが式で書けないことです。
- ロボットの自己位置推定:地図の上でロボットがどこにいるかを推定するモンテカルロ位置推定(MCL)は、PF の代表的な応用です。候補が地図の複数の場所に割れる(山が複数ある)ので、ガウス近似が合いません。ROS 2 のナビゲーション Nav2 の AMCL は、Fox の KLD サンプリング(分布の広がりに応じて粒子の数を自動で変える方法)を使い、既定の粒子の数は 500〜2000 です
- 同時位置推定と地図作成(SLAM):FastSLAM(Montemerlo ら 2002)は、ロボットの経路を粒子で持ち、ランドマーク(地図の目印)の位置を粒子ごとの EKF で持ちます。ラオ・ブラックウェル化の代表例で、EKF で全部を持つと計算量がランドマークの数の 2 乗になるところを、対数で済ませます
- 画像の追跡:CONDENSATION(Isard と Blake 1998)は、画像の背景に似た物があると、尤度の山が複数できることを扱います。追う物の候補が複数に割れても、粒子で保持できます
- 方位だけの追尾:Gordon らの 1993 年の論文の題材です。方位だけでは距離が分からないので、分布が方位の線に沿って伸びます。#6 の弓なりと同じ形で、同論文は EKF を大きく上回ると報告しています
- 電池の余寿命:NASA の Saha らは、関連ベクトルマシン(データから確率つきの回帰モデルを作る手法)で作ったモデルをパーティクルフィルタに入れ、余寿命を 1 つの数ではなく確率分布で返します。出力が分布そのものであることを使う例です
- 測位:Gustafsson の 2010 年の解説は、パーティクルフィルタの理論と実践を、測位の応用を題材にまとめています
- 気象のデータ同化:次元の壁の例です。状態が数百万次元以上になる数値予報では、Snyder らの結果のとおり、素のパーティクルフィルタは使えません
🧭 使い分けの勘所:線形カルマン・EKF・UKF・パーティクル
#5〜#7 で 4 つの推定器がそろいました。違いは分布をどう持つかです。線形カルマンは平均と共分散を厳密に運び、EKF は線形化で、UKF は代表点で運び、パーティクルフィルタは分布を点の集まりのまま運びます。どれが要るかは、対象の性質で決まります。
迷ったら軽いほうから試します。NIS、NEES、被覆率を見て前提が崩れていたら、次の段へ上げます。#6 の線形カルマンは傾きが大きいと NIS が 14 になり、真の値を知らなくても設計の誤りに気づけました。
判断の軸
見る軸は 9 つです。上の軸ほど、先に確かめると早く決まります。表の PF はパーティクルフィルタの略です。
| 軸 | 見るもの | 目安 | 選ぶもの |
|---|---|---|---|
| ① 線形か | f と h が状態の定数倍と足し算だけか | そうなら厳密解がある | #5 のカルマン。相補、αβ はゲイン固定の簡略版 |
| ② 非線形の強さ | 曲率 × 分散。距離と方位なら ρ | ρ が 1 より十分小さい/1〜10/10 超 | 変換+線形か EKF/EKF か UKF(UKF が安全)/PF が候補 |
| ③ 山の数 | 鏡像や地図の上の候補のように、分布が割れるか | 山が 2 つ以上 | PF 一択 |
| ④ 尤度の形 | 測定のノイズがガウス分布か | 0 か 1 のセンサ、外れ値 | PF |
| ⑤ モデルの形 | 手元に何があるか | 微分できる式/関数として呼べるだけ/シミュレータだけ | EKF/UKF/PF |
| ⑥ 状態の数 | d と対数尤度の分散 τ² | PF の N は d に対して指数で増える | 高次元は EKF か UKF。線形な部分はラオ・ブラックウェル化 |
| ⑦ 計算量 | 1 ステップの f、h の回数 | EKF 1 回/UKF 2d + 1 回/PF N 回 | 足りる中でいちばん軽いもの |
| ⑧ 初期誤差 | 初期の不確かさが線形化の範囲を超えるか | 5 m で EKF は 100 回中 43 回発散、UKF は 0 回 | UKF。PF なら測定から撒く |
| ⑨ 不確かさの返し方 | 「分からない」を分布で返す必要があるか | 鏡像の静止中のように候補が割れる | PF。ただし測定に無い情報は作れない |
表の言葉を補います。
- 相補フィルタ、αβ フィルタ:相補はジャイロと加速度を固定の比で合わせる式、αβ は位置と速度を固定のゲインで追う式です。#5 で見たとおり、どちらも定常カルマン(ゲインが一定値に落ち着いたカルマンフィルタ)と同じ形をしています
- 曲率 × 分散:#6 の線形化が破れる条件です。 |h''|\sigma^2/2 を測定のノイズと比べて、十分に小さければ線形化が効きます。#6 の IMU では約 3500 分の 1 で、EKF と UKF の差は最大 0.0004° でした
- ρ:距離と方位の測定で曲率 × 分散を書き直した数 \rho = r\sigma_\phi^2/\sigma_r です。ほかの対象には、曲率 × 分散のほうを使います
- 変換+線形:測定を直交座標へ変換して線形カルマンに入れる方法です
- ヤコビ行列:EKF が使う、f と h の 1 次の微分を並べた行列です。式が微分できない、書きにくいときは、f と h を呼ぶだけで動く UKF に回します
② の目安は、#6 の 3 つの条件の結果から来ています。値は NEES で、理想は 4 です。
| ρ | EKF | UKF | 読み方 |
|---|---|---|---|
| 0.38 | 3.3 | 3.3 | 差がない |
| 1.9 | 5.7 | 4.4 | UKF が少し良い |
| 19 | 546 | 49.0 | UKF でも理想の 10 倍以上 |
⑦ のメモリは、2 状態の例で EKF が 20 B、UKF が 60 B、N = 256 の PF が 6144 B です。⑧ の数字は #6 の表の値で、信号が別のこの記事の設計例 2 では EKF の発散は 33 回でした。PF も事前分布の円から撒くと N = 20000 で 96 回発散するので、測定から撒きます。
決定木
同じ判断を 1 本の流れにします。上から順に答えていくと、読むべき回に着きます。
尤度が非ガウス、
シミュレータだけ、
のどれか?"] E -->|いいえ| G["曲率 × 分散、
ρ を計算"] E -->|はい| F["#7 パーティクル
d が大きければ
ラオ・ブラック
ウェル化"] G -->|"ρ ≪ 1"| I["変換+線形
か EKF"] G -->|"ρ 1〜10"| H["UKF
軽さが要り
ヤコビ行列が
書けるなら
EKF"] G -->|"ρ 10 超"| F
いちばん上の「モデルがない」は、状態方程式も Q も R も与えられない場合です。この場合は、入力と誤差からフィルタの係数を学習する適応フィルタを使います。#8 で扱います。図の ρ ≪ 1 は「ρ が 1 より十分に小さい」という意味です。ρ の無い対象は、曲率 × 分散を測定のノイズと比べて読み替えます。
用途別の早見表
連載に出た題材を、対象ごとに並べます。
| 対象 | 分布と非線形の様子 | 向くもの | 根拠 |
|---|---|---|---|
| IMU の小さな傾き | sin θ ≈ θ で線形 | 線形カルマンか相補 | #5 設計例 1 |
| IMU の大きな傾き | g sin θ が曲がるが、1 ステップの範囲ではほぼ直線 | EKF で足りる | #6 設計例 1 |
| 起動時の向きが分からない IMU | 鏡像で山が 2 つ | PF。UKF は動くまで片方に決め打ち | #7 設計例 1 |
| 距離と方位の追尾 | ρ で決まる | ρ = 0.38 は 3 方式同じ、1.9 は UKF、19 は PF | #6 設計例 2、#7 設計例 2 |
| 等速で位置だけ測る | 線形 | αβ か定常カルマン | #5 の比較の章 |
| 電池の SoC(残量の割合) | 積算は線形、電圧の曲線が線形でない | EKF か UKF | #6 設計例 3 |
| 地図の上の自己位置 | 候補が複数の場所に割れる | PF | #7 設計例 3 |
| 画像の追跡 | 似た物があると尤度の山が複数できる | PF | #7 活用事例 |
| 宇宙機の姿勢 | 四元数(回転を表す 4 つの数)に制約がある | MEKF(誤差を 3 つの数で持つ EKF) | #6 活用事例 |
| 温度 | 1 状態で線形 | 1 状態のカルマン | #5 設計例 3 |
| エンコーダの速度 | 等速モデルで線形 | 定常カルマン | #5 設計例 2 |
同じ IMU でも、傾きの範囲と起動時の条件で行が変わります。方式は対象の名前ではなく、分布の形で決まるからです。
勘所
- 線形なら PF を使う理由はない:#5 の等速モデルでは、N = 10000 の PF の RMSE は 0.8612 で、カルマンの 0.8608 と同じでした。それで f と h の回数は 1 万倍です
- 粒子が足りない PF は EKF より悪い:ρ = 19 の例で、N = 200 の RMSE は 1.83 m、EKF は 1.71 m でした。PF に替えたら、N を増やして結果が変わらなくなるところまで確かめます
- NEES が理想の 10 倍以上なら、分布の形を疑う:Q を増やして数字を整える前に、平均と共分散で表せる分布なのかを問います
- PF にするなら、先に τ² で N を見積もる:対数尤度の分散が大きい対象は、N を増やしても追いつきません。提案分布と状態の減らし方を先に考えます
- Q が小さい対象の PF は、ラフニングを前提にする:ρ = 19 の例では、ラフニングなしだと N = 20000 でも NEES は 164 でした。足りないのは粒子の数ではなく値の種類です
- 測定に無い情報は、方式を替えても出てこない:θ = 90° の感度 0 では、どの方式でも不確かさが広がるだけです。対策は測定を足すことです
- 切り替えは段階的に:線形、EKF、UKF、PF の順に上げ、前の段の結果を次の段の検算に使います。線形に近い条件で前の段と同じ答えが出なければ、実装を疑います
✅ まとめ
- パーティクルフィルタは事後分布を N 個の粒子と重みで表す。予測は点を流し、更新は重みを掛け、偏ったら選び直す。ガウス近似も線形化も使わず、精度は N で決まる
- モンテカルロ積分の誤差は \sigma_\psi/\sqrt{N} 。重要度サンプリングは p/q の重みで補正し、q が遠いと定数が悪くなる
- 重みの再帰はベイズフィルタから出る。ブートストラップは提案分布を状態遷移にして、重みを尤度だけにしたもの
- 重みは必ず退化する。N_eff で測り、 N_T = N/2 を切ったら系統リサンプリングで選び直す
- 線形ガウスの対象では N を増やすと #5 のカルマンに一致し、差は 1/√N で減り、周波数応答も H(z) に乗る
- 粒子が足りなくなる条件は 3 つ。次元(実体は対数尤度の分散 τ²)、精密すぎる測定、動かない状態。救い方はラオ・ブラックウェル化、最適提案分布、ラフニングと Liu と West の縮小
- 鏡像の例では、PF は 2 つの山を持ち続け、動いた瞬間に真の山だけを残す。ただし N が足りないと山の片方が消える
- ρ = 19 の例では、PF は UKF より RMSE で 1.4 倍良く、NEES も理想に近い。Q が小さいのでラフニングが必須
- 検証の主役は被覆率と N_eff。分布がガウス分布でないとき NEES は目安にとどまる
ここまでで、分布の形が崩れる対象に対して、粒子の数と提案分布を選び、設計して、数字で判定できるようになりました。次の一手は、手元の対象の尤度を書いて、この記事の Python に差し替え、まず線形に近い条件でカルマンや EKF と合うことを確かめてから、本当に分布が崩れる条件へ進むことです。
ここまでの #5〜#7 は、すべてモデルがあることが前提でした。状態方程式と Q、R を人間が与えていました。では、モデルが分からない対象はどうするのか。次回の #8 では、モデルを持たず、入力と誤差からフィルタの係数そのものを学習していく適応フィルタ(LMS、NLMS、RLS)へ進みます。
よくある質問(FAQ)
Q. 粒子はいくつ必要ですか?
A. 対象で決まり、一律の答えはありません。出発点として、この記事の 2 状態の例では数千個でした。見積もりには 1 回の更新の対数尤度の分散 τ² を使い、大きければ N より先に提案分布や状態の減らし方を考えます。決め方は、N を 2 倍ずつ増やして、被覆率と RMSE が変わらなくなるところを探すことです。
Q. 毎回リサンプリングしてもいいですか?
A. 動きます。ただし、値の種類が減る機会が増えます。N_eff が N/2 を切ったときだけ選び直すのが標準です。この記事の線形の例では、N/2 にすると精度を変えずに回数を 4 割ほど省けました。方式は、計算量が O(N) で乱数が 1 個の系統リサンプリングから始めます。粒子の順序に規則性があるときは、層化か残差に替えます。
Q. UKF とどちらを選べばいいですか?
A. 分布が 1 つの山で、弓なりでなければ UKF です。計算量が桁で違います。#6 の ρ が 1 より十分小さい範囲では、PF を使う理由はありません。山が複数に割れる、ρ が 10 を超える、尤度がガウス分布でない、モデルがシミュレータでしかない、といった場合に PF を選びます。詳しくは「使い分けの勘所」の節にまとめました。
Q. パラメータの推定もできますか?
A. できますが、そのまま状態に入れると Q = 0 なので粒子が潰れます。ラフニングや Liu と West の縮小を使うか、人工の小さなプロセスノイズを足します。線形な関係のパラメータなら、ラオ・ブラックウェル化で粒子から外すのがいちばん効きます。
Q. パーティクルフィルタは最適ですか?
A. N → ∞ で正しいベイズの事後分布に近づくので、その意味では最適な推定に近づきます。有限の N では近似で、N が足りなければ外れます。「最適」と言えるのは分布に対してで、平均 2 乗誤差を最小にする点推定は事後分布の平均、山が 2 つあるときに平均が役に立たないのは、この記事の冒頭の図のとおりです。
関連記事
この連載:
- #1 基礎編 — 伝達関数、ボード線図、白色ノイズの測り方、C の骨格
- #2 ローパスフィルタの設計 — 同じカットオフでの比較とナイキスト線図
- #3 ハイパスフィルタの設計 — DC とドリフトを消す
- #4 バンドパスとノッチの設計 — 狙った周波数を扱う
- #5 カルマンフィルタの設計 — 5 本の式、定常ゲイン、相補と αβ
- #6 EKF・UKF の設計 — ヤコビ行列とシグマ点、線形化が破れる条件
- #8 適応フィルタの設計 — LMS・NLMS・RLS の導出、誤調整、等価ノッチ、使い分けの勘所
センサの入口:
- 加速度センサ KXR94-2050 で作るデジタル水平器 — 重力の向きから角度を計算する
参考
取得日はいずれも 2026-11-07 です。図と数値はすべて筆者が Python(NumPy、SciPy、Matplotlib)で計算したものです。乱数のシードは固定です。
パーティクルフィルタの基本
- N. J. Gordon, D. J. Salmond, A. F. M. Smith「Novel approach to nonlinear/non-Gaussian Bayesian state estimation」(IEE Proceedings F, 140(2), 107–113, 1993)
- Genshiro Kitagawa「Monte Carlo Filter and Smoother for Non-Gaussian Nonlinear State Space Models」(Journal of Computational and Graphical Statistics, 5(1), 1–25, 1996)
- M. Sanjeev Arulampalam, Simon Maskell, Neil Gordon, Tim Clapp「A Tutorial on Particle Filters for Online Nonlinear/Non-Gaussian Bayesian Tracking」(IEEE Trans. Signal Processing, 50(2), 174–188, 2002)
- Arnaud Doucet, Simon Godsill, Christophe Andrieu「On sequential Monte Carlo sampling methods for Bayesian filtering」(Statistics and Computing, 10, 197–208, 2000)
- Dan Crisan, Arnaud Doucet「A survey of convergence results on particle filtering methods for practitioners」(IEEE Trans. Signal Processing, 50(3), 736–746, 2002)
重みとリサンプリング
- Augustine Kong, Jun S. Liu, Wing Hung Wong「Sequential Imputations and Bayesian Missing Data Problems」(JASA, 89(425), 278–288, 1994)
- Randal Douc, Olivier Cappé, Eric Moulines「Comparison of Resampling Schemes for Particle Filtering」(ISPA 2005, 64–69)
- Jeroen D. Hol, Thomas B. Schön, Fredrik Gustafsson「On Resampling Algorithms for Particle Filters」(IEEE NSSPW 2006, 79–82)
提案分布と改良
- Michael K. Pitt, Neil Shephard「Filtering via Simulation: Auxiliary Particle Filters」(JASA, 94(446), 590–599, 1999)
- Christian Musso, Nadia Oudjane, François Le Gland「Improving Regularised Particle Filters」(Sequential Monte Carlo Methods in Practice, Springer, 2001, 247–271)
- Jane Liu, Mike West「Combined Parameter and State Estimation in Simulation-Based Filtering」(Sequential Monte Carlo Methods in Practice, Springer, 2001, 197–223)
- Thomas Schön, Fredrik Gustafsson, Per-Johan Nordlund「Marginalized particle filters for mixed linear/nonlinear state-space models」(IEEE Trans. Signal Processing, 53(7), 2279–2289, 2005)
- Chris Snyder, Thomas Bengtsson, Peter Bickel, Jeff Anderson「Obstacles to High-Dimensional Particle Filtering」(Monthly Weather Review, 136(12), 4629–4640, 2008)
名前と歴史
- Nicholas Metropolis, S. Ulam「The Monte Carlo Method」(JASA, 44(247), 335–341, 1949)
- N. Metropolis「The Beginning of the Monte Carlo Method」(Los Alamos Science, Special Issue 1987, 125–130)
- J. E. Handschin, D. Q. Mayne「Monte Carlo techniques to estimate the conditional expectation in multi-stage non-linear filtering」(International Journal of Control, 9(5), 547–559, 1969)
- P. Del Moral「Non-linear filtering: interacting particle solution」(Markov Processes and Related Fields, 2(4), 555–580, 1996)
- Christian Robert, George Casella「A Short History of Markov Chain Monte Carlo: Subjective Recollections from Incomplete Data」(Statistical Science, 26(1), 102–115, 2011)
活用事例
- Michael Isard, Andrew Blake「CONDENSATION—Conditional Density Propagation for Visual Tracking」(IJCV, 29(1), 5–28, 1998)
- Sebastian Thrun, Dieter Fox, Wolfram Burgard, Frank Dellaert「Robust Monte Carlo localization for mobile robots」(Artificial Intelligence, 128, 99–141, 2001)
- Sebastian Thrun, Wolfram Burgard, Dieter Fox「Probabilistic Robotics」(MIT Press, 2005)
- Dieter Fox「Adapting the Sample Size in Particle Filters Through KLD-Sampling」(IJRR, 22(12), 985–1003, 2003)
- Nav2「AMCL」の設定(max_particles、min_particles)
- Michael Montemerlo, Sebastian Thrun, Daphne Koller, Ben Wegbreit「FastSLAM: A Factored Solution to the Simultaneous Localization and Mapping Problem」(AAAI 2002, 593–598)
- Bhaskar Saha, Kai Goebel, Scott Poll, Jon Christophersen「Prognostics Methods for Battery Health Monitoring Using a Bayesian Framework」(IEEE Trans. Instrumentation and Measurement, 58(2), 291–296, 2009)
- Fredrik Gustafsson「Particle filter theory and practice with positioning applications」(IEEE AES Magazine, 25(7), 53–82, 2010)
ライブラリ