はじめに
ゆっくり動く位置を測るセンサがあります。値には細かいノイズが乗っています。#2 のローパスフィルタ(低い周波数を通し、高い周波数を落とすフィルタ)を通すと線は滑らかになりますが、動いている間は本当の位置より遅れた値を返します。#2 で設計した 2 次バターワース(通す帯域を平らに保つ形のローパス)を、振幅が約 0.707 倍になる周波数(カットオフ)20 Hz で使うと、ゆっくりした動きに対する遅れは 11.2 ms です(#2 の比較の表にある低周波の群遅延。群遅延は、その周波数の信号が何秒遅れるかを表す量です)。カットオフを上げれば遅れは減り、ノイズは戻ります。ノイズと信号の周波数帯が重なっている限り、周波数で切り分けるフィルタではこの交換から逃れられません。
ところが、この信号について、もう 1 つ知っていることがあります。位置は速度の積分で、速度は急には変わらないという物理です。センサのノイズの大きさも、データシートから分かります。カルマンフィルタは、この 2 つの知識を式に入れて、測定値をどれだけ信じるかをサンプルごとに計算する推定器(本当の値を計算で見積もる仕組み)です。
この記事のゴールは、カルマンフィルタを「難しそうな行列の呪文」から「要件から Q と R を決めて設計できるフィルタ」に変えることです。Q と R は、モデルとセンサをどれだけ疑うかを表す数です。予測と更新の式を 1 段ずつ導き、手計算で 1 周し、ゲイン(測定をどれだけ取り込むかを決める係数)が一定になったあとの特性を #1〜#4 と同じ道具で読みます。道具は、入力と出力の比を表す伝達関数、周波数ごとの振幅と位相を描くボード線図、同じ特性を横軸が実部、縦軸が虚部の平面に描くナイキスト線図です。そうすると、よく使う相補フィルタ(得意な周波数帯が違う 2 つのセンサを 1 本の式で合わせるフィルタ)と αβ フィルタ(2 つの固定のゲインで位置と速度を追うフィルタ)が、同じ式の特別な場合だと分かります。実機は使わず、すべて計算と数値シミュレーションで示します。
- #1 基礎編 — サンプリング、伝達関数、ボード線図、効き目の測り方、C の骨格
- #2 ローパス — 移動平均、1 次 IIR、2 次バターワースを同じカットオフで比べる
- #3 ハイパス — DC とドリフトを消す
- #4 バンドパスとノッチ — Q と Audio EQ Cookbook で狙った周波数を扱う
- #5 カルマンフィルタ(この記事) — モデルと分散で切り分ける
- #6 EKF・UKF — 線形でない対象へ広げる
- #7 パーティクルフィルタ — 分布をサンプルで持つ
- #8 適応フィルタ — 入力と誤差から係数を学習する
- #9 以降 用途別のフィルタ(予定)
この記事で分かること: カルマンフィルタが何を受け取って何を返すのか、そのゲイン(カルマンゲイン)がどこから出てくるのか、Q と R が何を決めるのか、ゲインが一定になった状態(定常状態)のカルマンフィルタが周波数の上ではどんなフィルタなのか、相補フィルタや αβ フィルタとどう違うのかが分かります。
読み終えたときにできること: 等速モデル(速度が一定と見なす式)や 1 次元のモデルで、モデルの行列 A、C とノイズの大きさ Q、R を書き下し、定常ゲイン(一定になったあとのゲイン)を Python で計算し、C の約 30 行で動かせます。イノベーション(測定と予測の差)を見て、設計が合っているかを数字で判定できます。
マイコンで ADC の値を読んだことがある方を想定しています。行列の掛け算が読めれば進められます。行列の微分などの道具は、使う場所で説明します。伝達関数やボード線図は #1 基礎編 の z 変換と伝達関数、周波数応答、白色ノイズと PSD で導出しています。最初の 3 章は基礎編なしで読めます。
🧭 カルマンフィルタとは
カルマンフィルタは、ノイズを含む測定の列から、対象の今の状態を見積もるアルゴリズムです。測っていない量も、測った量とのつながりから見積もれます。1960 年に R. E. Kalman が発表し、1960 年代初めにはアポロ宇宙船の月周回航法の研究で実用の道具になりました。定義を 1 文で書くと、次のとおりです。
対象が線形の状態空間モデルに従い、ノイズが平均 0 の白色ガウスノイズだと仮定したとき、ノイズを含む測定の列から対象の状態を、推定誤差の 2 乗平均が最小になるように再帰的に推定するアルゴリズム。
1 文に語が詰まっているので、ほどきます。正確な定義は次の章で式にします。
- 状態:対象の今の様子を表す変数の組。動く物体なら位置と速度
- 線形の状態空間モデル:次の状態と測定を、今の状態の定数倍と足し算(行列の掛け算)で書いた対象の式
- 平均 0 の白色ガウスノイズ:前後のサンプルと関係がなく、0 を中心に釣り鐘の形にばらつくノイズ
- 推定誤差の 2 乗平均が最小:見積もりと本当の値の差を 2 乗して平均した値が、いちばん小さいこと
- 再帰的:1 サンプルごとに、前の結果と新しい測定だけから次の結果を作ること。過去の測定を全部取っておく必要がない
何を渡すと何が返るのか
カルマンフィルタに渡すものと、返ってくるものを並べます。表の角かっこの [n] は、n 番目のサンプル(ステップ)での値を表します。n は 0、1、2、… と進む整数のステップ番号で、サンプルの間隔(サンプリング周期)を T とすると時刻 nT に当たります(#1 の [n] と同じ記法です)。
| 区分 | もの | 中身 |
|---|---|---|
| 設計のときに渡す | モデル A、B、C | 状態の動き方と、センサに見える成分 |
| 設計のときに渡す | ノイズの大きさ Q、R | モデルとセンサをどれだけ疑うか |
| サンプルごとに渡す | 測定 y[n] | センサの値 |
| サンプルごとに渡す | 既知の入力 u[n] | モータへの指令など。なければ省く |
| サンプルごとに返る | 推定値 x̂[n] | 状態の見積もり |
| サンプルごとに返る | 不確かさ P[n] | 見積もりをどれだけ信用できるか |
#1〜#4 のフィルタの出力は、処理した値の 1 本だけでした。カルマンフィルタは推定値と一緒に、その信用度も出します。これが他のフィルタとの大きな違いです。
なぜ「フィルタ」と呼ぶのか
#1〜#4 のフィルタは、周波数で信号を選別する意味でのフィルタでした。カルマンフィルタの「フィルタ」は別の由来で、推定の問題の分類から来ています。どの時刻の状態を求めるかで、問題は 3 つに分かれます。
| 問題 | 求める状態 | 使う測定 |
|---|---|---|
| 予測 | 未来 | 現在まで |
| フィルタリング | 現在 | 現在まで |
| 平滑化 | 過去 | その時刻より後の測定も使って見直す |
カルマンフィルタが解くのは 2 行目です。切り分ける基準で言えば、#1〜#4 は周波数で切り、カルマンフィルタはモデルと分散(値のばらつきの大きさ)で切ります。
予測と更新の 2 段
アルゴリズムの中身は、サンプルごとに同じ 2 段を繰り返すだけです。
- 予測:モデルで状態を 1 サンプル進める。モデルは完全ではないので、不確かさを足す
- 更新:測定と予測の差に、ゲイン K(差のうちどれだけを取り込むかを決める係数)を掛けて推定値へ戻す。K は予測と測定の不確かさの比から決まり、予測が不確かなほど測定を信じ、測定が不確かなほど予測を信じる
処理の流れを図にすると、次のループです。図の x̂⁻ と P⁻ は予測の段で作る推定値と不確かさで、肩の − は「今の測定を入れる前」の印です。更新を終えた値は、印のない x̂ と P です。
更新の結果は、次のサンプルの出発点になります。1 周に使うのは前の結果と今の測定だけで、これが定義の「再帰的」の中身です。
知らない道を、歩数から自分の位置を推測しながら歩くとします。歩幅にはばらつきがあるので、歩くほど推測は不確かになります(予測)。ときどき見える目印で、位置を直します(更新)。目印がはっきり見えれば大きく直し、遠くてぼんやりしていれば少しだけ直します。推測と目印のどちらをどれだけ信じるかを、両方の不確かさから計算で決めるのがカルマンフィルタです。
前提と、その下で言えること
カルマンフィルタの式が最良になるのは、次の 4 つがそろうときです。
- 線形:状態と測定の関係が、行列の掛け算で書ける
- ガウス:ノイズがガウス分布に従う
- 白色:ノイズが前後のサンプルと無関係で、平均が 0
- 既知:ノイズの大きさ Q と R が分かっている
この前提の下で、次のことが言えます。ここでの分散は推定誤差の分散で、誤差の平均が 0 なので 2 乗平均と同じ値です。
- ノイズがガウス分布なら、線形でない計算まで含めたあらゆる推定の中で、分散が最小
- ガウス分布でなくても、測定の 1 次式で作れる推定(線形の推定)の中では、分散が最小
前提が崩れると、この最良の性質は失われます。Q と R が合わないときに起きることは「落とし穴」で、線形でない対象は次回 #6 の EKF と UKF(カルマンフィルタを線形でない対象へ広げた方法)で扱います。
制御工学の言葉では、カルマンフィルタは状態観測器(オブザーバ。入力と出力から内部の状態を見積もる仕組み)の一種で、測定の差を戻すゲインをノイズの統計から決めたものです。
📘 最初に道具を 4 つだけ
定義に出てきた言葉を、式で扱える形にします。使う道具は、状態空間表現、ガウス分布と共分散、推定値と誤差共分散、白色ノイズの共分散 Q と R の 4 つです。
状態と状態空間表現
状態は、「未来を決めるのに必要十分な、今の値の組」です。今の状態とこれからの入力が分かれば、それより過去の値は要りません。対象の記憶の中身と言ってもかまいません。#1〜#4 では入力と出力の関係だけを見てきましたが、ここからは対象の中身を変数で持ちます。たとえば等速で動く物体なら、位置だけでは次の位置が決まらず、位置と速度の 2 つがそろえば決まります。余分な変数は要らないので、この 2 つを状態に選びます。
なぜ行列の式で書けるのか。 いちばん小さい例から始めます。#1 の 1 次 IIR(過去の出力を戻す、指数移動平均の形のフィルタ)を、入力を u、出力を y として書きます。
y[n] = y[n-1] + \alpha\,(u[n] - y[n-1])このフィルタが覚えている値は、1 つ前の出力だけです。つまり状態は出力そのもので、1 個です。添字を 1 つ進めて整理すると、右辺の入力は u[n+1] になります。ところが状態方程式の右辺には、今の状態と今の入力だけを置きます。そこで、入力 u[n] を受け取った時点で次の状態を計算し、出力に出すのは 1 サンプル後にする、という約束のフィルタに置き換えます。元のフィルタとの違いは、この 1 サンプルの遅れだけです。
\begin{gathered} x[n+1] = (1-\alpha)\,x[n] + \alpha\,u[n] \\ y[n] = x[n] \end{gathered}「次の値 = 定数 × 今の値 + 定数 × 入力」と「出力 = 定数 × 今の値」の 2 本です。A = 1 − α、B = α、C = 1 と読めます。
状態が 2 個でも同じです。等速で動く物体の位置を p、速度を \dot{p} (p の上の点は時間微分の印)、サンプリング周期を T とします。次の位置は今の位置に T × 速度を足した値で、速度はそのままです。
\begin{gathered} p[n+1] = p[n] + T\,\dot{p}[n] \\ \dot{p}[n+1] = \dot{p}[n] \end{gathered}2 つを縦に並べると、数の掛け算が行列の掛け算に変わるだけで、同じ形です。
\begin{bmatrix} p[n+1] \\ \dot{p}[n+1] \end{bmatrix} = \begin{bmatrix} 1 & T \\ 0 & 1 \end{bmatrix}\begin{bmatrix} p[n] \\ \dot{p}[n] \end{bmatrix}高い次数でも事情は変わりません。#1 の biquad(2 次の IIR の基本ブロック)は 2 つ前までの入力と出力を使いますが、覚えている過去の値を 1 本のベクトルに並べて状態とすれば、1 サンプル進めるのは「値を 1 つずらして、新しい値を線形に計算する」操作になります。そのため、有限の次数の線形な差分方程式は、どれも「1 サンプル先の状態 = 今の状態の 1 次式 + 入力の 1 次式」の形(1 次のベクトル差分方程式)に直せます。次数の高さが、状態の数に置き換わるわけです。
この形にノイズの項を足し、測定の式を添えたものが状態空間表現です。
x[n+1] = A\,x[n] + B\,u[n] + w[n] y[n] = C\,x[n] + v[n]上の式を状態方程式、下の式を観測方程式と呼びます。記号は次のとおりです。大きさの欄の N は状態の数、M は測定の数、L は入力の数です。
| 記号 | 意味 | 大きさ |
|---|---|---|
| n | サンプル番号(ステップ番号)。#1 の [n] と同じで、時刻 nT を表す | 整数 |
| x[n] | 状態。状態の変数を縦に並べたベクトル | N × 1 |
| y[n] | 測定値。センサが返す値 | M × 1 |
| u[n] | 既知の入力。モータへの指令など | L × 1 |
| w[n] | プロセスノイズ。モデルが表しきれない動き | N × 1 |
| v[n] | 観測ノイズ。センサの誤差 | M × 1 |
| A | 状態を 1 サンプル先へ進める行列 | N × N |
| B | 入力が状態へ効く行列 | N × L |
| C | 状態のどの成分がセンサに見えるかを表す行列 | M × N |
どこから出てくるのか。 物理の微分方程式や回路の方程式を、1 階の微分だけの連立に直したものが状態方程式の元です。たとえば d^2p/dt^2 = a は 2 階の微分ですが、速度を別の変数にすれば 1 階の式 2 本になります。コイルとコンデンサの回路なら、コイルの電流とコンデンサの電圧が 2 つの状態です。次の章で、この 1 階の連立から離散時間の A を導きます。
状態方程式は、#1 の伝達関数 H(z) と別の対象を扱う式ではありません。伝達関数は入力と出力の比だけを見た書き方で、状態方程式は同じ系の中身まで見た書き方です。ノイズを除いた式を z 変換すると、次の 1 行で対応します。
H(z) = C\,(zI - A)^{-1}BI は単位行列(数の 1 に当たる行列)で、肩の −1 は逆行列(数の割り算に当たる操作)です。1 次 IIR の A、B、C を入れると H(z) = \alpha/(z-1+\alpha) = \alpha z^{-1}/(1-(1-\alpha)z^{-1}) で、#1 の伝達関数に、上で決めた約束の 1 サンプルの遅れ z^{-1} を掛けたものと一致します。
なぜ w と v を足すのか。 ここまでの式は、モデルが完全で、センサにも誤差がない場合です。現実にはどちらも成り立たないので、プロセスノイズ w と観測ノイズ v を足します。2 つを別の項にするのは、性質が違うからです。w は状態の中に入り込んで次のサンプルへ持ち越されます。v はその場の測定値だけを乱し、状態には残りません。カルマンフィルタは、この 2 つを後で出てくる Q と R として別々に扱い、どちらをどれだけ信じるかを決めます。
ガウス分布と共分散
ガウス分布は、平均のまわりに値が多く、離れるほど少なくなる釣り鐘形の分布です。平均 m、分散 σ² の確率密度は次の式です。
p(x) = \frac{1}{\sqrt{2\pi\sigma^2}}\exp\!\left(-\frac{(x-m)^2}{2\sigma^2}\right)分散 σ² は平均からのずれの 2 乗の平均で、その平方根が標準偏差 σ です。ガウス分布では、値の約 68 % が ±σ、約 99.7 % が ±3σ の帯に入ります。この記事の時間波形の図に出てくる帯は ±3σ です。手計算の節に出てくる共分散の楕円だけは、±1σ の範囲で描いています。
変数が 2 つ以上あるときは、それぞれの分散のほかに、2 つが連動する度合いも必要です。これが共分散で、記号 E を平均を取る操作として次の式で定義します。
\mathrm{Cov}(x_1, x_2) = E\left[(x_1 - m_1)(x_2 - m_2)\right]x_1 が大きいときに x_2 も大きい傾向があれば共分散は正、逆なら負、無関係なら 0 です。分散と共分散を並べた行列を共分散行列と呼びます。対角成分(左上から右下の斜めの要素)がそれぞれの分散で、それ以外が共分散です。式の e は、それぞれの変数の平均からのずれを縦に並べたベクトルです(次の小節では、これが推定誤差になります)。
\begin{aligned} P &= E\left[e\,e^{\mathsf{T}}\right] \\ &= \begin{bmatrix} \sigma_1^2 & \mathrm{Cov}(x_1,x_2) \\ \mathrm{Cov}(x_1,x_2) & \sigma_2^2 \end{bmatrix} \end{aligned}肩の \mathsf{T} は転置で、行と列を入れ替える操作です。縦ベクトル e と横ベクトル e^{\mathsf{T}} の積は、2 乗の表を作る掛け算です。共分散行列はいつも対称で、対角成分は負になりません。
推定値と誤差共分散
状態の本当の値は誰にも見えません。計算で求めた見積もりを推定値と呼び、ハットを付けて \hat{x} と書きます。本当の値との差 e = x - \hat{x} を推定誤差と呼び、その共分散行列 P を誤差共分散と呼びます。P が小さいほど、推定に自信があるという意味です。
カルマンフィルタは、推定値を 2 段階で持ちます。
- \hat{x}^-[n] 、 P^-[n] :時刻 n の測定を入れる前の見積もり(予測)
- \hat{x}[n] 、 P[n] :時刻 n の測定を入れたあとの見積もり(更新)
上付きの − は「測定の前」の印です。
白色ノイズの共分散 Q と R
#1 の白色ノイズと同じ語です。白色は、すべての周波数に同じパワーが乗っていて、どのサンプルも前後のサンプルと相関がないことを表します。相関は 2 つの値がどれだけ連動するかを表す量で、白色なら異なる時刻どうしの共分散が 0 です。カルマンフィルタは w[n] と v[n] をどちらも平均 0 の白色ノイズとし、次の共分散を与えます。
Q = E\left[w\,w^{\mathsf{T}}\right],\quad R = E\left[v\,v^{\mathsf{T}}\right]Q はモデルをどれだけ疑うか、R はセンサをどれだけ疑うかを表す数字です。w と v は互いに独立(片方の値が分かっても、もう片方の手がかりにならない)とします。設計者が決める値は、ほぼこの 2 つだけです。
道具がそろいました。次の章では、状態空間表現の A と Q を物理の式から導きます。
📐 連続時間から離散時間へ
この記事では、マイコンで一定の周期ごとに計算することを想定するので、離散時間の A と Q を使います。一方、物理の法則は微分方程式で書かれています。#1 で RC の微分方程式から差分方程式を作ったのと同じ橋渡しを、状態空間で行います。題材は、この記事でずっと使う等速モデルです。
連続時間の状態方程式
位置を p とします。速度はその時間微分 \dot{p} (p の上の点は時間微分の印)で、加速度を a とします。速度は加速度の積分なので、次の 2 本が成り立ちます。
\frac{dp}{dt} = \dot{p},\quad \frac{d\dot{p}}{dt} = a「等速」と言っても加速度を 0 と決めるわけではなく、平均が 0 のランダムな加速度が加わる、と考えます。物体は基本的に同じ速度で動き、ときどき予想外に速度が変わる、という見方です。状態を x = [\,p\ \ \dot{p}\,]^{\mathsf{T}} と置くと、1 本の行列の式になります。
\begin{gathered} \frac{dx}{dt} = F\,x + G\,a \\ F = \begin{bmatrix} 0 & 1 \\ 0 & 0 \end{bmatrix},\quad G = \begin{bmatrix} 0 \\ 1 \end{bmatrix} \end{gathered}F は連続時間で状態を変化させる行列で、離散時間の A に当たります。G は加速度がどの状態に入るかを表す列ベクトルで、ここでは速度の段にだけ入ります。
A を導く
1 次の微分方程式 \dot{x} = s\,x の解は x(t+T) = e^{sT}x(t) でした。これが #1 と #2 で使った z = e^{sT} の出どころです。行列でも同じ形が成り立ち、加速度の項を含めた解は次のようになります。 e^{FT} は行列指数関数で、 e^{x} = 1 + x + x^2/2! + \cdots の x に行列を入れて定義します。λ は、時刻 t から測った区間の中の時間を表す積分の変数です。
\begin{aligned} x(t+T) = {} & e^{FT}x(t) \\ & + \int_0^T e^{F(T-\lambda)}\,G\,a(t+\lambda)\,d\lambda \end{aligned} e^{FT} = I + FT + \frac{(FT)^2}{2!} + \cdotsこれは指数関数の級数の展開と同じ形です。I は単位行列(数の 1 に当たる行列で、対角成分が 1、それ以外が 0)です。今の F は 2 乗すると 0 行列になるので、展開は 2 項で止まります。
A = e^{FT} = I + FT = \begin{bmatrix} 1 & T \\ 0 & 1 \end{bmatrix}1 行目は「次の位置 = 今の位置 + T × 速度」、2 行目は「速度はそのまま」で、等速の直感どおりです。A の固有値は 2 つとも 1 で、F の固有値 0 が z = e^{0\cdot T} = 1 に移ったものです。固有値は、行列を掛けても向きの変わらないベクトルが何倍になるかを表す数で、状態空間では伝達関数の極(分母を 0 にする z)に当たります。2 個の積分器は z = 1 の重なった 2 個の極になります。
Q を導く
次はプロセスノイズです。上の解の積分の項が w[n] に当たります。被積分関数の中身は、F の 2 乗が 0 なので次の形です。
\begin{aligned} e^{F(T-\lambda)}\,G &= \begin{bmatrix} 1 & T-\lambda \\ 0 & 1 \end{bmatrix}\begin{bmatrix} 0 \\ 1 \end{bmatrix} \\ &= \begin{bmatrix} T-\lambda \\ 1 \end{bmatrix} \end{aligned}ここで、加速度の扱いが 2 通りあります。この記事では、#2 のゼロ次ホールド(次の更新まで値を保つこと)と同じ考え方で、加速度は 1 サンプルの間だけ一定で、サンプルごとに独立に変わるとします。一定値 a[n] を積分の外へ出すと、次の式になります。
\begin{aligned} w[n] &= \int_0^T \begin{bmatrix} T-\lambda \\ 1 \end{bmatrix} d\lambda\ \ a[n] \\ &= \begin{bmatrix} T^2/2 \\ T \end{bmatrix} a[n] = \Gamma\,a[n] \end{aligned}位置へは aT^2/2 、速度へは aT が足されるという、等加速度の公式そのものです。 a[n] の分散を \sigma_a^2 とすると、Q は \Gamma\Gamma^{\mathsf{T}} に分散を掛けた次の行列です。
Q = \sigma_a^2\,\Gamma\Gamma^{\mathsf{T}} = \sigma_a^2\begin{bmatrix} T^4/4 & T^3/2 \\ T^3/2 & T^2 \end{bmatrix}非対角の成分(対角以外の成分)が正なのは、同じ加速度が位置と速度を同じ向きへ動かすからです。
もう 1 つの扱いは、加速度を連続時間の白色ノイズとするものです。パワースペクトル密度を q とすると、異なる時刻の値が無相関なので、積分の中で 2 乗を取れます。
\begin{aligned} Q_c &= q\int_0^T \begin{bmatrix} T-\lambda \\ 1 \end{bmatrix}\begin{bmatrix} T-\lambda & 1 \end{bmatrix} d\lambda \\ &= q\begin{bmatrix} T^3/3 & T^2/2 \\ T^2/2 & T \end{bmatrix} \end{aligned}T^4/4 の形と T^3/3 の形は、別のモデルから出た別の式です。ゼロ次ホールドの形は Q の行列の階数(独立な行の数)が 1 で、後の章で使う閉じた式が出るので、この記事ではこちらを使います。
観測の式
センサは位置だけを測るとします。観測方程式は次のとおりです。
\begin{gathered} y[n] = C\,x[n] + v[n] \\ C = \begin{bmatrix} 1 & 0 \end{bmatrix} \end{gathered}R はセンサのノイズの分散 \sigma_v^2 です。これで、等速モデルの A、C、Q、R がそろいました。B は入力がないので使いません。
行列の式に入る前に、次の章では状態が 1 つだけの場合で、カルマンフィルタの骨格を導きます。
1️⃣ 1 次元から始める
1 つの値を、ノイズのあるセンサで繰り返し測る場面を考えます。行列がいらないので、式の意味がそのまま見えます。モデルは A = 1、C = 1 で、B はありません。
\begin{gathered} x[n+1] = x[n] + w[n] \\ y[n] = x[n] + v[n] \end{gathered}w の分散が Q、v の分散が R です。Q = 0 なら x は定数、Q > 0 ならランダムに少しずつ動く値(ランダムウォーク)です。
予測
時刻 n − 1 の更新のあと、x は平均 \hat{x}[n-1] 、分散 P[n-1] のガウス分布に従うと見積もっています。状態方程式で 1 サンプル進めると、平均は w の平均が 0 なのでそのままです。分散は、独立な量を足すと分散も足し算になるので、Q だけ増えます。
\begin{gathered} \hat{x}^-[n] = \hat{x}[n-1] \\ P^-[n] = P[n-1] + Q \end{gathered}測定がなければ、時間とともに不確かさが増えていく、という式です。
更新:2 つのガウス分布の積
測定 y が来ました。手元には、予測の分布と、「測定が y だったなら真の値はこのあたり」という分布の 2 つがあります。この 2 つを合わせる規則がベイズの定理で、測定を見たあとの確率は、測定を見る前の確率と、その値のときに測定 y が出る確率の積に比例します。
p(x \mid y) \propto p(y \mid x)\,p(x)縦棒の右は「それが分かっているとき」の条件で、記号 ∝ は比例を表します。右辺はどちらもガウス分布です。指数の中身を足すと、x の 2 次式になります。ここでは時刻 n を省いて書きます。
-\frac{(x-\hat{x}^-)^2}{2P^-} - \frac{(y-x)^2}{2R}x の 2 次の係数と 1 次の係数をまとめます。
\begin{aligned} & -\frac{1}{2}\left(\frac{1}{P^-}+\frac{1}{R}\right)x^2 \\ & + \left(\frac{\hat{x}^-}{P^-}+\frac{y}{R}\right)x + (\text{定数}) \end{aligned}ガウス分布の指数は -(x-m)^2/(2P) で、展開すると 2 次の係数が -1/(2P) 、1 次の係数が m/P です。係数を比べると、合わさった分布もガウス分布で、分散 P と平均 \hat{x} は次の値です。
\frac{1}{P} = \frac{1}{P^-} + \frac{1}{R},\quad \hat{x} = P\left(\frac{\hat{x}^-}{P^-} + \frac{y}{R}\right)分散の逆数は精度と呼ばれ、情報の量を表します。1 行目は「情報は足し算」、2 行目は「精度で重みを付けた平均」と読めます。
このままでも計算できますが、差の形に直すと実装に向きます。1 行目から P = P^- R/(P^- + R) です。次の K を定義します。
K = \frac{P^-}{P^- + R}すると P/P^- = R/(P^-+R) = 1 - K 、 P/R = K なので、更新の式は次の 2 本になります。
\begin{aligned} \hat{x} &= (1-K)\,\hat{x}^- + K\,y \\ &= \hat{x}^- + K\,(y - \hat{x}^-) \end{aligned} P = (1 - K)\,P^-この K がカルマンゲインです。 y - \hat{x}^- は測定と予測の差で、イノベーション(新しく入ってきた情報)と呼びます。予測が測定より不確かなら( P^- \gg R )K は 1 に近づいて測定を信じ、測定が不確かなら( R \gg P^- )K は 0 に近づいて予測を信じます。K が正なら 1 - K は 1 より小さいので、測定を入れると不確かさは減ります。
Q = 0 なら K は 1/n で、平均と一致する
まず定数を測る場合です。Q = 0 では予測で分散が増えないので、更新のたびに精度が 1/R ずつ増えます。
\frac{1}{P[n]} = \frac{1}{P[0]} + \frac{n}{R}最初は何も分からない、つまり P[0] \to \infty とすると P[n] = R/n です。K の式に P^-[n] = P[n-1] = R/(n-1) を入れると、次の値になります。
K[n] = \frac{R/(n-1)}{R/(n-1) + R} = \frac{1}{n}更新の式 \hat{x}[n] = \hat{x}[n-1] + (y[n] - \hat{x}[n-1])/n の両辺に n を掛けると、 n\,\hat{x}[n] = (n-1)\,\hat{x}[n-1] + y[n] です。これは「ここまでの合計に今の値を足す」式なので、 \hat{x}[n] は n 個の平均そのものです。定数を測るカルマンフィルタは、平均を 1 個ずつ積み上げる計算でした。分散 R/n も、平均の標準偏差が \sigma/\sqrt{n} になるという統計の基本と一致します。
Q > 0 なら K は定常値に止まる
値が動くなら、古い測定は当てにならなくなるので、K は 0 まで落ちないはずです。予測の式と更新の式をつなぐと、 P^- だけの漸化式になります。
P^-[n+1] = \frac{P^-[n]\,R}{P^-[n] + R} + Qこの形の、共分散を次のサンプルへ送る分数の漸化式をリカッチ方程式と呼びます。十分に時間がたつと P^- は一定の値に落ち着きます。この落ち着いた状態を定常状態、そのときのゲインを定常ゲインと呼びます。 P^-[n+1] = P^-[n] = P^- と置いて分母を払うと、2 次方程式になります。
(P^-)^2 - Q\,P^- - QR = 0 P^- = \frac{Q + \sqrt{Q^2 + 4QR}}{2}正の解だけを取りました。 r = Q/R と置いて K の式へ入れて整理すると、定常ゲインは r だけの式になります。
K_\infty = \frac{-r + \sqrt{r^2 + 4r}}{2}Q と R を同じ倍率で変えても、 P^- が同じ倍率で変わるだけで K は変わりません。定常ゲインを決めるのは Q/R の比だけです。 r が小さいときは K_\infty \approx \sqrt{r} です。定常状態では P = K_\infty R も成り立ちます。
| Q/R | 定常ゲイン K | 時定数(サンプル) |
|---|---|---|
| 0.0001 | 0.00995 | 100 |
| 0.001 | 0.0311 | 32 |
| 0.01 | 0.0951 | 10 |
| 0.1 | 0.270 | 3.2 |
| 1 | 0.618 | 1.0 |
表の時定数は、入力を一度に変えたあと、出力が 63 %( 1 - e^{-1} )追いつくまでの時間です。定常ゲインでは、残りの差が 1 サンプルごとに 1-K 倍になるので、 (1-K)^n = e^{-1} を解いた次の値です。
n = \frac{-1}{\ln(1-K)}K が小さければ 1/K に近づきます。よく似た (1-K)/K は #2 の 1 次 IIR の低周波の群遅延で、63 % の時間とは少し違います。#2 の例でも、群遅延の 7.5 ms に対して 63 % の時間は 8 ms でした。
この様子を計算したのが次の図です。左はゲインの推移です。右の 2 段は、Q = 0 と Q > 0 の推定値と ±3σ の帯です。見るのは、Q = 0 の線が 1/n の破線に重なることと、Q > 0 の線が点線の定常値で止まることです。
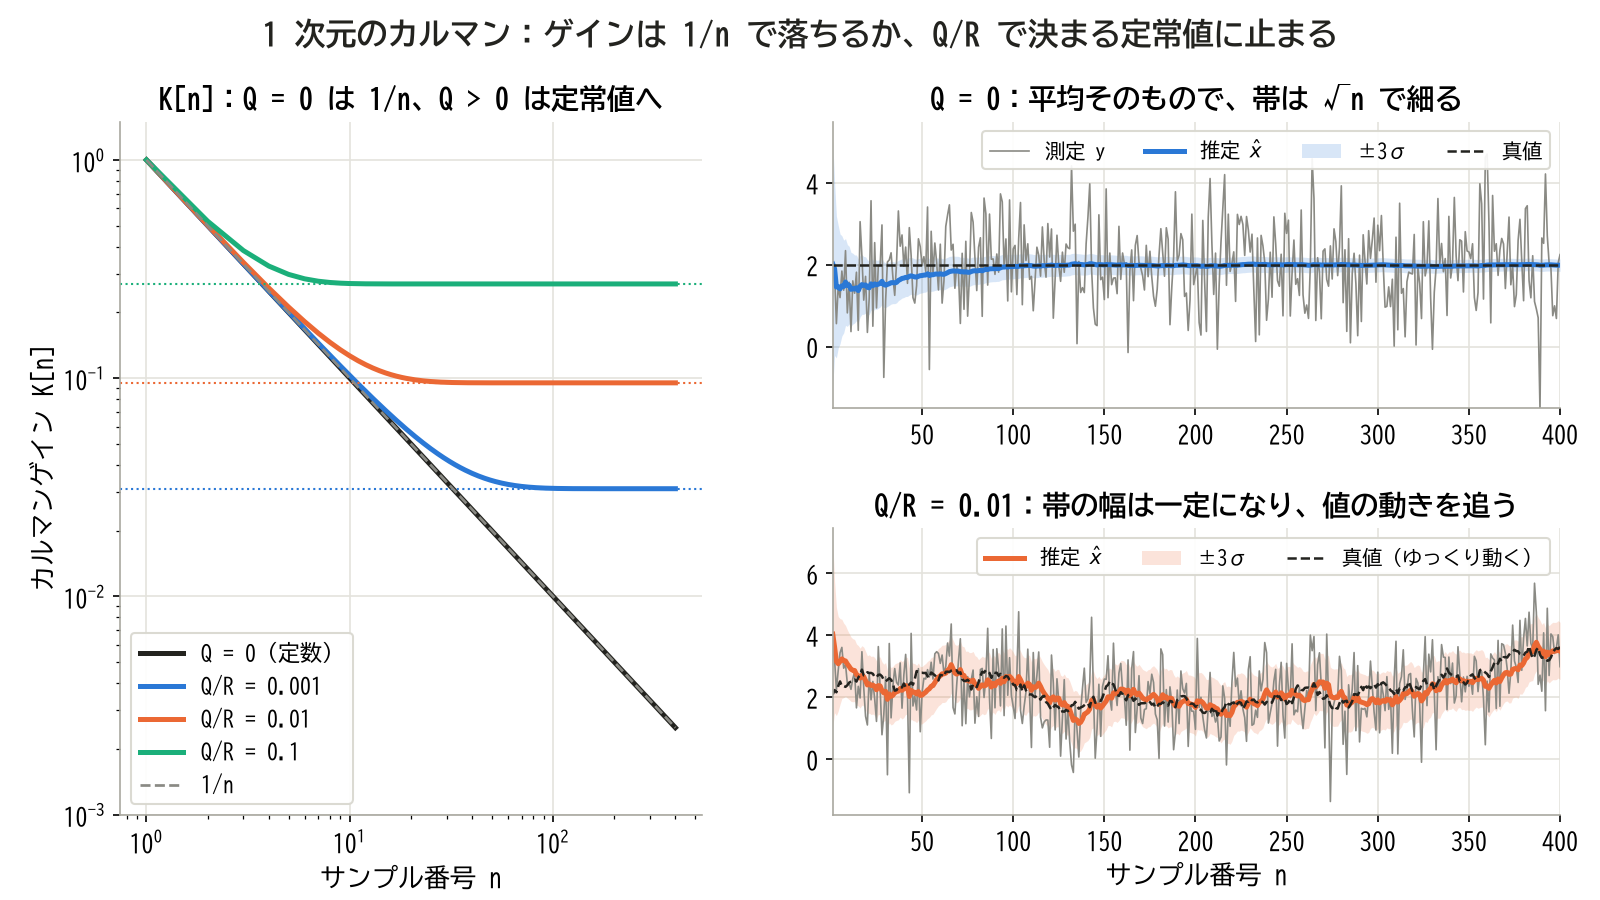
Q = 0 の黒線は 1/n の破線に重なる。Q > 0 の線は Q/R で決まる定常値(点線)で止まる。右上の帯は細り続け、右下の帯は一定の幅に落ち着く
右上の推定値は、同じデータの累積平均と 1×10⁻⁶ 以内で一致しました。P[0] を有限の値 10⁶ にしたぶんの差です。右下は Q/R = 0.01 で、定常ゲイン 0.0951 の式どおりの値に止まっています。
定常カルマンは #2 の 1 次 IIR と同じ形
K が一定になったあとの更新の式を、時刻を付けて書き直します。
\hat{x}[n] = \hat{x}[n-1] + K\,(y[n] - \hat{x}[n-1])これは #2 の 1 次 IIR(過去の出力を戻す、指数移動平均の形のフィルタ)、 y[n] = y[n-1] + \alpha(x[n] - y[n-1]) と同じ式です(入出力の文字が入れ替わっています)。 \alpha = K_\infty なので、#2 の式で α を選ぶことは Q/R を選ぶことと同じです。定常ゲインの式を逆に解くと Q/R = K^2/(1-K) なので、振幅が −3 dB(約 0.707 倍)になる周波数が 20 Hz の α = 0.11794 は、Q/R = 0.0158 に当たります。
「ランダムウォークする値に白色ノイズが乗っている」という前提のもとでは、1 次 IIR は 2 乗平均の誤差が最小のフィルタです。α を勘で決めていたときも、実は Q/R の比を選んでいたことになります。
1 次元で骨格が見えました。予測で不確かさを足し、更新で K を掛けて戻す。次の章では、この 2 段を行列に広げます。
🧮 多次元のカルマンフィルタ
状態が 2 つ以上になっても、手順は同じです。違いは、不確かさが行列になり、測っていない変数にも測定の情報が伝わることです。
5 本の式
式を先に示します。 \hat{x} と P が前の時刻の更新の結果です。1 次元のときと同じように、予測 2 本と更新 3 本の 5 本です。記法は Welch と Bishop の入門書に合わせ、観測行列だけ、伝達関数の H と区別するために C と書きます。
予測(時間を 1 つ進める)
\hat{x}^-[n] = A\,\hat{x}[n-1] + B\,u[n-1] P^-[n] = A\,P[n-1]\,A^{\mathsf{T}} + Q更新(測定を入れる)
K[n] = P^-[n]\,C^{\mathsf{T}}\left(C\,P^-[n]\,C^{\mathsf{T}} + R\right)^{-1} \hat{x}[n] = \hat{x}^-[n] + K[n]\left(y[n] - C\,\hat{x}^-[n]\right) P[n] = \left(I - K[n]\,C\right)P^-[n]肩の −1 は逆行列(掛けると単位行列になる行列)で、数の割り算に当たります。測定が 1 個ならカッコの中はただの数です。「カルマンフィルタとは」で図にした 2 段のループの、箱の中身がこの 5 本です。
行列の大きさは、状態の数を N、測定の数を M として次のとおりです。
| 記号 | 大きさ | 意味 |
|---|---|---|
| x̂、x̂⁻ | N × 1 | 状態の推定値 |
| P、P⁻、Q、A | N × N | 誤差共分散、プロセスノイズ、状態遷移 |
| y | M × 1 | 測定 |
| R、S | M × M | 観測ノイズ、イノベーションの共分散 |
| C | M × N | 状態から測定への変換 |
| K | N × M | カルマンゲイン |
S は「更新の 3 本を導く」で定義します。
予測の 2 本を導く
状態方程式から予測の式を引くと、誤差の式が出ます。予測の誤差を e^-[n] = x[n] - \hat{x}^-[n] と書きます。 \hat{x}^- の式では w を平均の 0 で置くので、既知の入力 u の項は消えて、次の形です。
e^-[n] = A\,e[n-1] + w[n-1]P^- = E[e^- (e^-)^{\mathsf{T}}] にこの式を入れて展開します。 e[n-1] は過去の測定だけで決まるので、新しい w とは独立で、掛け合わせの平均は 0 です。残るのは 2 項です。
\begin{aligned} P^- &= A\,E[e\,e^{\mathsf{T}}]\,A^{\mathsf{T}} + E[w\,w^{\mathsf{T}}] \\ &= A\,P\,A^{\mathsf{T}} + Q \end{aligned}1 次元の P^- = P + Q が、行列に広がった形です。
更新の 3 本を導く
更新の式は、予測に「測定との差の K 倍」を足す形に決めます。ガウス分布の場合はこの形が 1 次元のときと同じくベイズの定理から出ます。ガウス分布でない場合でも、測定の 1 次式で作れる推定の中ではこの形が最良です。残る問題は、どの K がいちばん良いかです。「良い」の基準を、推定誤差の分散の合計を最小にすることとします(最小分散の基準)。分散の合計は、共分散行列の対角成分の和で、これを行列のトレース tr P と書きます。
手順 1:更新後の誤差を K で表します。 y = Cx + v を更新の式へ入れて、x から引きます。
\begin{aligned} e &= x - \hat{x}^- - K(Cx + v - C\hat{x}^-) \\ &= (I - KC)\,e^- - K\,v \end{aligned}手順 2:共分散を取ります。 e^- と v は独立なので、交差項は消えます。
\begin{aligned} P = {} & (I - KC)\,P^-\,(I - KC)^{\mathsf{T}} \\ & + K R K^{\mathsf{T}} \end{aligned}手順 3:展開します。イノベーションの共分散を次の S と置きます。 y - C\hat{x}^- = Ce^- + v の共分散なので、予測の不確かさと測定の不確かさの和です。
S = C\,P^-\,C^{\mathsf{T}} + R \begin{aligned} P = {} & P^- - K C P^- \\ & - P^- C^{\mathsf{T}} K^{\mathsf{T}} + K S K^{\mathsf{T}} \end{aligned}手順 4:トレースを K で微分して 0 と置きます。行列の微分は、要素ごとに微分して同じ形に並べたものです。ここで使う公式は 2 つで、 \partial\,\mathrm{tr}(KB)/\partial K = B^{\mathsf{T}} と、対称な S に対する \partial\,\mathrm{tr}(KSK^{\mathsf{T}})/\partial K = 2KS です。2 つ目は、数の微分の d(k^2 s)/dk = 2ks に当たります。 \mathrm{tr}(KCP^-) と \mathrm{tr}(P^-C^{\mathsf{T}}K^{\mathsf{T}}) は転置の関係にあって値が等しいので、1 次の項は 2 倍になります。
\frac{\partial\,\mathrm{tr}P}{\partial K} = -2P^- C^{\mathsf{T}} + 2KS = 0 K = P^- C^{\mathsf{T}} S^{-1}カルマンゲインの式が出ました。1 次元で A = C = 1 とすれば K = P^-/(P^-+R) に戻ります。
手順 5:この K を手順 3 へ入れます。 KS = P^- C^{\mathsf{T}} なので KSK^{\mathsf{T}} = P^- C^{\mathsf{T}} K^{\mathsf{T}} となり、3 項目と 4 項目が打ち消し合います。
P = P^- - KCP^- = (I - KC)\,P^-これで 5 本がそろいました。Kalman の 1960 年の論文は、同じ結果を直交射影(推定誤差がそれまでの測定のどの 1 次式とも相関しない、という条件で最良の推定を定める考え方)から導いています。
手順 2 の式 P = (I-KC)P^-(I-KC)^{\mathsf{T}} + KRK^{\mathsf{T}} を Joseph 形と呼びます。正しい K なら (I-KC)P^- と同じ値ですが、2 つの項が対称な正の量の和なので、丸め誤差があっても対称性と非負の性質を保ちやすい形です。実装の話は「落とし穴」で扱います。
手計算で 1 ステップ回す
等速モデルに数字を入れて、5 本の式を手で 1 周します。#1 の 2 点平均の手計算 と同じ趣旨です。GNSS(衛星測位)のように 1 秒ごとに位置が届く場面を想定し、切りのよい値を選びます。
- T = 1 s、 \sigma_a = 1 m/s²、R = 1 m²
- 出発点: \hat{x}[0] = [\,0\ \ 1\,]^{\mathsf{T}} (位置 0 m、速度 1 m/s)、 P[0] = I
- 測定:y[1] = 1.5 m
A と Q は次の値です。
A = \begin{bmatrix} 1 & 1 \\ 0 & 1 \end{bmatrix},\quad Q = \begin{bmatrix} 0.25 & 0.5 \\ 0.5 & 1 \end{bmatrix}① 状態の予測。 速度 1 m/s で 1 秒進むので、位置は 1 m です。
\hat{x}^-[1] = A\,\hat{x}[0] = \begin{bmatrix} 1 \\ 1 \end{bmatrix}② 共分散の予測。 まず APA^{\mathsf{T}} を計算し、Q を足します。
\begin{gathered} A\,I\,A^{\mathsf{T}} = \begin{bmatrix} 2 & 1 \\ 1 & 1 \end{bmatrix} \\ P^-[1] = \begin{bmatrix} 2.25 & 1.5 \\ 1.5 & 2 \end{bmatrix} \end{gathered}出発点では 0 だった非対角が 1.5 になりました。速度の不確かさが、位置の不確かさと連動するようになったという意味です。
③ ゲイン。 C = [1 0] なので、 CP^-C^{\mathsf{T}} は左上の 2.25、 P^-C^{\mathsf{T}} は左の列です。
\begin{gathered} S = 2.25 + 1 = 3.25 \\ K = \frac{1}{3.25}\begin{bmatrix} 2.25 \\ 1.5 \end{bmatrix} = \begin{bmatrix} 0.6923 \\ 0.4615 \end{bmatrix} \end{gathered}④ 状態の更新。 イノベーションは 1.5 − 1 = 0.5 m です。
\begin{aligned} \hat{x}[1] &= \begin{bmatrix} 1 \\ 1 \end{bmatrix} + \begin{bmatrix} 0.6923 \\ 0.4615 \end{bmatrix} \times 0.5 \\ &= \begin{bmatrix} 1.346 \\ 1.231 \end{bmatrix} \end{aligned}速度は測っていないのに、1 から 1.231 へ変わりました。「思ったより先にいた」という測定が、非対角の項を通じて「思ったより速かった」に変換されたのです。
⑤ 共分散の更新。 I - KC は左の列だけが変わる行列です。
\begin{aligned} P[1] &= \begin{bmatrix} 0.3077 & 0 \\ -0.4615 & 1 \end{bmatrix}\begin{bmatrix} 2.25 & 1.5 \\ 1.5 & 2 \end{bmatrix} \\ &= \begin{bmatrix} 0.6923 & 0.4615 \\ 0.4615 & 1.3077 \end{bmatrix} \end{aligned}位置の分散は 2.25 から 0.69 へ、速度の分散も 2 から 1.31 へ減りました。計算の結果は対称で、Joseph 形で計算した値とも一致します。
この 1 周を図にしたのが次の楕円です。楕円は共分散行列が表す ±1σ の範囲で、横に広いほど位置が不確か、縦に広いほど速度が不確か、傾いているほど 2 つが連動していることを表します。真ん中の図で楕円が傾く理由と、右の図で縦方向も縮む理由を見てください。
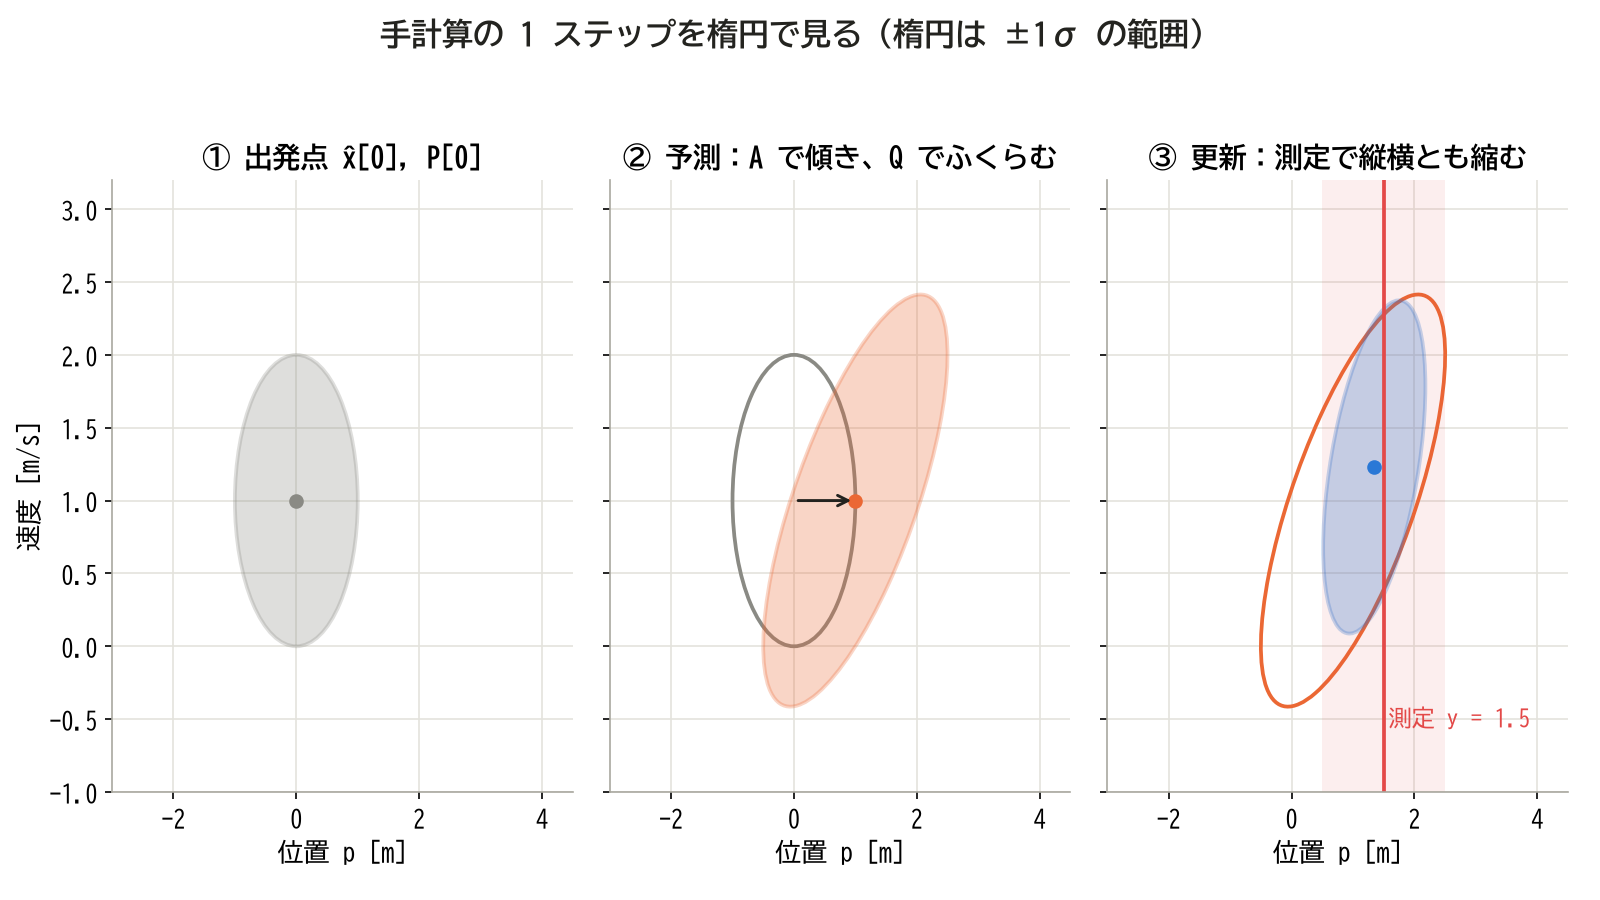
予測では速い側ほど先へ進むので楕円が傾く。測定は横方向(位置)だけを狭めるが、楕円が傾いているので縦方向(速度)も一緒に縮む
速い可能性がある点ほど遠くへ進むので、予測で楕円は右上がりに傾きます。測定は位置だけを教えますが、傾いた楕円を赤い帯で切ると、速度の範囲も狭まります。これが、測っていない変数を推定できる仕組みです。
同じ計算を繰り返すと、K は [\,0.692\ \ 0.462\,] 、 [\,0.760\ \ 0.544\,] 、 [\,0.760\ \ 0.508\,] と動いて、6 ステップほどで [\,0.75\ \ 0.5\,] に落ち着きます。測定の値には関係なく、K と P は A、C、Q、R だけで決まるので、測定を見る前に計算しておけます。
行列でも K が定数に落ち着きました。次の章では、この定常状態のカルマンフィルタを伝達関数で書き、これまでのフィルタと同じ道具で測ります。
📊 周波数で見る
K が一定になれば、カルマンフィルタは入力を 2 倍すると出力も 2 倍になり、時刻をずらしても同じ動きをする線形時不変のフィルタです。つまり #1〜#4 と同じ伝達関数(出力と入力の比を z^{-1} の分数で書いたもの。 z^{-1} は 1 サンプルの遅れ)を持ちます。ここで知りたいのは、カルマンフィルタが周波数の上でどんな形をしていて、#2 の 2 次バターワース(通す帯域を平らに保つ形の 2 次のローパス)と何が違うのかです。
定常ゲインの伝達関数を導く
等速モデルの定常ゲインを K = [\,K_1\ \ K_2\,]^{\mathsf{T}} とします。式を見やすくするために、次の 2 つの数を定義します。
\alpha = K_1,\quad \beta = K_2\,Tどちらも単位のない数です。1 サンプルあたりの移動量を d[n] = T\,\hat{\dot{p}}[n] ( \hat{\dot{p}} は速度の推定値)と置くと、5 本の式のうち状態に関わる 2 本は、次の 3 本になります。 \nu[n] はイノベーションです。
\nu[n] = y[n] - \hat{p}[n-1] - d[n-1] \hat{p}[n] = \hat{p}[n-1] + d[n-1] + \alpha\,\nu[n] d[n] = d[n-1] + \beta\,\nu[n]z 変換します。y、 \hat{p} 、d、ν の z 変換をそれぞれ Y、 \hat{P} (共分散の P とは別の文字として読みます)、D、N と書き、 \Delta = 1 - z^{-1} と置きます。3 本目は \Delta D = \beta N 、つまり移動量はイノベーションの積分です。2 本目は \Delta\hat{P} = z^{-1}D + \alpha N です。この 2 つから \hat{P} をイノベーションで表します。
\hat{P}(z) = \frac{\beta z^{-1} + \alpha\Delta}{\Delta^2}\,N(z)1 本目は N = Y - z^{-1}(\hat{P} + D) です。 \hat{P} と D を入れて N について解くと、 \beta z^{-1} + \beta\Delta = \beta の関係で項がまとまり、次の式になります。
N(z) = \frac{\Delta^2}{\Delta^2 + z^{-1}(\alpha\Delta + \beta)}\,Y(z)分母を z^{-1} のべきで整理したものを Den(z) と書きます。
\begin{aligned} \mathrm{Den}(z) = {} & 1 + (\alpha+\beta-2)\,z^{-1} \\ & + (1-\alpha)\,z^{-2} \end{aligned}\hat{P}/N の分子と掛け合わせると、測定から位置の推定までの伝達関数が出ます。
H(z) = \frac{\hat{P}(z)}{Y(z)} = \frac{\alpha + (\beta-\alpha)\,z^{-1}}{\mathrm{Den}(z)}分子と分母が 2 次以下なので、#1 の biquad(2 次の IIR の基本ブロック)で計算できる形です。z = 1(0 Hz に当たる点)を入れると分子も分母も β になり、一定の入力に対する DC ゲインは 1 です。極は行列 (I-KC)A の固有値に一致します。
この式の値打ちは、入力との差を取ると分かります。 1 - H(z) を通分すると、分子がきれいに因数分解できます。
1 - H(z) = \frac{(1-\alpha)\,(1 - z^{-1})^2}{\mathrm{Den}(z)}(1 - z^{-1})^2 は z = 1 の 2 重の零点(分子を 0 にする点)で、#3 で見た DC(0 Hz の成分)を消す形が 2 段重なったものです。傾き一定の入力は、1 回差分を取ると定数、2 回取ると 0 になります。したがって傾き一定の入力に対して、定常状態の誤差は厳密に 0 です。 等速モデルを入れた結果が、零点として伝達関数に現れました。
アナログの形に直すと、もっとはっきりします。 z = e^{sT} の s は連続時間の周波数を表す複素数です。α と β が小さいとき、z = 1 の近くで z^{-1} \approx 1 - sT + s^2T^2/2 と近似すると、分母は \beta + \alpha T s + T^2 s^2 になります。 \omega_0 = \sqrt{\beta}/T 、 \zeta = \alpha/(2\sqrt{\beta}) と置くと、次の 2 本です。
H(s) \approx \frac{2\zeta\omega_0 s + \omega_0^2}{s^2 + 2\zeta\omega_0 s + \omega_0^2} 1 - H(s) \approx \frac{s^2}{s^2 + 2\zeta\omega_0 s + \omega_0^2}ζ は減衰比で、振動の収まりやすさを表す値です。下の式は #3 の 2 次ハイパス(HPF)の形です。H の分母は #2 の標準 2 次系(ローパスの基本形)と同じで、違いは分子の 2\zeta\omega_0 s です。この項がローパスの位相の遅れ(波のずれ)を打ち消します。代わりに、高い周波数の落ち方は −20 dB/decade(周波数が 10 倍で振幅が 0.1 倍)に止まり、カットオフの手前に山ができます。
数字を入れる:−3 dB を 20 Hz にそろえる
#2 と比べるために、fs = 1 kHz(T = 1 ms)で −3 dB が 20 Hz になる Q を探します。定常ゲインは多次元のリカッチ方程式の解ですが、後の「実装」で示す 1 行で計算できます。センサのノイズを \sigma_v = 1 mm(R = 1 mm²)とすると、 \sigma_a = 3873 mm/s²(約 3.9 m/s²)のときに −3 dB が 20.0 Hz になりました。
Q = \begin{bmatrix} 3.75\times10^{-6} & 7.50\times10^{-3} \\ 7.50\times10^{-3} & 15.0 \end{bmatrix} \begin{gathered} K = \begin{bmatrix} 0.08424 \\ 3.706 \end{bmatrix} \\ \alpha = 0.08424,\quad \beta = 0.003706 \end{gathered}伝達関数の係数は次のとおりです。
\begin{aligned} H(z) = \frac{0.08424 - 0.08054\,z^{-1}}{1 - 1.91205\,z^{-1} + 0.91576\,z^{-2}} \end{aligned}極は 0.95603 \pm 0.04210j 、零点は z = 0.9560 です。 \zeta = \alpha/(2\sqrt{\beta}) = 0.692 で、バターワースの 0.707 に近い値です(理由は次の章で分かります)。定常の誤差共分散は次の値で、位置の推定の標準偏差は 0.29 mm、速度の標準偏差は 18.3 mm/s です。
P = \begin{bmatrix} 0.08424 & 3.706 \\ 3.706 & 333.4 \end{bmatrix}左上が α に等しいのは偶然ではありません。更新の式を変形すると PC^{\mathsf{T}} = KR が成り立ち、1 列目は K に R を掛けた値になります。
Q/R でカットオフを動かす
Q と R を変えると、帯域が動きます。Q の中身は \sigma_a と T で決まるので、定常ゲインを決める単位のない数は次の 1 つにまとまります。
\Lambda = \frac{\sigma_a T^2}{\sigma_v}Λ(ラムダ)は、加速度が 1 サンプルで動かす距離と、センサのノイズの比です。1 次元の Q/R に当たる数で、トラッキング指数と呼ばれます。次の図は Λ を 3 通りに変えた特性です。左上の振幅、右上の群遅延(その周波数の信号が何秒遅れるか)、左下の位相、右下のナイキスト線図(周波数応答を、横軸が実部、縦軸が虚部の複素平面に描いた曲線。灰色の破線が半径 1 の単位円)を見てください。丸印が −3 dB の点です。
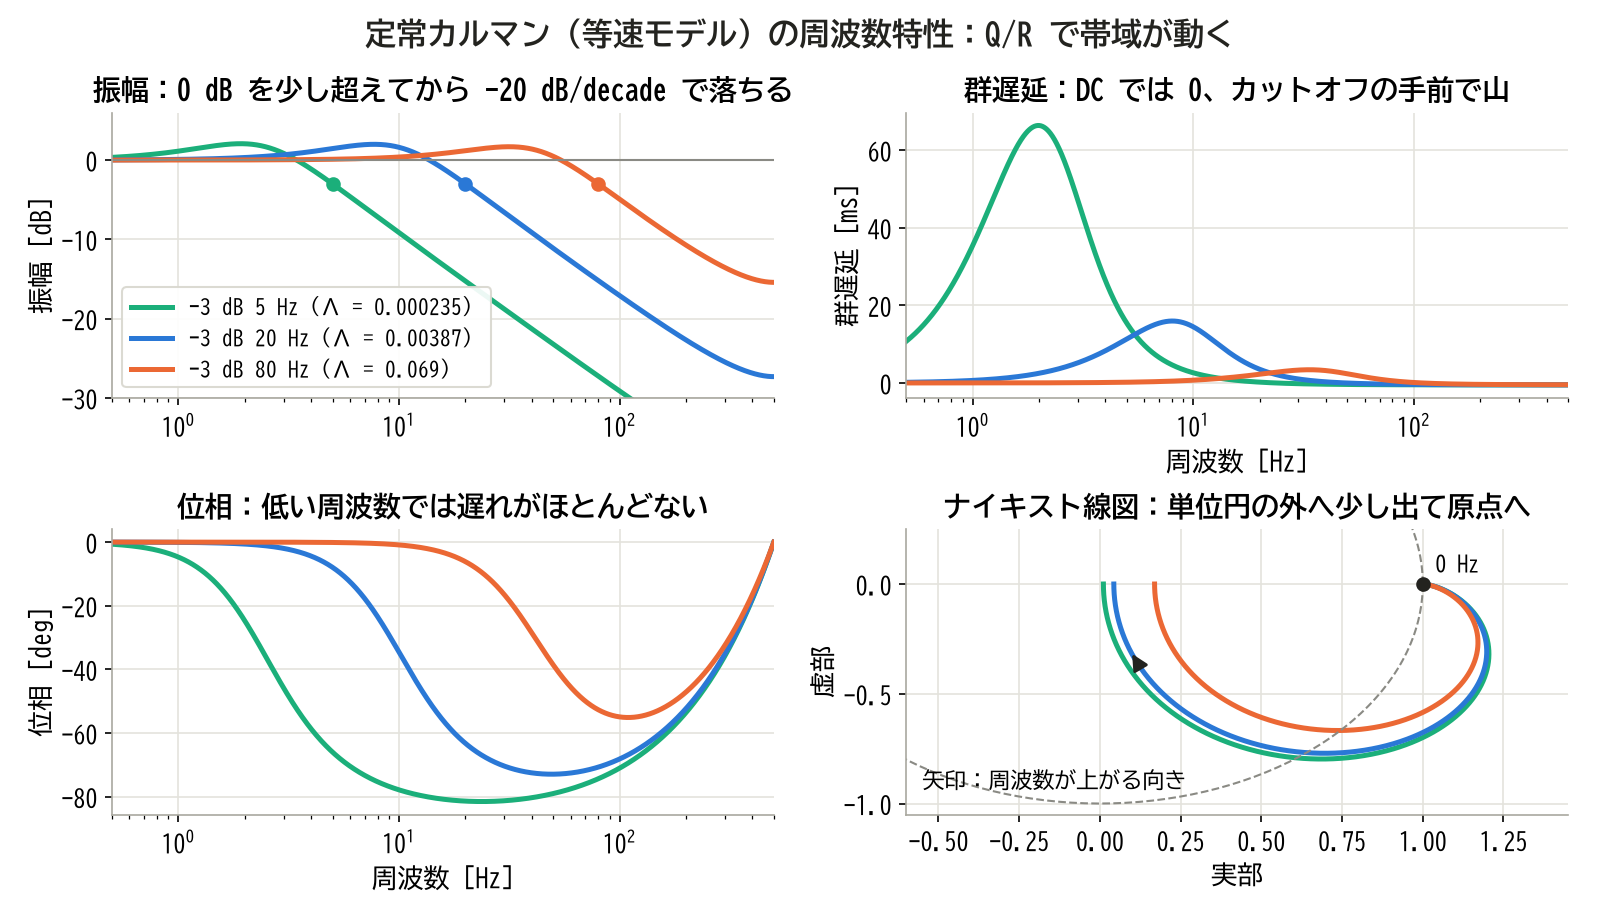
振幅は 0 dB を約 2 dB 超えてから落ちる。群遅延は DC で 0 になり、カットオフの手前に山を作る。ナイキスト線図の曲線は 1 から出発して単位円の外へ膨らみ、位相の遅れは −90° に届かない
| 狙いの −3 dB | Λ | α、β | 白色ノイズの分散比(出力 ÷ 入力) |
|---|---|---|---|
| 5 Hz | 0.000235 | 0.0215、0.000233 | 0.0162 |
| 20 Hz | 0.00387 | 0.0842、0.00371 | 0.0641 |
| 80 Hz | 0.0690 | 0.310、0.0573 | 0.246 |
Λ が小さいとき、 \beta \approx \Lambda です。アナログの形で |H|^2 = 1/2 を解くと(ζ = 1/√2 として)、−3 dB は \omega_0 の 2.06 倍にあります。合わせると次の目安が出ます。
f_c \approx \frac{2.06}{2\pi}\cdot\frac{\sqrt{\Lambda}}{T} = 0.33\,f_s\sqrt{\Lambda}カットオフは Λ の平方根に比例します。Q の成分は Λ の 2 乗に比例するので、Q/R で言えば 4 乗根です。カットオフを 2 倍にするには、Q/R を 16 倍にします。Q を 10 倍間違えても帯域は 1.8 倍にしか変わらないので、Q は桁で合わせれば十分に働きます。
図のナイキスト線図が単位円の外へ出ているのは、振幅が 1 を超える周波数があるからです。山の高さはアナログの形なら \sqrt{1.618} 倍、つまり +2.1 dB で、20 Hz の設計では 7.7 Hz に +1.99 dB の山ができます。
2 次バターワースと重ねる
同じ −3 dB 20 Hz の 2 次バターワース(#2 の設計そのもの)を重ねます。左の振幅で高い周波数の落ち方、中央の群遅延で低い周波数の値、右で傾き一定の入力への追従を比べてください。
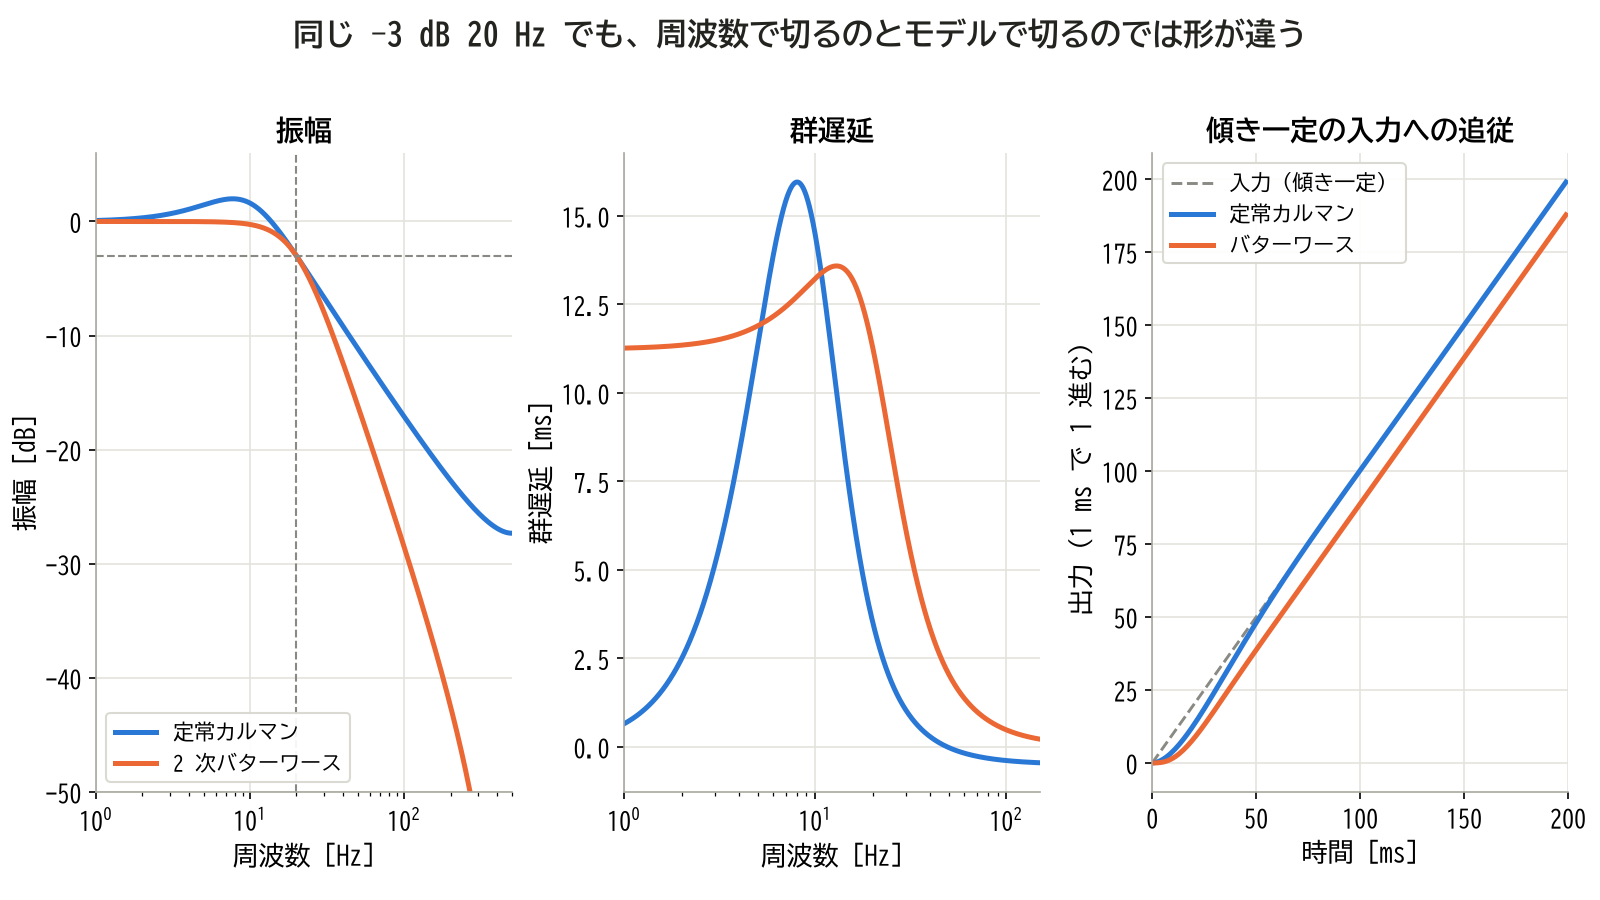
左:高い周波数はバターワースのほうが深く落ちる。中央:カルマンの群遅延は低い周波数で 0 に近づく。右:カルマンの線は立ち上がりのあと入力に重なり、バターワースは一定の遅れで平行に走る
図の差を数字にしたのが次の表です。ステップ応答は、入力を 0 から 1 へ一度に切り替えたときの出力です。行き過ぎは、その出力が最終値を超えて振れた量です。分散比は、出力の分散を入力の分散で割った値です。
| 項目 | 定常カルマン | 2 次バターワース |
|---|---|---|
| −3 dB | 20.0 Hz | 20.0 Hz |
| 通過域の山 | +1.99 dB(7.7 Hz) | なし |
| 100 Hz の減衰 | −17.1 dB | −28.5 dB |
| 200 Hz の減衰 | −22.7 dB | −42.5 dB |
| 低周波の群遅延 | 0 ms | 11.2 ms |
| 群遅延の最大 | 16.0 ms(8 Hz) | 13.6 ms(13 Hz) |
| 傾き一定の入力の遅れ | 0 ms | 11.2 ms |
| ステップ応答の行き過ぎ | 19.9 % | 4.3 % |
| 白色ノイズの分散比 | 0.0641 | 0.0443 |
周波数の尺度だけで比べれば、ノイズも切れ味もバターワースのほうが上です。定常カルマンの強みは、「等速で動く信号を遅れなく追う」という一点に、フィルタの形を全部使っていることです。フィルタがモデルを持つとは、どの形の信号を誤差なしで通すかを指定することだと言えます。
定常カルマンも線形時不変のフィルタです。信号と同じ周波数にあるノイズは、信号と一緒に通ります。カルマンフィルタが得をするのは、①信号の形を式で知っている ②ゲインを起動直後から時々刻々変えられる ③ジャイロと加速度計のように別のセンサの情報を足せる、の 3 点です。③は次の章で扱います。
白色ノイズを通す
理論どおりに動くかを、白色ノイズで確かめます。σ = 1 のガウス白色ノイズを fs = 1 kHz、2^16 点で作り、2 つのフィルタに通して、PSD(パワースペクトル密度。周波数 1 Hz あたりのパワーの分布)を計算します。フィルタを通すと、PSD は周波数ごとに |H|^2 倍になるはずです。計算には、短い区間の FFT(信号を周波数成分に分ける計算)を平均する Welch 法を使います。条件はハン窓(区間の端を 0 に絞る重み)、4096 点、50 % オーバーラップ(区間を半分ずつ重ねる取り方)で、#1〜#4 と同じです。左の図で見るのは実線が破線の理論に乗るかどうか、右は同じ出力の時間波形です。
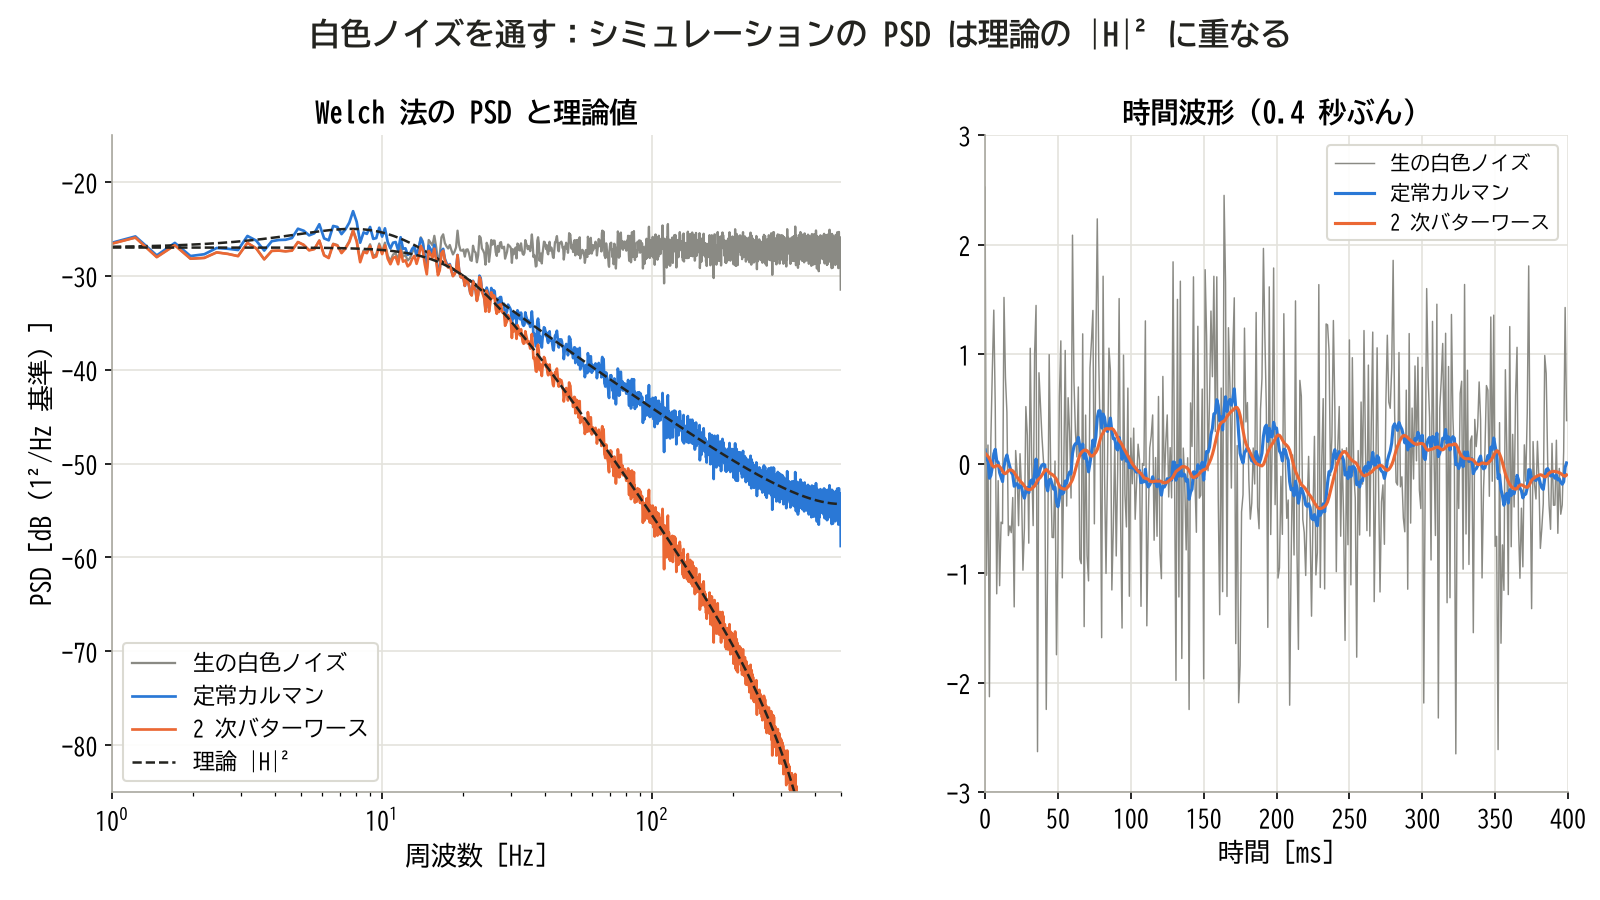
左:どちらも理論の破線をなぞる。カルマンは 8 Hz 付近にわずかな山を作り、高い周波数の残りが多い。右:カルマンの線には細かい揺れが残る
シミュレーションと理論の PSD の差は平均 0.67 dB で、#2 と同じ程度です。分散はカルマンが 0.0634(理論 0.0641)、バターワースが 0.0437(理論 0.0443)でした。分散比の理論値は、インパルス応答の 2 乗和を閉じた形にした次の式でも出ます。
\frac{\sigma_{\hat{p}}^2}{\sigma_v^2} = \frac{2\alpha^2 + \beta(2-3\alpha)}{\alpha(4-\beta-2\alpha)}α と β を入れると 0.0641 です。この値は定常の P_{11}/R = 0.0842 より小さくなっています。P にはノイズのほかに、プロセスノイズで位置が動くぶんの誤差も入っているからです。
合成信号で追従を見る
白色ノイズだけでは、モデルの効き目は見えません。止まっている、等速で進む、途中で速度が変わる、という位置の信号に σ = 1 mm のノイズを足し、同じ 2 つのフィルタに通します。上段が入力、中段が等速区間の拡大、下段がノイズを除いた誤差です。
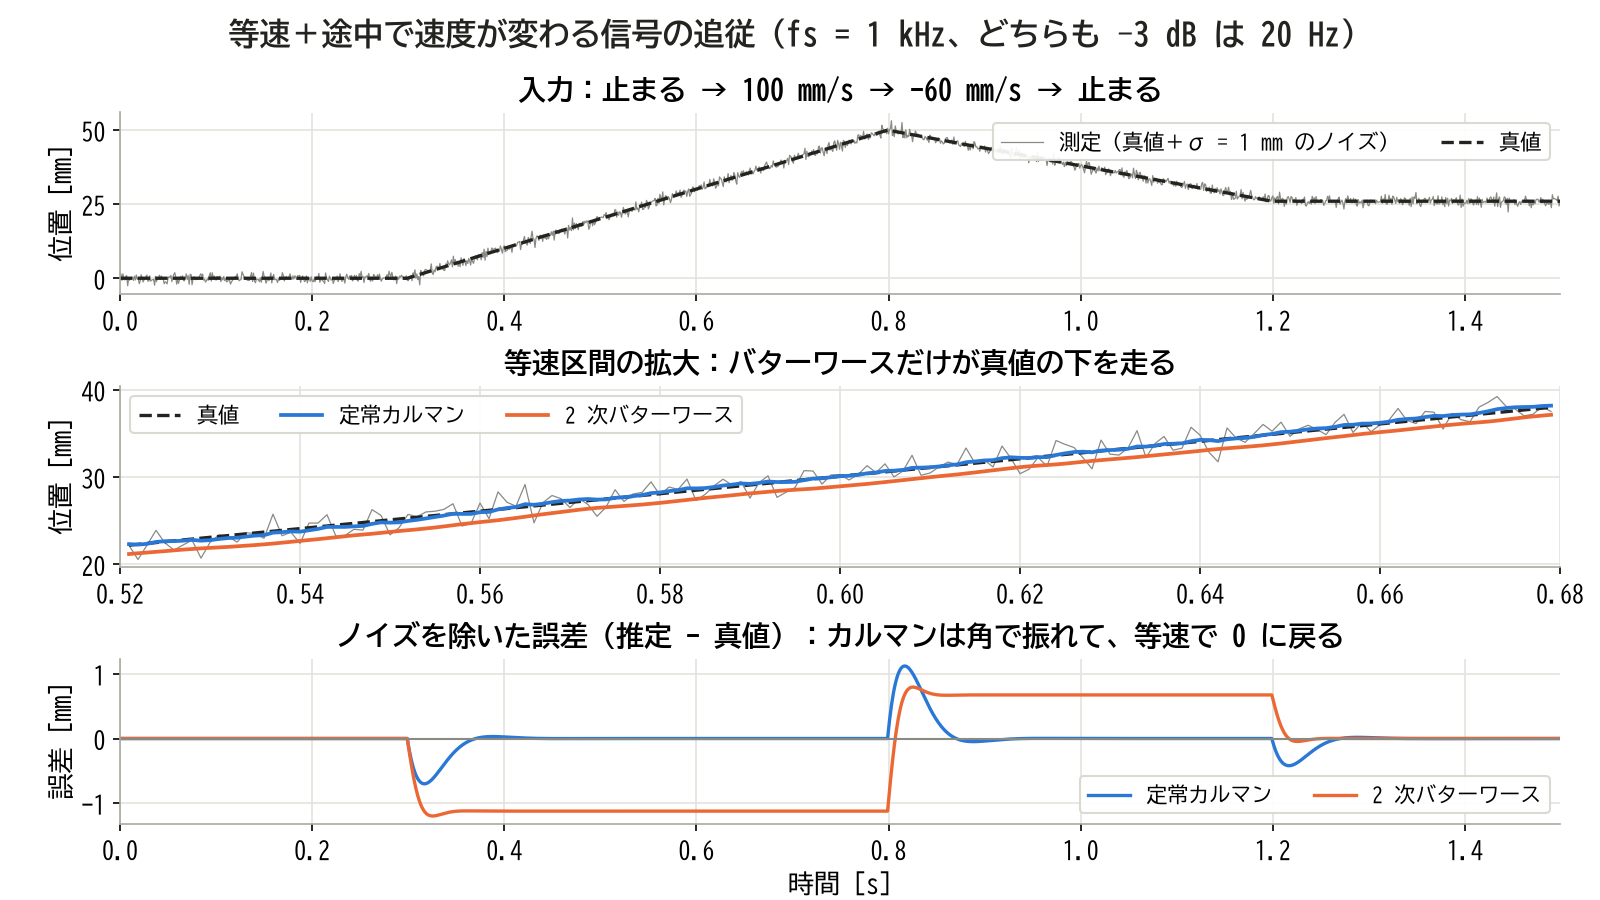
中段:バターワースだけが真値の下を走る。下段:バターワースは等速の間ずっと遅れを持ち続け、カルマンは角で振れたあと 0 へ戻る
バターワースの誤差は、等速の間ずっと速度 × 11.2 ms で、100 mm/s なら 1.12 mm です。カルマンは等速が続けば 0 へ戻り、この例では速度が変わってから 60 ms で ±0.05 mm に収まります。角での振れは 1.12 mm で、バターワースの 1.20 mm と同じ程度です。
| 区間 | 生の測定 | 定常カルマン | 2 次バターワース |
|---|---|---|---|
| 全区間の誤差 RMS | 0.99 mm | 0.29 mm | 0.76 mm |
| 等速区間の誤差 RMS | 0.99 mm | 0.18 mm | 1.06 mm |
RMS(2 乗平均の平方根)で見ても、モデルが合う区間ではカルマンの勝ちです。逆に、この信号でノイズだけの分散比を比べると上の表のとおりバターワースが勝ちます。
モデルどおりの乱数( \sigma_a = 3873 mm/s² の加速度)で 2^16 点のシミュレーションを行うと、位置の誤差 RMS は 0.286 mm、速度は 18.0 mm/s で、P の平方根 0.290 mm、18.3 mm/s とよく合います。P はただの設計用の数字ではなく、モデルが合っていれば誤差の大きさを正しく言い当てる量です。
定常カルマンの形が分かったので、次の章では実務でよく使う 2 つの固定ゲインのフィルタと比べます。
⚖️ 相補フィルタ・αβ フィルタとの比較
マイコンの現場では、カルマンフィルタより先に相補フィルタや αβ フィルタに出会うことが多いはずです。どちらも行列の計算がなく、1〜3 行で書けます。この章では、この 2 つが定常カルマンとどの関係にあるのかを式で確かめます。
相補フィルタ
IMU(慣性計測装置)は、角速度を測るジャイロと、加速度を測る加速度センサを 1 つにした部品です。傾き θ を求める方法が 2 つあります。
- ジャイロの角速度 ω を積分する:短い時間なら滑らかで正確ですが、ゼロ点のわずかなずれ(バイアス)も積分されるので、値が時間とともに流れていきます。これをドリフトと呼びます
- 加速度センサで重力の向きから角度 \theta_{acc} を出す:長い時間で見れば正しいですが、ノイズが多く、動いている間の加速度に惑わされます
ジャイロは高い周波数で、加速度センサは低い周波数で頼りになります。この得意な帯域を 1 本の式で合わせるのが相補フィルタです。a は 1 に近い定数です。
\begin{aligned} \hat{\theta}[n] = {} & a\left(\hat{\theta}[n-1] + \omega[n]\,T\right) \\ & + (1-a)\,\theta_{acc}[n] \end{aligned}\omega[n] は時刻 n − 1 から n の間の角速度を読んだ値です。z 変換して整理します。ジャイロを積分した角度を \Theta_g(z) = T\,\Omega(z)/(1-z^{-1}) と置くと、 T\Omega = (1-z^{-1})\Theta_g なので、次の形になります。
\begin{aligned} \hat{\Theta}(z) = {} & H_{LP}(z)\,\Theta_{acc}(z) \\ & + H_{HP}(z)\,\Theta_g(z) \end{aligned} \begin{gathered} H_{LP}(z) = \frac{1-a}{1 - a z^{-1}} \\ H_{HP}(z) = \frac{a(1 - z^{-1})}{1 - a z^{-1}} \end{gathered}H_{LP} は #2 の 1 次 IIR(α = 1 − a)、 H_{HP} は #3 の 1 次の HPF です。#3 で示したとおり、この 2 つは複素数の和が 1 になります。
H_{LP}(z) + H_{HP}(z) = 1「相補」の名前は、ここから来ています。注意したいのは、足して 1 になるのは複素数としての和で、振幅どうしの和ではないことです。次の図は、この章の後半の比較で使う a = 0.98、fs = 200 Hz の場合です。このときのカットオフは 0.64 Hz です。図の左で点線が 0 dB から浮いているのが振幅の和で、0.64 Hz では 0.707 + 0.700 = 1.41 倍です。右の図は同じ関係を複素平面で描いたもので、2 本の矢印を足すといつも 1 に届きます。
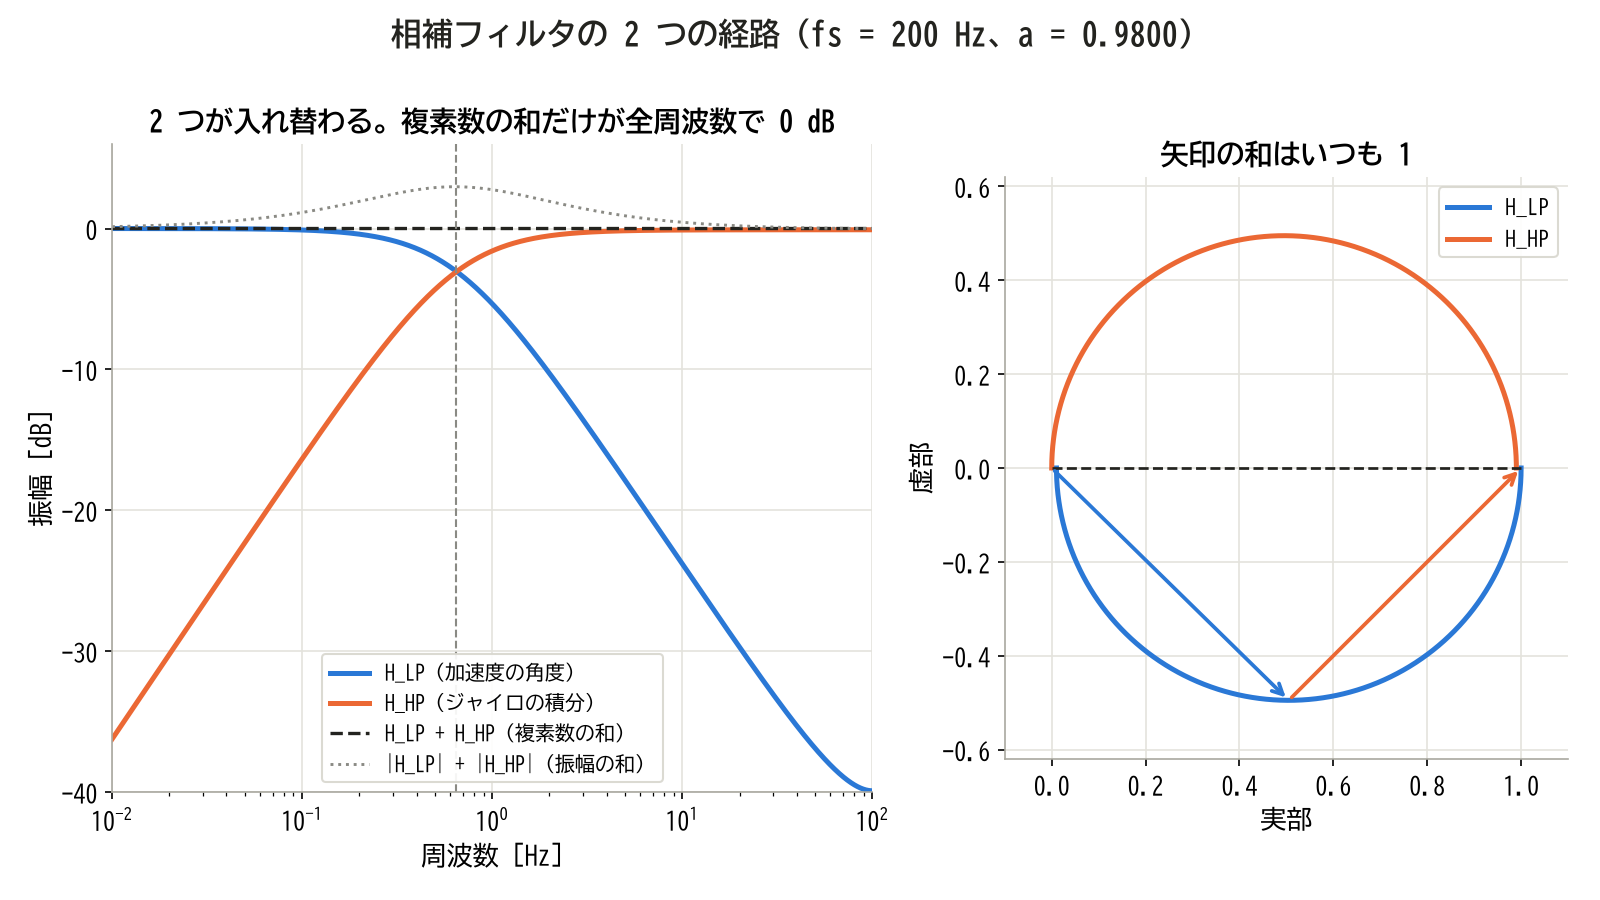
左:2 つの経路がカットオフで入れ替わる。破線の複素数の和は全周波数で 0 dB、点線の振幅の和は 3 dB 浮く。右:2 本の矢印の和はいつも 1
複素数の和が 1 なので、もしジャイロにも加速度センサにもノイズがなく、どちらも同じ真の角度を返すなら、出力は遅れなしで真の角度そのものです。相補フィルタは、信号の形を変えずに、2 つのセンサのノイズを帯域で振り分ける構造です。
相補フィルタは 1 次の定常カルマン
カルマンのモデルで同じことを書きます。状態は θ だけ、ジャイロを既知の入力 u として扱います。
\begin{gathered} \theta[n] = \theta[n-1] + T\,\omega[n] + w[n] \\ \theta_{acc}[n] = \theta[n] + v[n] \end{gathered}A = 1、B = T、C = 1 です。w はジャイロのノイズがこの式へ入ったもので、ジャイロのノイズの標準偏差を \sigma_g とすると Q = (T\sigma_g)^2 です。R は \theta_{acc} の分散です。カルマンの予測と更新を、定常ゲイン K で 1 本につなぐと次の式です。
\begin{aligned} \hat{\theta}[n] = {} & (1-K)\left(\hat{\theta}[n-1] + T\,\omega[n]\right) \\ & + K\,\theta_{acc}[n] \end{aligned}a = 1 − K と置けば、相補フィルタと文字まで同じです。相補フィルタは、状態が 1 つの定常カルマンの、ゲインを手で決めた形です。 Higgins の 1975 年の論文は、この 2 つの関係を比較したものです。カルマンの側から見ると、a は勘ではなく Q/R から決まります。次の式の K_\infty(\cdots) は、1 次元の章で求めた定常ゲインの式に r = Q/R = (T\sigma_g)^2/R を入れた値という意味です。
a = 1 - K_\infty\!\left(\frac{(T\sigma_g)^2}{R}\right)αβ フィルタと定常カルマン
αβ フィルタは、位置と速度を固定のゲインで追うフィルタで、レーダーの目標追尾で育った手法です。式は「周波数で見る」で書いたものと同じです。
\begin{gathered} \hat{p}[n] = \hat{p}^-[n] + \alpha\,\nu[n] \\ \hat{\dot{p}}[n] = \hat{\dot{p}}^-[n] + \frac{\beta}{T}\,\nu[n] \end{gathered}予測は等速で \hat{p}^-[n] = \hat{p}[n-1] + T\hat{\dot{p}}[n-1] 、 \hat{\dot{p}}^-[n] = \hat{\dot{p}}[n-1] です。カルマンの更新の式と比べると \alpha = K_1 、 \beta/T = K_2 で、αβ フィルタは定常カルマンと同じ構造です。α と β は自由に選べるので、定常カルマンは、その中で「ゼロ次ホールドの白色加速度」というモデルに最適な 1 組だと言えます。
その 1 組がどう決まるかを、定常状態の共分散から導きます。 \alpha = P_{11}^-/S 、 \beta/T = P_{12}^-/S で、 S = P_{11}^- + R より R = (1-\alpha)S です。
まず 2 行 2 列の成分を見ます。更新で P_{22} = P_{22}^- - (\beta/T)^2 S 、予測で P_{22}^- = P_{22} + \sigma_a^2 T^2 なので、定常では 2 つの変化が釣り合います。
\begin{gathered} \frac{\beta^2}{T^2}\,S = \sigma_a^2 T^2 \\ \frac{\beta^2}{1-\alpha} = \frac{\sigma_a^2 T^4}{\sigma_v^2} = \Lambda^2 \end{gathered}次に 1 行 1 列と 1 行 2 列の予測の式 P_{11}^- = P_{11} + 2TP_{12} + T^2P_{22} + \sigma_a^2T^4/4 、 P_{12}^- = P_{12} + TP_{22} + \sigma_a^2T^3/2 から P_{22} を消します。更新の P_{11} = \alpha R 、 P_{12} = \beta R/T を入れて S で割ると、Λ が消えて α と β だけの関係が残ります。
\left(\alpha + \frac{\beta}{2}\right)^2 = 2\betaα と β が小さければ \alpha^2 \approx 2\beta 、つまり \zeta = \alpha/(2\sqrt{\beta}) \approx 1/\sqrt{2} です。前の章で ζ がバターワースに近かった理由はこれです。分母がバターワースになるのは、このモデルの Q の形の結果でした。
トラッキング指数で αβ のゲインを整理したのが、Kalata の 1984 年の論文です。上の 2 本を Λ について解くと、次の閉じた式になります。リカッチ方程式を解かなくても、Λ から α と β が出ます。
\alpha = -\frac{\Lambda^2 + 8\Lambda - (\Lambda+4)\sqrt{\Lambda^2 + 8\Lambda}}{8} \beta = \frac{\Lambda^2 + 4\Lambda - \Lambda\sqrt{\Lambda^2 + 8\Lambda}}{4}検算します。手計算の例は T = 1、 \sigma_a = \sigma_v = 1 なので Λ = 1 です。√9 = 3 を入れると α = −(9 − 15)/8 = 0.75、β = (5 − 3)/4 = 0.5 で、手で回して収束した K と一致します。(0.75 + 0.25)² = 1 = 2 × 0.5 も成り立ちます。20 Hz の設計の Λ でも、リカッチ方程式の数値解と 12 桁以上一致しました。
3 つの関係を表にまとめます。
| フィルタ | 状態 | ゲインの決め方 | 定常カルマンとの関係 |
|---|---|---|---|
| 1 次 IIR | 値 1 個 | α を手で | Q/R で決まる 1 状態の定常カルマン |
| 相補 | 角度 1 個+ジャイロ入力 | a を手で | 入力つき 1 状態の定常カルマン |
| αβ | 位置と速度 | α、β を手で | 2 状態の定常カルマンと同じ構造 |
| カルマン | 任意 | Q、R から毎回計算 | 時変のゲインまで含む全体 |
同じ IMU の信号で 3 つを比べる
式の関係が分かったので、同じ題材に 3 つをかけます。fs = 200 Hz の IMU を想定し、次のノイズを与えます。ジャイロは \sigma_g = 0.5 deg/s の白色ノイズ、加速度センサの角度は σ = 0.23 deg の白色ノイズです(数値の出どころは「設計手順」で説明します)。バイアスはここでは 0 とします。比べるのは次の 3 つです。
- 相補 a = 0.98:手で選んだ値。時定数は 0.25 秒
- 定常カルマン a = 0.9892: Q = (T\sigma_g)^2 = 6.25\times10^{-6} 、R = 0.0529 deg² から計算。K = 0.0108、時定数は 0.46 秒
- αβ:加速度の角度だけを入力にする。#2 の傾き表示に合わせて −3 dB を 2 Hz に設計(Λ = 0.00095、α = 0.0427、β = 0.00093)
信号は、2 秒から 1 秒かけて傾きを 30° 変え、6.3 秒付近で横方向の加速度が加わって \theta_{acc} だけが最大 8° ずれる、というものです。上段が全体、中段が傾きを変える前後の誤差、下段が横加速度の前後の誤差です。
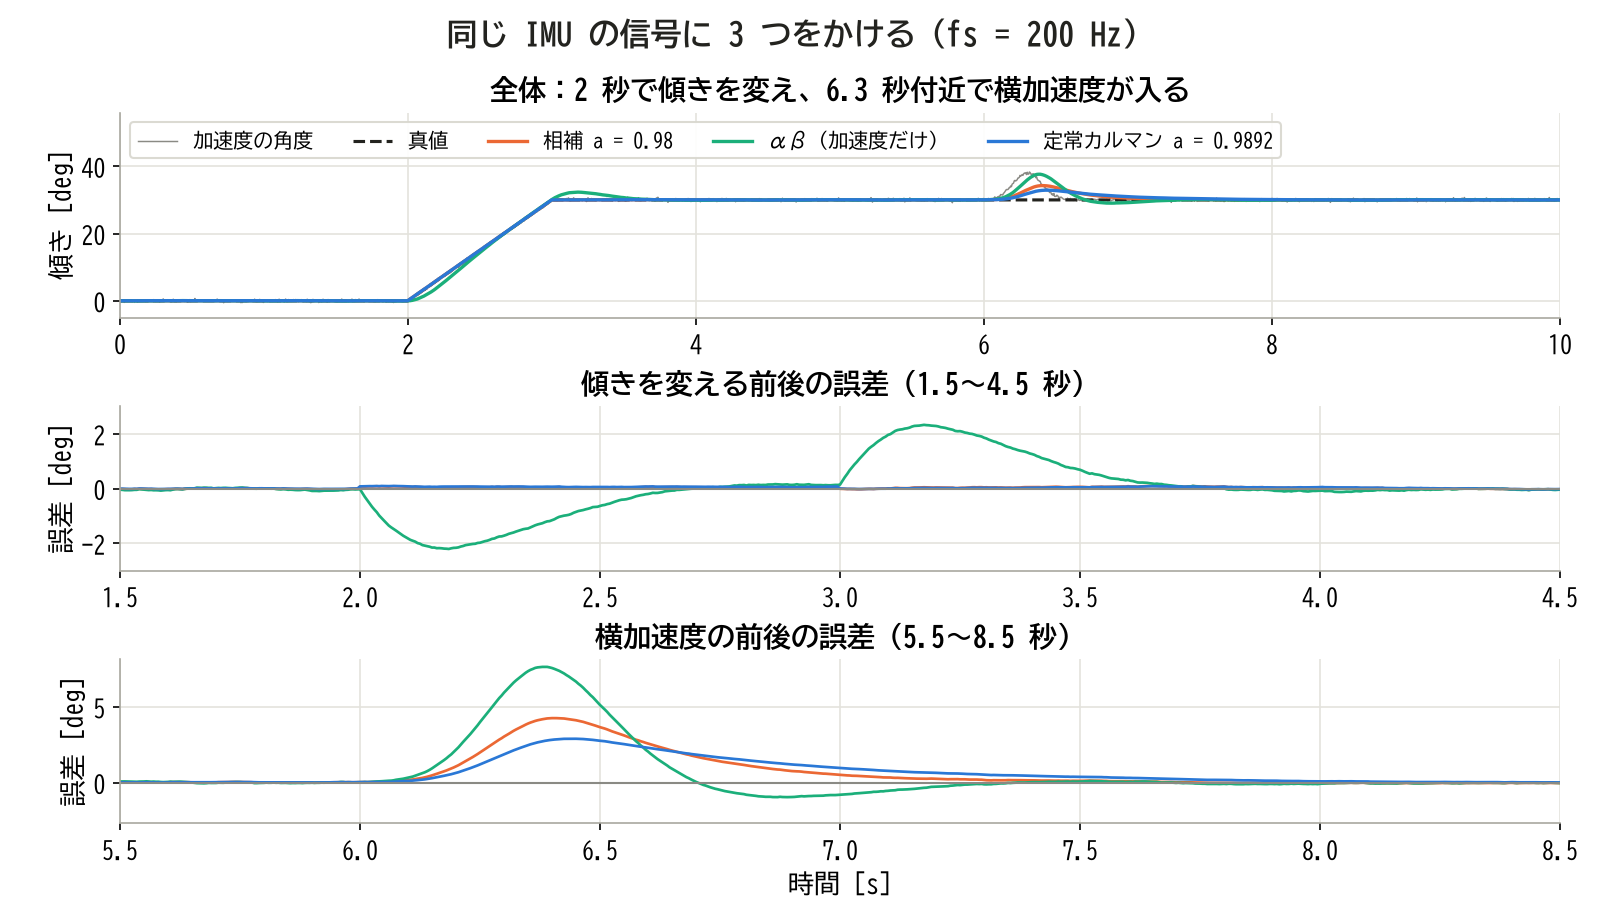
中段:ジャイロを使う 2 つは傾きの動きにそのまま付いていき、αβ だけが動きの始めと終わりで 2° 以上外れる。下段:横加速度にいちばん強いのは定常カルマン
| フィルタ | 静止時のノイズ RMS | 傾きを変える間の最大誤差 | 横加速度の最大誤差 |
|---|---|---|---|
| 相補 a = 0.98 | 0.022° | 0.09° | 4.3° |
| αβ(加速度だけ) | 0.040° | 2.3° | 7.6° |
| 定常カルマン a = 0.9892 | 0.019° | 0.09° | 2.9° |
生の \theta_{acc} の静止時のノイズは 0.24° です。ジャイロを足した 2 つは、傾きを変える間の誤差が αβ の 1/20 以下になります。これが「別のセンサの情報を足す」効果で、周波数で切るだけでは出ない差です。αβ は等速の区間には強いのですが、角では遅れ、横加速度はそのまま信じてしまいます。
相補フィルタと定常カルマンの差は a の値だけです。同じ入力でカルマンの式を定常ゲインのまま回した結果は、相補の式の結果と丸め誤差の範囲で一致しました。この例では、Q/R から計算した a のほうがノイズも横加速度の誤差も小さくなりました。
ここまでの比較は、ノイズの大きさが分かっている前提です。次の章では、その値をどう決めるかを手順にします。
🧪 設計手順
カルマンフィルタの設計は、次の 5 段です。#2 の「要件、式、係数、検証」に、モデルの段が増えた形です。
- 要件:何を推定したいか、fs、許せる誤差、測れる量を書き出す
- モデル:状態を選び、A、B、C を物理の式から書く
- Q と R:R はセンサのノイズから、Q は想定する動きの変動から決める
- 初期値: \hat{x}[0] と P[0] を、最初の不確かさとして与える
- 検証:イノベーションを見て、モデルと Q、R が合っているかを数字で判定する
R の決め方
データシートの多くは、ノイズをノイズ密度で書いています。単位が µg/√Hz や deg/s/√Hz のように √Hz で割られた値で、1 Hz の幅あたりのノイズの大きさ(PSD の平方根)を表します。分散は PSD を周波数で積分した値なので、ノイズ密度を n、等価雑音帯域幅(#2 の ENBW。同じパワーになる理想の長方形フィルタの幅)を B_n として次の式で換算します。
\sigma^2 = n^2\,B_nセンサの内部に帯域幅 B の 1 次のローパスがあれば B_n = 1.57\,B 、2 次のバターワースなら 1.11 B です。ローパスがなければ f_s/2 です。前の章の値は、例として次の値を仮定したものです。
- 加速度センサ:n = 400 µg/√Hz、 B_n = 100 Hz とすると σ = 4 mg(1 mg は重力加速度の 1000 分の 1)。傾きが小さいとき角度は \theta \approx a/g [rad] なので 0.004 rad = 0.23°
- ジャイロ:n = 0.05 deg/s/√Hz、 B_n = 100 Hz とすると σ = 0.5 deg/s
ADC やエンコーダの量子化(値を 1 刻みの整数へ丸めること)で決まるノイズなら、1 刻みを Δ として、丸め誤差は一様分布なので R = \Delta^2/12 です。静止させた状態で 1000 点ほど取り、分散を計算するのがもっとも確実です。
Q の決め方
Q はセンサのように測れません。「モデルが表しきれない動きはどのくらいか」を物理の言葉で見積もります。等速モデルなら \sigma_a は、対象がふつうに出す加速度の大きさです。「周波数で見る」で確かめたように帯域は Q/R の 4 乗根で効くので、桁が合っていれば働きます。迷ったら Q を 10 倍ずつ振って、検証の数字で選びます。
初期値の決め方
\hat{x}[0] は最初の測定から作れる値を入れ、測れない成分は 0 とします。P[0] には、その値の不確かさを正直に入れます。位置なら R、速度なら想定する最大の速度の 2 乗です。P[0] を大きくすれば、最初の数サンプルは測定を強く信じて素早く収束します。小さくしすぎると、K が小さいところから始まるので、初期値の間違いがなかなか消えません。
検証:イノベーションと NIS
カルマンフィルタの設計が良いかどうかは、真の値を知らなくても判定できます。イノベーションを次の式で定義します。
\nu[n] = y[n] - C\,\hat{x}^-[n]モデルと Q、R が正しければ、ν は平均 0 の白色ノイズで、分散は S = CP^-C^{\mathsf{T}} + R になります。予測で説明できる成分をすべて取り除いた残りが ν なので、前後に相関が残っていれば、まだ取れる情報が残っているという意味です。この性質から、チェックは 2 つです。
① NIS。 正規化イノベーション 2 乗(Normalized Innovation Squared)は、ν を S で割って大きさをそろえた数です。
\mathrm{NIS}[n] = \nu[n]^{\mathsf{T}}\,S[n]^{-1}\,\nu[n]ν がガウス分布なら、NIS は標準正規分布の 2 乗の和が従う χ²(カイ 2 乗)分布に従い、平均は測定の個数 M です。測定が 1 個なら平均 1 で、N サンプルの平均は約 1 \pm 2\sqrt{2/N} の範囲に 95 % 入ります。
② 隣どうしの相関。 ν の 1 サンプルずれの相関が、白色なら約 \pm 2/\sqrt{N} に入ります。
NIS の平均が 1 より大きければ、フィルタは自信過剰です(Q か R が小さすぎる)。1 より小さければ慎重すぎます。「周波数で見る」のモデルどおりの乱数で計算すると、NIS の平均は 1.001、隣どうしの相関は −0.0001 で、どちらも合格の範囲です。
手順がそろったので、3 つの例に当てはめます。
設計例 1:IMU の傾きとジャイロバイアス
要件: 前の章の IMU(fs = 200 Hz)で、ジャイロのバイアスが 1 deg/s あっても傾きがずれないようにしたい。
相補フィルタにバイアス b が入ると、積分された角度の側では一定の傾き(ランプ)として HPF に入ります。HPF はランプを一定値に変えるので、出力にずれが残ります。静止した状態(ω = 0)で \hat{\theta} = a(\hat{\theta} + Tb) + (1-a)\theta の定常値を解くと、ずれは次の値です。
\Delta\theta = \frac{aT}{1-a}\,b = \tau\,bτ は相補フィルタの時定数です(a が 1 に近いので、63 % の時間とほぼ同じ値になります)。τ = 0.46 秒、b = 1 deg/s なら 0.46° ずれ続けます。
モデル: 状態にバイアスを足します。バイアスはゆっくりしか変わらないので、ランダムウォークとします。ω はジャイロの読みです。
\begin{gathered} x = \begin{bmatrix} \theta \\ b \end{bmatrix},\quad A = \begin{bmatrix} 1 & -T \\ 0 & 1 \end{bmatrix} \\ B = \begin{bmatrix} T \\ 0 \end{bmatrix},\quad C = \begin{bmatrix} 1 & 0 \end{bmatrix} \end{gathered} \begin{aligned} Q &= \begin{bmatrix} (T\sigma_g)^2 & 0 \\ 0 & \sigma_b^2 \end{bmatrix} \\ &= \begin{bmatrix} 6.25\times10^{-6} & 0 \\ 0 & 4\times10^{-6} \end{bmatrix} \\ R &= 0.0529 \end{aligned}\sigma_b = 0.002 deg/s は、1 サンプルあたりのバイアスの動きの見積もりです。b は測っていません。それでも推定できるのは、b がずれると θ の予測が加速度センサの角度から離れていき、そのイノベーションから b が分かるからです。このように出力の列から状態を決められる性質を可観測と呼びます。
定常ゲイン: リカッチ方程式を解くと K = [0.01422, −0.00863]、定常の標準偏差は θ が 0.027°、b が 0.036 deg/s です。
図は、20 秒の間に傾きを 1 回変えた結果です。上段は推定の全体、中段はバイアスの推定、下段は誤差です。見るのは、中段で \hat{b} が真の 1 deg/s へ向かうことと、下段で相補フィルタにだけ一定のずれが残ることです。
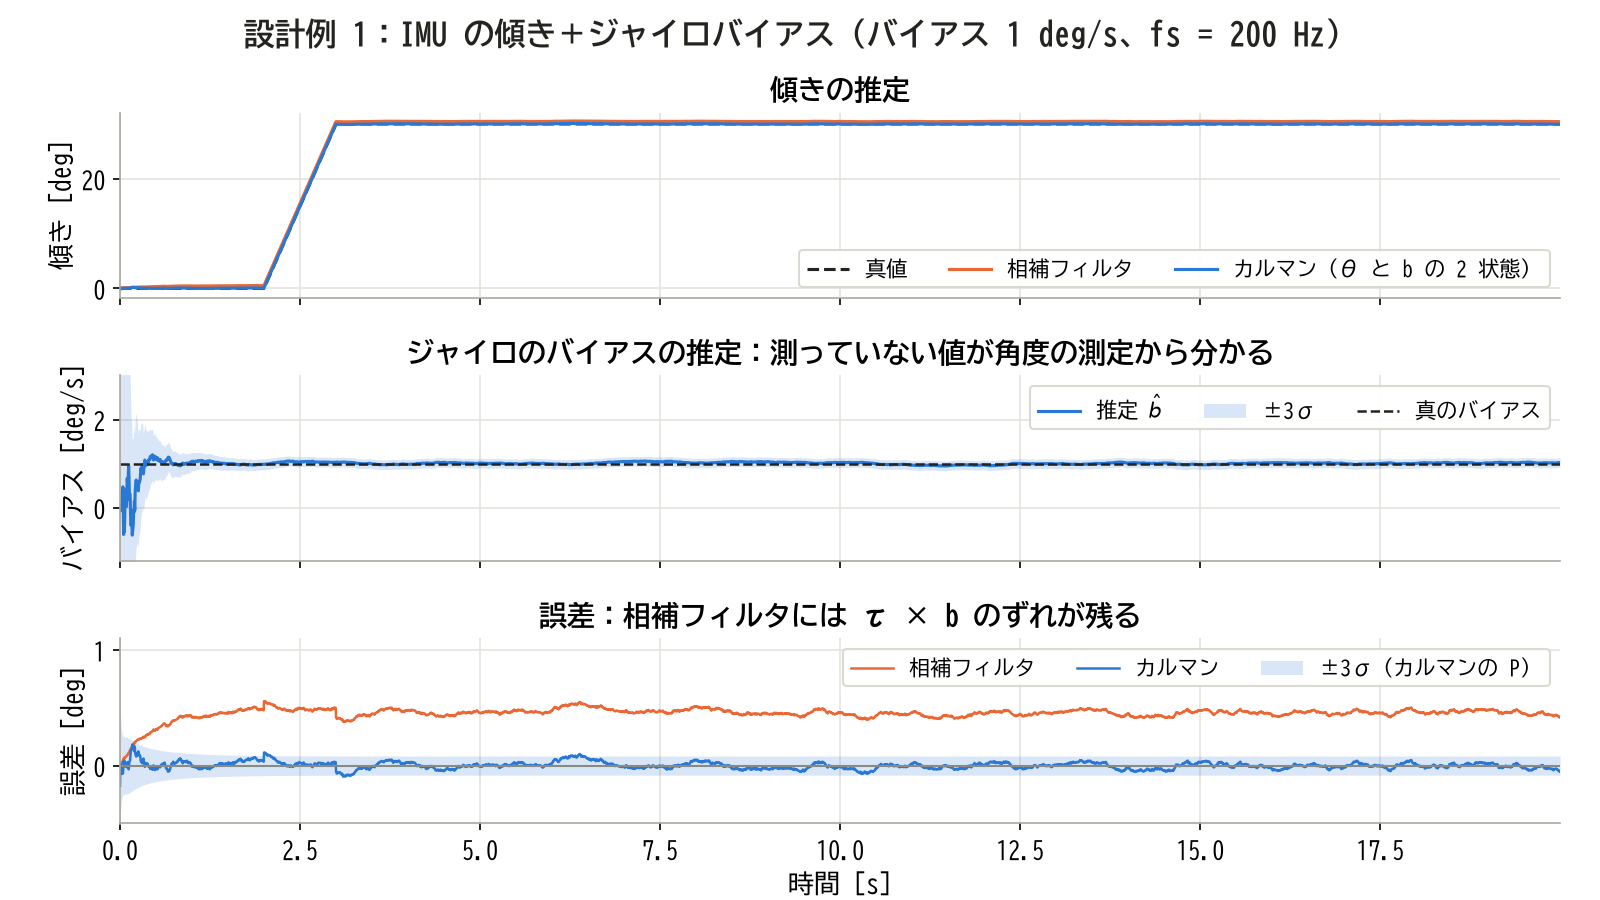
中段:測っていないバイアスが 1 秒足らずで真の値に近づく。下段:相補フィルタは 0.46° ずれたままで、2 状態のカルマンは ±3σ の帯の中に収まる
| 項目 | 相補フィルタ a = 0.9892 | 2 状態カルマン |
|---|---|---|
| 誤差の平均 | 0.457° | −0.002° |
| 誤差のばらつき | 0.019° | 0.023° |
| バイアスの推定 | なし | 1.004 deg/s |
ずれは τb の式どおりです。カルマンは K₁ を 0.0142 へ少し上げているので、ばらつきは 0.023° と少し増えますが、ずれは消えました。バイアスの推定は 0.7 秒で ±0.1 deg/s に入り、NIS の平均は 1.01、隣どうしの相関は 0.021 で、N = 3400 の範囲(1 ± 0.05、±0.034)に入っています。
設計例 2:エンコーダの位置から速度を推定する
要件: #2 の設計例と同じエンコーダ(1000 パルス/回転を 4 逓倍して 4000 カウント/回転。4 逓倍は A 相と B 相の両方のエッジを数えて分解能を 4 倍にすること)を、1 ms ごとに読んで速度を求めたい。1 サンプルの差分は 1 カウントが 15 rpm に相当し、値がガタつきます。
モデル: 等速モデルで、位置の単位をカウントにします。R は量子化から R = 1/12 カウント²です。Q の \sigma_a は、#2 の 10 点移動平均と同じ遅れになるように選びました。一定の加速度 a が続くときの定常の遅れを、「周波数で見る」の式から導きます。位置を 2 回差分すると aT^2 で、ν の伝達関数の分母は z = 1 で β なので、イノベーションの定常値は aT^2/\beta です。これを予測の式へ入れると、速度の遅れは次の式です。
\Delta\dot{p} = aT\left(\frac{\alpha}{\beta} - \frac{1}{2}\right)カッコの中に T を掛けた量が、速度の遅れの時間です。 \sigma_a = 350 rpm/s とすると Λ = 0.0808、α = 0.3306、β = 0.0661、K = [0.3306, 66.13] で、遅れは 4.50 ms になり、移動平均 10 点の 4.5 ms とそろいます。
遅れをそろえたうえで、速度が 1 次遅れで 0 → 1000 → 500 rpm と変わる信号のカウントを入力して比べます。上段が全体、左下が加速する区間の誤差、右下が 1000 rpm の一定区間の拡大です。
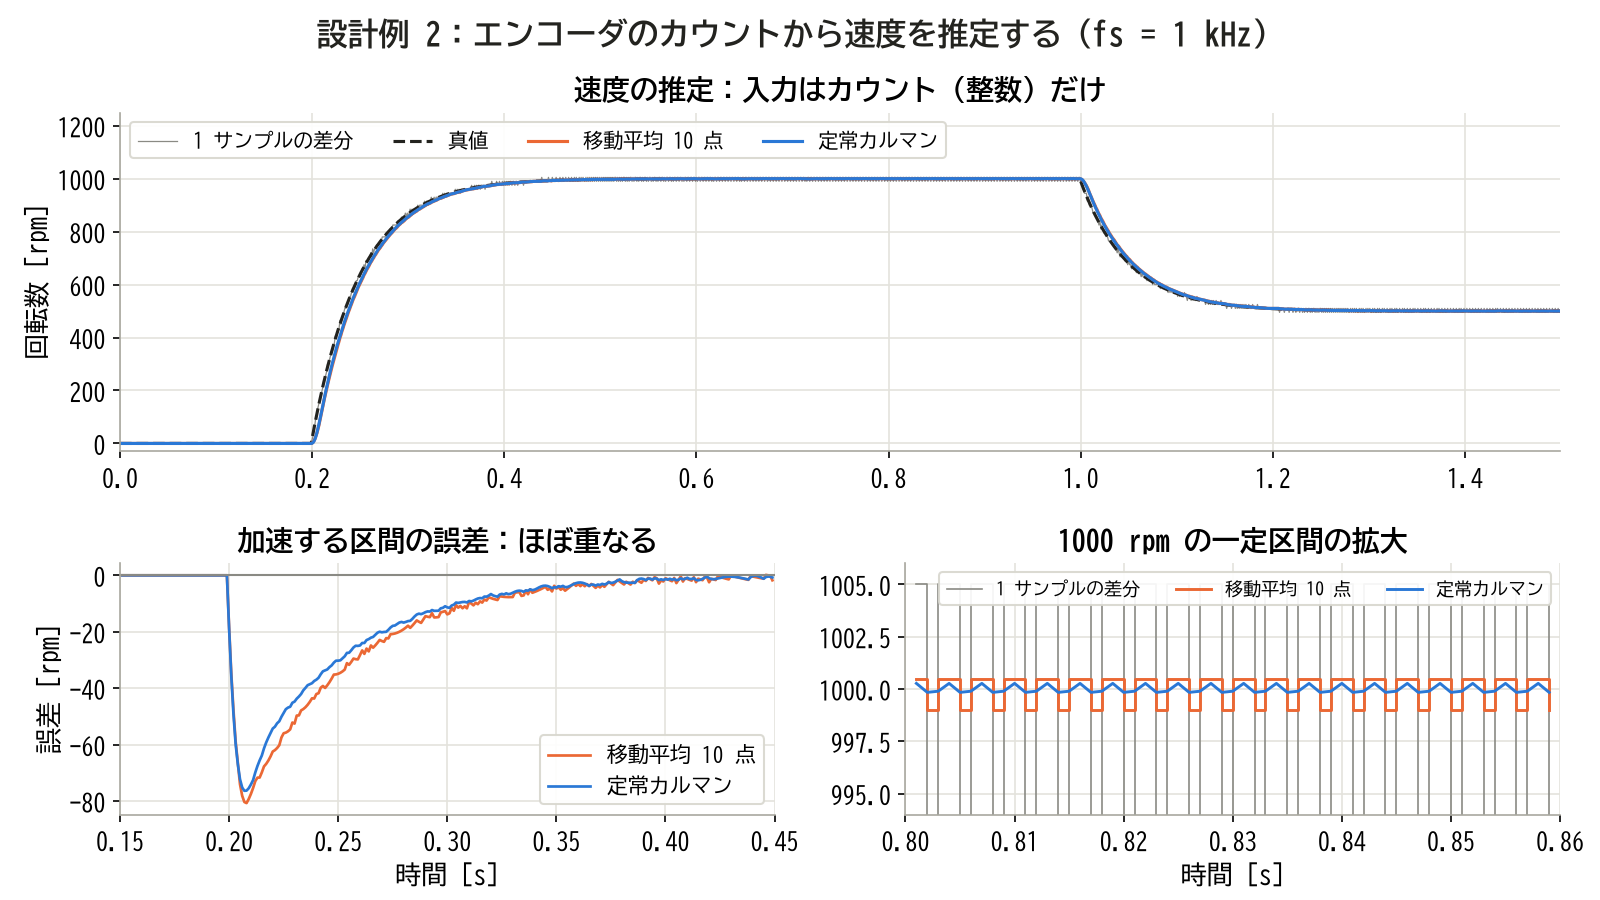
左下:同じ遅れにそろえたので、加速中の誤差はほぼ重なる。右下:灰色の差分は図の範囲を大きくはみ出す。移動平均は 1.5 rpm の段で揺れ、カルマンの揺れはそれより小さい
| 項目 | 差分 | 移動平均 10 点 | 定常カルマン |
|---|---|---|---|
| 1000 rpm の RMS 誤差 | 7.07 rpm | 0.71 rpm | 0.21 rpm |
| 加速中の最大誤差 | — | 81 rpm | 76 rpm |
| 状態変数 | 1 個 | 10 点ぶん | 2 個 |
同じ遅れで、定常のガタつきは 1/3 以下、必要なメモリは 2 変数です。ただし、この RMS は 1000 rpm での値です。一定の速度では丸めの誤差が周期的なパターンになり、白色ではないので、速度によって値が変わります。カウントの刻みより遅い低速では、丸め誤差と信号が連動し、R の前提がさらに崩れます。低速まで使うなら、パルスの間隔を測る方法と組み合わせます。
設計例 3:温度センサ
要件: 1 秒に 1 回読む温度センサの値(ノイズ σ = 0.1 °C)を滑らかに表示したい。部屋の温度はゆっくり動く。
モデル: スカラのランダムウォークで、A = 1、C = 1 です。R = 0.01 °C²、温度の 1 秒あたりの動きの標準偏差を 0.005 °C と見積もって Q = 2.5×10⁻⁵ °C² とします。
定常ゲイン: Q/R = 0.0025 だけで決まります。
K_\infty = \frac{-0.0025 + 0.10003}{2} = 0.0488時定数は約 20 秒、−3 dB は 0.008 Hz です。 P = K_\infty R = 4.88\times10^{-4} °C² で、推定の標準偏差は 0.022 °C です。カルマンの形で書く利点は、起動直後です。次の図の下段のように K は大きい値から始まって定常値へ下がるので、固定の α の 1 次 IIR のように、電源投入から値がゆっくり近づくことがありません。
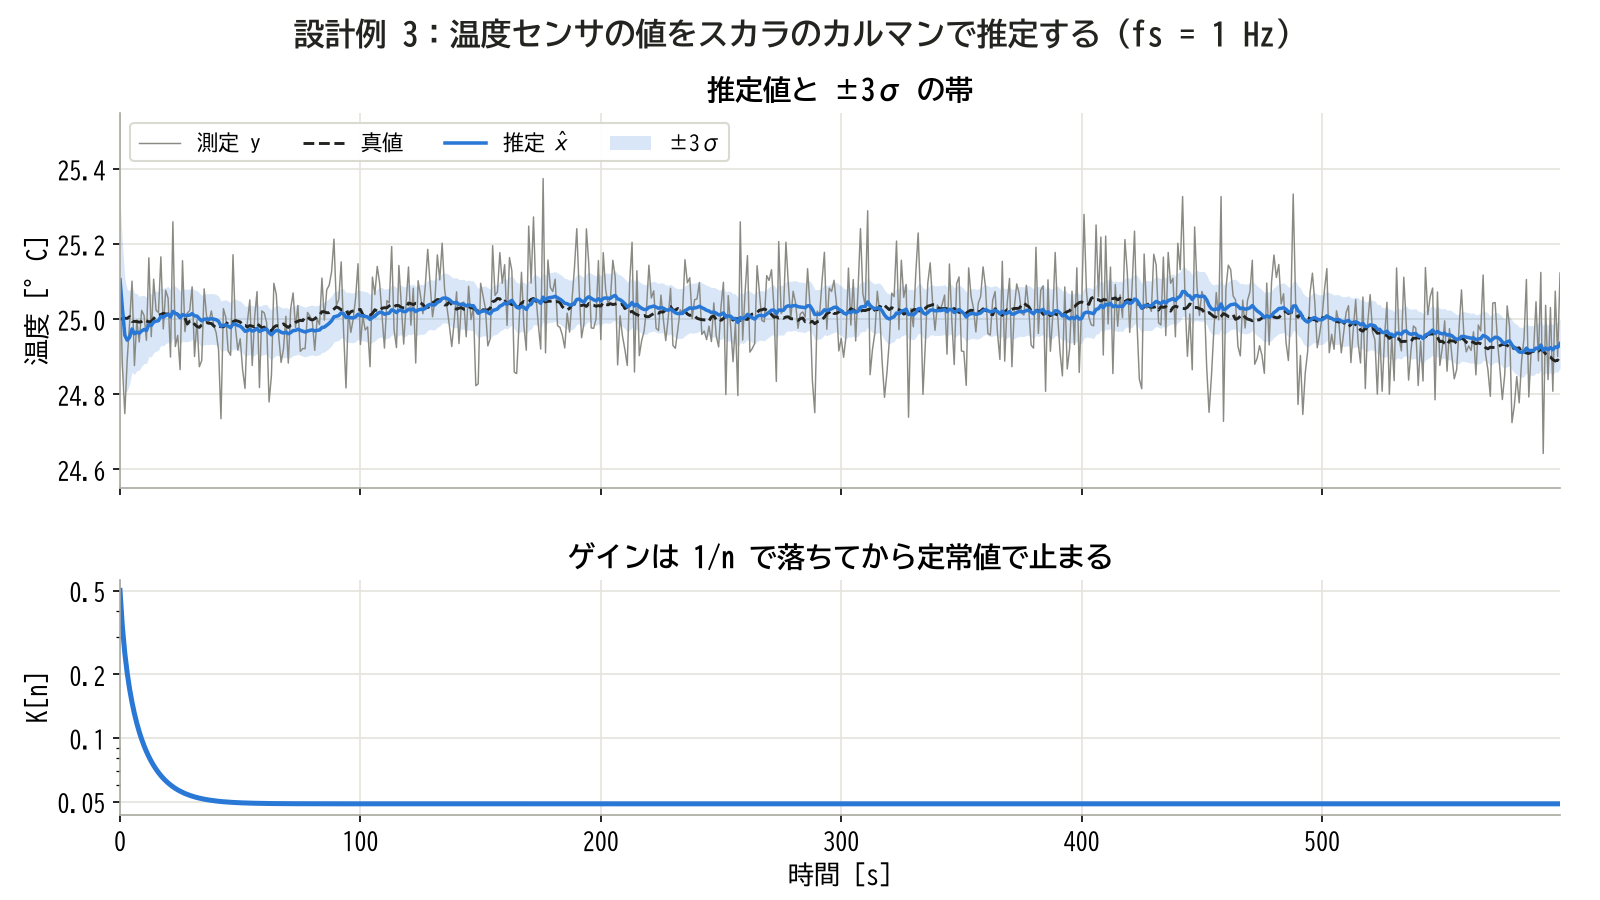
上段:推定値は測定のノイズを約 1/6 にし、真値を ±3σ の帯の中に収める。下段:K は 1/n のように落ちて、約 40 秒で定常値に止まる
シミュレーションの誤差 RMS は 0.017 °C で、生の測定の 0.107 °C の約 1/6 です。真値は全区間で ±3σ の帯に入りました。2 万サンプルの長いシミュレーションで見ると、NIS の平均は 0.998、隣どうしの相関は 0.009 です。
設計の手順は、ここまでです。次の章では、推定器を制御ループの中へ入れます。
🔁 制御ループでの効き
#2 では、センサのローパスフィルタ(LPF)を強くすると制御ループの余裕が減ることを見ました。同じループに定常カルマンを入れると何が変わるかを、位相余裕で確かめます。ここではカルマンフィルタを観測器(測定から内部の状態を見積もる部品)として使う範囲に絞り、最適な制御則の話には踏み込みません。
ループの条件
条件は #2 と同じです。モータは 1 次遅れで、ゲイン K = 1 ですが、カルマンゲインと区別するためにこの章では K_m と書きます。時定数は τ = 50 ms で、PI 制御(目標との差に比例した量と、差を積分した量を足して操作量を決める方式)は K_p = 3 、 K_i = 60 、T = 1 ms、ゼロ次ホールドで離散化します。センサのフィルタを G_s(z) とすると、ループを 1 か所で切って一周した伝達関数(開ループ伝達関数)は L = G_c\,G_p\,G_s です。 G_c(z) は PI 制御の伝達関数、 G_p(z) はモータの伝達関数で、 G_s(z) の添字 s はセンサを表します。ループの中の部品は、どれも G に役割の添字を付けた名前でそろえます(観測行列 C、誤差共分散 P、連続時間の行列 F に重ならないようにするためです)。
位相余裕は、ループを一周したゲインが 1 になる周波数で、位相があと何度遅れると −180° に届くかを表す値です。ゲイン余裕は、位相が −180° になる周波数で、ゲインをあと何 dB 上げるとゲインが 1 に届くかを表す値です。どちらもナイキスト線図で −1 点までの距離を別の測り方で表したものです。
速度センサの値を p と読み替えると、「等速モデル」は「速度が一定の傾きで変わる」モデルです。 G_s(z) に、前の章の H(z)(−3 dB 20 Hz)をそのまま使います。
位相余裕の比較
もう 1 つ、プラント(制御対象。ここではモータ)のモデルを入れた 1 状態のカルマンも比べます。 \rho = e^{-T/\tau} として、#2 の差分方程式をそのまま予測に使います。ρ は #2 で p と書いたモータの極で、1 サンプルで残る割合を表します(この記事の p は位置なので文字を変えます)。u は操作量です。
\hat{x}^-[n+1] = \rho\,\hat{x}[n] + K_m(1-\rho)\,u[n] \hat{x}[n] = \hat{x}^-[n] + K\,(y[n] - \hat{x}^-[n])K は、静止時のノイズの分散比 K/(2-K) が LPF 20 Hz の 0.0443 にそろう K = 0.0848 としました。このとき PI の計算は y ではなく \hat{x} を使います。センサの位置でループを切った開ループは次の式です( G_{sy} 、 G_{su} はそれぞれ y、u から \hat{x} までの伝達関数)。
L = \frac{G_c\,G_p\,G_{sy}}{1 + G_c\,G_{su}}4 通りのナイキスト線図と時間波形が次の図です。左は −1 点の近くで、丸印がゲイン 1 の点です。右上は目標値を 1 へ切り替えたときの速度(ノイズなし)、右下はセンサに σ = 0.02 のノイズを足したときの操作量です。
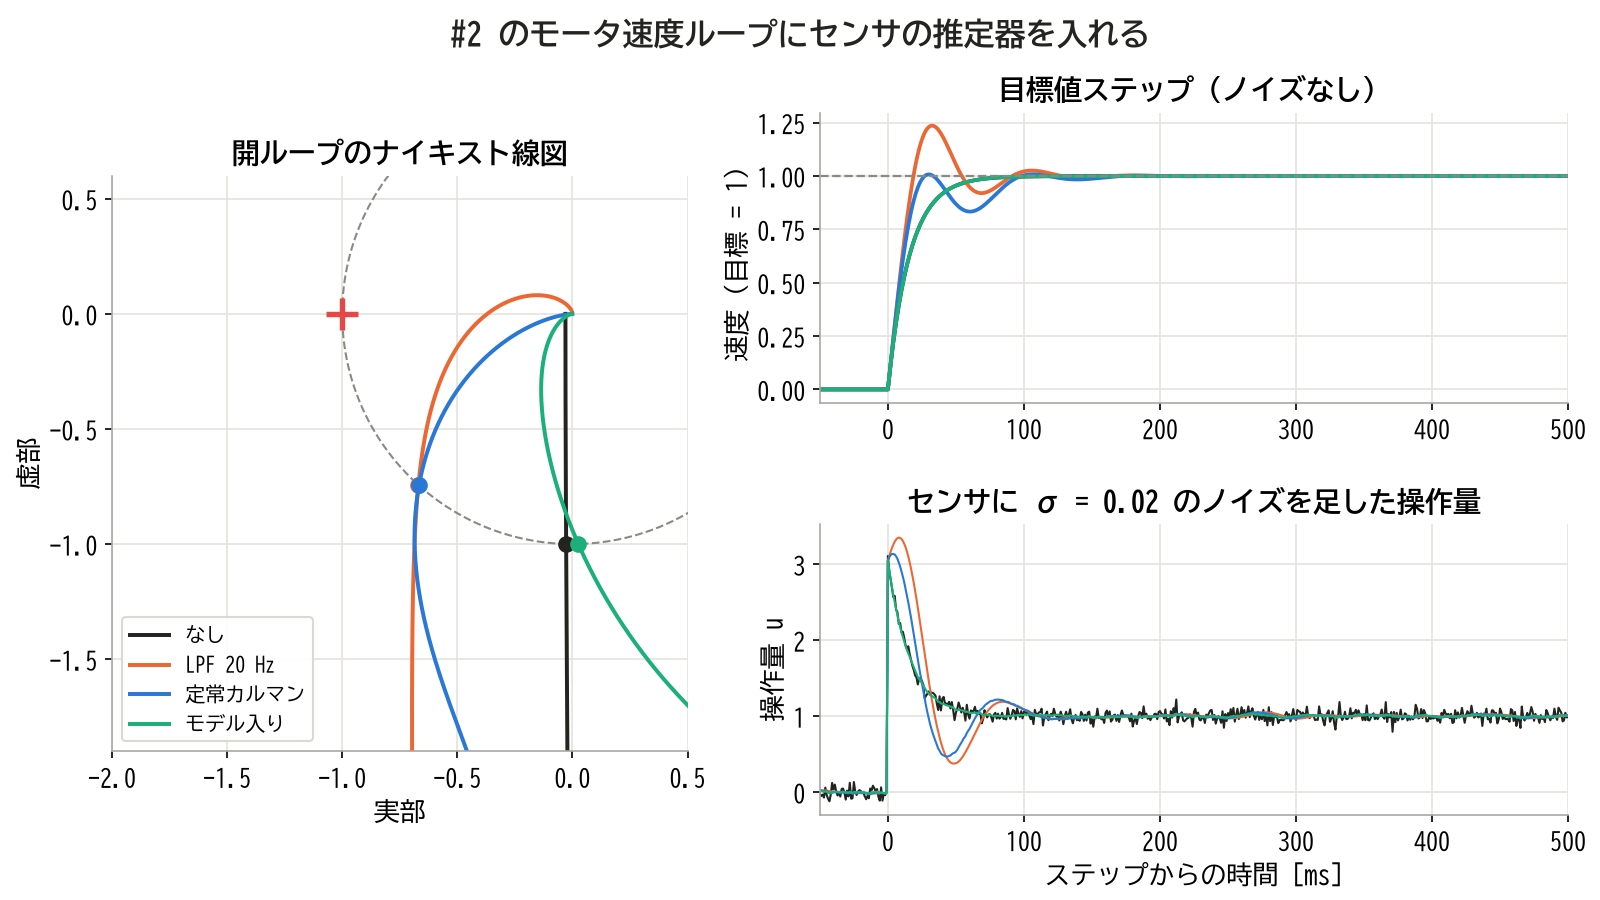
左:LPF と定常カルマンの丸印は単位円のほぼ同じ位置にあるが、カルマンの曲線は −1 点へ巻き込まない。右上:同じ位相余裕でも行き過ぎは大きく違う
| センサの処理 | 位相余裕 | ゲイン余裕 | −1 までの最短距離 |
|---|---|---|---|
| なし | 88.4° | 30.4 dB | 0.97 |
| LPF 20 Hz | 48.0° | 8.6 dB | 0.51 |
| 定常カルマン −3 dB 20 Hz | 48.2° | 57.7 dB | 0.60 |
| 定常カルマン −3 dB 13.8 Hz | 36.9° | 60.9 dB | 0.52 |
| モデル入り K = 0.0848 | 91.5° | 57.1 dB | 0.90 |
| センサの処理 | 分散比 | 行き過ぎ | ±2 % に入る時間 |
|---|---|---|---|
| なし | 1 | 0 % | 63 ms |
| LPF 20 Hz | 0.0443 | 23.5 % | 113 ms |
| 定常カルマン −3 dB 20 Hz | 0.0641 | 0.8 % | 91 ms |
| 定常カルマン −3 dB 13.8 Hz | 0.0443 | 16.1 % | 192 ms |
| モデル入り K = 0.0848 | 約 0.044 | 0 % | 63 ms |
操作量のノイズ RMS は、なしが 0.061、LPF 20 Hz が 0.016、定常カルマン 20 Hz が 0.016、13.8 Hz が 0.013、モデル入りが 0.009 です。
表から読めることは 3 つあります。
① −3 dB をそろえると、位相余裕はほぼ同じで、行き過ぎは大きく減る。 LPF 20 Hz のループのゲイン交差(ループを一周したゲインが 1 になる周波数)は 9.4 Hz です。同じ 9.4 Hz で比べると、カルマンの位相の遅れは 31° で、LPF の 40° より浅くなります。ところが、カルマンの振幅の山でループのゲインが持ち上がるので、カルマンのゲイン交差は 11.1 Hz へ上がります。そこでの遅れが 40° なので、位相余裕はそろってしまいます。一方、それより低い周波数ではカルマンの遅れはずっと小さく、高い周波数では位相が戻ります。ゲイン余裕が 57.7 dB と大きいのは、位相が −180° に届かず fs/2 の値になるからです。位相余裕は 1 点の値なので、同じ 48° でも時間応答は同じになりません。
② 分散比をそろえると、話は逆になる。 分散比を 0.0443 にそろえると −3 dB は 13.8 Hz まで下がり、位相余裕は 36.9° で LPF より悪くなります。等速モデルの定常カルマンは裾が広いので、同じノイズに抑えるには帯域を下げるしかないからです。「カルマンなら位相余裕が減らない」とは言えません。比較の条件を必ず書く必要があります。
③ 対象のモデルを入れると、別の世界になる。 モデル入りの推定器は、操作量 u を知っているので、測定の遅れを待たずに次の速度を計算できます。位相余裕はフィルタなしと同じ水準のまま、操作量のノイズは LPF より小さくなりました。
③はモデルが合っている場合の値です。モータのゲインが本当は 1.3 倍だと、このループの最終値は 1.042 になり、目標から 4 % ずれます。PI の積分が見ているのは y ではなく \hat{x} だからです。0.7 倍なら 0.930 です。時定数のずれ(50 ms に対して 100 ms)なら最終値はずれませんが、行き過ぎが 4.4 % 出ます。実機では、ずれを吸収する状態(外乱やゲイン誤差の推定)を足すか、K を上げて測定を信じる側へ寄せます。
推定器はループの中に入れても動きますが、測定を信じる量とモデルを信じる量の配分が、そのまま制御の性質になります。次の章では、その配分を間違えたときに起きることをまとめます。
🕳️ 落とし穴
カルマンフィルタの失敗は、式の間違いよりも、前提の外で使うことから起きます。代表的なものを順に見ます。
Q と R の過小と過大
モデルどおりに設計した Q を、1000 倍と 1/1000 倍にずらします。入力は「周波数で見る」と同じ、途中で速度が変わる信号です。上段が推定の誤差、下段がイノベーションです。見るのは、Q が小さい線の大きな遅れと、下段で同じ符号が続く区間です。
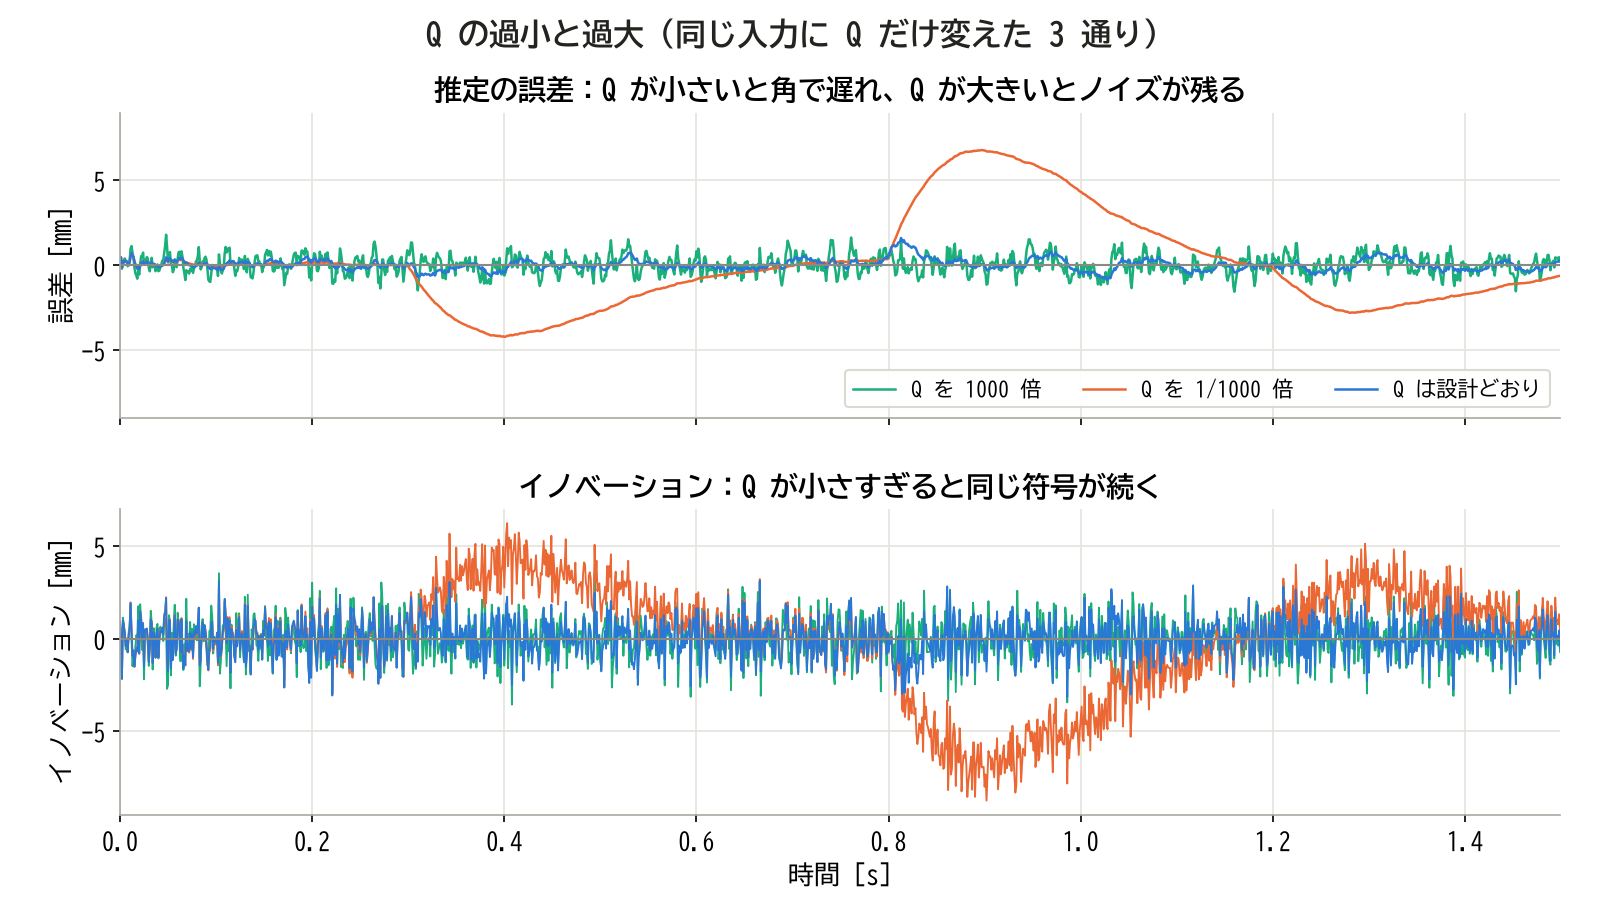
上段:Q が小さすぎると角で大きく遅れ、Q が大きすぎるとノイズが残る。下段:Q が小さすぎる線だけ、イノベーションが同じ符号のまま長く続く
| Q の倍率 | 誤差 RMS | NIS の平均 | ν の隣どうしの相関 |
|---|---|---|---|
| 1/1000 | 2.72 mm | 8.38 | 0.888 |
| 1(設計) | 0.33 mm | 0.96 | 0.025 |
| 1000 | 0.55 mm | 0.82 | −0.126 |
Q を小さくしすぎると、フィルタはモデルを過信します。P は小さいままなのに誤差は大きく、NIS が 8 を超えます。自分の出す ±3σ の帯の外に、真の値があるという意味です。Q を大きくしすぎると、測定を信じすぎてノイズが残り、イノベーションの相関が負へ振れます。どちらも、真の値を知らなくても表の右 2 列で検出できます。R の過小と過大は、Q の逆の向きに同じことが起きます。
モデルの不一致
等速モデルに一定の加速度が入ると、定常の遅れが残ります。 1-H の式で z = 1 を見ると、位置の遅れは次の値です。
\Delta p = \frac{1-\alpha}{\beta}\,aT^220 Hz の設計では \Delta p = 247\,aT^2 で、a が \sigma_a と同じ 3873 mm/s² のまま続くと 0.96 mm です。P が言う標準偏差 0.29 mm の 3 倍以上で、モデルの想定を超えています。対策は 3 つあります。Q を上げて帯域を広げる、状態に加速度を足して等加速度モデル(αβγ フィルタの形)にする、速い動きの間だけ Q を切り替える、です。
もっと本質的な不一致は、モデルが線形でない場合です。角度を含む動きや、距離と方位の測定は、A や C が状態によって変わります。このときは線形のカルマンフィルタをそのまま使えず、次回の EKF と UKF が必要になります。
P の数値誤差
更新の式 P = (I-KC)P^- は、大きな数から大きな数を引く計算を含みます。float(32 ビットの浮動小数点数)で P[0] が大きく R が小さいと、K が 1 に丸まり、 1 - K が 0 になります。 P[0] = 10^4 I 、R = 10⁻⁴ mm² で 1 ステップ計算すると、標準形では P_{11} が厳密に 0 になりました。Joseph 形なら K^2 R の項が残り、正しい 1.0×10⁻⁴ を返します。 P_{11} = 0 は「位置を完全に知っている」という誤った自信です。この例では Q のおかげで次のサンプルから戻り、定常ゲインはどちらも同じ値に収束しました。誤差がたまって P が対称でなくなったり、対角が負になったりすると、K の符号が狂って発散の原因になります。
対策は 3 つです。
- 対称な行列は上三角だけを持つ(C のコードはこの形です)
- Joseph 形を使う、または更新のあとに P \leftarrow (P + P^{\mathsf{T}})/2 とする
- 測定が 1 個で C = [1 0] の形なら、 P_{11} = K_1 R 、 P_{12} = K_2 R と計算する。 1-K の引き算がなくなる
初期値の影響
P[0] が大きければ、初期値の間違いはすぐ消えます。問題は、P[0] を小さく置いて初期値も間違っている場合です。K が小さいままなので、誤差が長く残り、NIS が大きくなります。起動直後の数十サンプルは、NIS を見て判定から外すのが安全です。定常ゲイン版(αβ)は K が小さい値に固定なので、起動直後の収束がもっとも遅くなります。最初の 2 回の測定から位置と速度を計算して初期値にすると、この遅さは避けられます。
サンプリング間隔のゆらぎ
A と Q は T を含むので、実際の間隔が設計の T からずれると、予測がずれます。予測の位置の誤差は、速度 × 間隔のずれです。100 mm/s で 0.1 ms ずれれば 0.01 mm で、P の 0.29 mm より十分に小さい値です。ゆらぎが大きいシステムでは、タイムスタンプから毎回の T を計算し、A と Q を作り直します。逆に、測定が抜けたときは、更新を飛ばして予測だけを回せば正しく扱えます。P が増えるので、次の測定を強く信じるようになります。これは、固定係数のフィルタにはない利点です。
固定小数点での P の桁
P の成分は桁が大きく離れています。「周波数で見る」の設計では、Q の左上が 3.75×10⁻⁶、P の右下が 333 で、8 桁あります。#1 の Q16(小数部を 16 ビット持つ固定小数点の形式)の分解能は 1/65536 = 1.5×10⁻⁵ なので、Q の左上は 0 に丸まって消えてしまいます。FPU(浮動小数点の計算回路)のないマイコンでは、K が毎回変わる時変のカルマンを固定小数点で回すより、PC で定常ゲインを計算し、K だけを固定小数点の αβ で使うのが現実的です。
落とし穴を押さえたところで、次の章で式をコードにします。
💻 実装
ここまでの式をコードにします。行列のライブラリがなくても、2 状態なら展開して 20 行ほどで書けます。
C:2 状態のカルマンフィルタ
等速モデル、測定 1 個の float 版です。P は対称なので 3 個だけ持ちます。
typedef struct {
    float T;                 // サンプリング周期 [s]
    float q11, q12, q22;     // プロセスノイズの共分散 Q
    float r;                 // 観測ノイズの分散 R
    float pos, vel;          // 推定値(位置と速度)
    float P11, P12, P22;     // 誤差共分散 P(対称なので 3 個)
} kf2_t;

void kf2_init(kf2_t *f, float y0, float var_vel)
{
    f->pos = y0;
    f->vel = 0.0f;
    f->P11 = f->r;           // 位置の不確かさは測定 1 回ぶん
    f->P12 = 0.0f;
    f->P22 = var_vel;        // 速度の不確かさは想定の最大速度の 2 乗程度
}

float kf2_step(kf2_t *f, float y)
{
    const float T = f->T;

    // 予測:x^- = A x、P^- = A P A^T + Q
    float x1 = f->pos + T * f->vel;
    float x2 = f->vel;
    float p12 = f->P12 + T * f->P22;
    float m11 = f->P11 + T * (f->P12 + p12) + f->q11;
    float m12 = p12 + f->q12;
    float m22 = f->P22 + f->q22;

    // 更新:S = P^-_11 + R、K = P^- C^T / S
    float S = m11 + f->r;
    float K1 = m11 / S;
    float K2 = m12 / S;
    float nu = y - x1;       // イノベーション

    f->pos = x1 + K1 * nu;
    f->vel = x2 + K2 * nu;

    // P = (I - K C) P^-。C = [1 0] なら次の 3 行に整理できる
    f->P11 = K1 * f->r;
    f->P12 = K2 * f->r;
    f->P22 = m22 - K2 * m12;

    return f->pos;
}
\hat{x}^- と P^- の成分を素直に展開しただけです。「周波数で見る」の設計なら、次の初期化子で使えます。単位は mm と秒です。
static kf2_t kf = {
    .T = 0.001f,
    .q11 = 3.75e-6f, .q12 = 7.5e-3f, .q22 = 15.0f,   // sa = 3873 mm/s^2
    .r = 1.0f,                                       // R = 1 mm^2
};
このコードに合成信号を 5000 サンプル入れると、倍精度で同じ式を回した結果との差は最大 1.3×10⁻⁴ mm でした。P は [0.08424, 3.706, 333.4] に収束し、Python の定常値と一致します。呼び出す前に、kf2_init() に最初の測定値を渡します。
C:定常ゲイン版(αβ)
K を定数にすると、P の計算がなくなります。計算は掛け算 3 回です。
typedef struct {
    float T, alpha, K2;      // K2 = beta / T
    float pos, vel;
} ab_t;

float ab_step(ab_t *f, float y)
{
    float x1 = f->pos + f->T * f->vel;
    float nu = y - x1;
    f->pos = x1 + f->alpha * nu;
    f->vel += f->K2 * nu;
    return f->pos;
}
\alpha = 0.08424、K2 = 3.7062 を入れると、起動直後の約 50 サンプル(K が定常値に近づくまで)が過ぎたあとの出力は、上の kf2_step() とほぼ一致します。
Python:設計値を計算する
定常ゲインは、多次元のリカッチ方程式を SciPy の solve_discrete_are で解いて求めます。この関数は本来、制御の方程式
A^{\mathsf{T}}XA - X - A^{\mathsf{T}}XB(R+B^{\mathsf{T}}XB)^{-1}B^{\mathsf{T}}XA + Q = 0
を解くものです。カルマンの
P^-
の定常式は、A を
A^{\mathsf{T}}
に、B を
C^{\mathsf{T}}
に置き換えると同じ形になるので、引数を転置して渡します。
import numpy as np
from scipy.linalg import solve_discrete_are

T = 1e-3            # サンプリング周期 [s]
sa = 3873.0         # 想定する加速度の標準偏差 [mm/s^2]
R = 1.0             # 観測ノイズの分散 [mm^2]

A = np.array([[1, T], [0, 1]])
C = np.array([[1.0, 0.0]])
G = np.array([[T**2 / 2], [T]])
Q = sa**2 * G @ G.T

Pm = solve_discrete_are(A.T, C.T, Q, np.array([[R]]))   # 予測の共分散 P^-
S = (C @ Pm @ C.T).item() + R
K = Pm @ C.T / S
P = (np.eye(2) - K @ C) @ Pm

print("K =", K.ravel())
print("alpha, beta =", K[0, 0], K[1, 0] * T)
print("poles =", np.linalg.eigvals((np.eye(2) - K @ C) @ A))
K = [0.08424303 3.70627478]
alpha, beta = 0.08424302718677966 0.0037062747772996993
poles = [0.95602535+0.04210113j 0.95602535-0.04210113j]
出てきた α と β は、「周波数で見る」の式で分母と分子の係数になります。scipy.signal.freqz に渡せば、ボード線図まで同じ手順で描けます。
コードがそろいました。最後に、カルマンフィルタが実際にどこで使われているかを見ます。
💡 活用事例
カルマンフィルタが使われる場面を、「なぜカルマンなのか」の理由とともに挙げます。実際の製品の多くは線形でないモデルを扱うので、モデルをその場で線形に近似する拡張カルマンフィルタ(EKF)を使っています。
宇宙機の航法。 カルマンフィルタが実用の道具になった最初の舞台は、1960 年代初めの NASA エイムズ研究センターでのアポロ宇宙船の月周回航法の研究です。航法の計算は宇宙船の搭載計算機で動かす必要があり、当時の重み付き最小 2 乗法は重すぎました。測定が届くたびに前の結果を更新するだけで済む再帰の形が、ここで効きました。
ドローンの姿勢と位置。 オープンソースの飛行制御ソフト PX4 は、EKF で姿勢、速度、位置に加えてジャイロと加速度センサのバイアスを推定しています。設計例 1 の θ と b の形を、3 次元へ広げたものです。
GNSS+IMU。 GNSS は絶対位置を遅い周期で、IMU は相対的な動きを速い周期で教えます。相補フィルタの考え方と同じ組み合わせで、測定の周期が違っても、届いたものだけ更新すればよいカルマンの形が向いています。
バッテリーの残量推定。 SoC(充電状態)は直接測れず、電流の積算はドリフトします。電圧のモデルと組み合わせて推定するのが、Plett の 2004 年の連作の EKF です。測れない状態を推定する、設計例 1 と同じ構図です。
レーダーと目標追尾。 αβ フィルタは、レーダーの追尾から育ちました。Benedict と Bordner の 1962 年の論文は、追尾の平滑化の式を扱っています。計算機の力が小さかった時代に、定常ゲインの軽さが効いた分野です。
ロボットの位置推定。 車輪の回転、IMU、外界のセンサを 1 つの推定にまとめます。ROS(ロボット用のソフトウェア基盤)の robot_localization は、線形でない状態推定のためのパッケージです。
✅ まとめ
- カルマンフィルタは、周波数ではなくモデルと分散で切り分ける。Q はモデルを、R はセンサをどれだけ疑うかを表す
- 予測で不確かさを足し、更新で K = P^-C^{\mathsf{T}}S^{-1} を掛けて戻す。5 本の式は最小分散の条件から 1 段ずつ導ける
- 定数の推定では K は 1/n で平均と一致し、Q > 0 では定常値に止まって #2 の 1 次 IIR と同じ形になる。定常値は Q/R の比だけで決まる
- 等速モデルの定常カルマンは 1-H に 2 重の零点を持ち、傾き一定の入力を遅れなく通す。代わりに +2 dB の山と −20 dB/decade の裾を持つ
- 相補フィルタは 1 状態の、αβ フィルタは 2 状態の定常カルマンで、ゲインを Q/R や Λ から計算できる
- 設計は要件、モデル、Q と R、初期値、検証の順に進め、NIS とイノベーションの相関で判定する
ここまでで、線形のモデルを持つ対象なら、要件からカルマンフィルタを設計して C で動かせるようになりました。次の一手は、手元のセンサで静止時の分散を測って R を決め、この記事の Python で定常ゲインを計算してみることです。
ただし、ここまでのモデルはすべて線形でした。姿勢の角度を含む回転、距離と方位を測るセンサでは、A や C が状態によって変わるので、そのままでは使えません。次回の #6 では、モデルをその場で線形に近似する EKF と、代表点を流して分布を運ぶ UKF へ進みます。
よくある質問(FAQ)
Q. カルマンフィルタとローパスフィルタの違いは何ですか?
A. ローパスは周波数だけを見て、信号の中身を知りません。カルマンフィルタは信号のモデルとノイズの分散を持ち、測定をどれだけ信じるかをサンプルごとに計算します。定常状態ではどちらも線形のフィルタで、等速モデルのカルマンなら、傾き一定の入力を遅れなく通す形のフィルタになります。
Q. Q と R はどうやって決めますか?
A. R はセンサを静止させて分散を測るか、ノイズ密度 n と帯域から \sigma^2 = n^2 B_n で求めます。Q は想定する加速度などの物理量から見積もります。定常ゲインは Q/R の比で決まり、等速モデルの帯域はその 4 乗根でしか動かないので、Q は桁が合っていれば働きます。最後に NIS の平均が 1 に近いことを確かめます。
Q. 相補フィルタとカルマンフィルタはどちらを使えばいいですか?
A. バイアスが小さく、計算を軽くしたいなら相補フィルタで十分です。相補フィルタは 1 状態の定常カルマンなので、a は Q/R から決められます。バイアスが効く、測定の周期が不規則、起動直後の収束を速くしたい、といった場合はカルマンにします。この記事の例では、バイアス 1 deg/s で相補フィルタに 0.46° のずれが残り、2 状態のカルマンでは消えました。
Q. 時変のカルマンと定常ゲインのどちらを実装すべきですか?
A. fs が一定で測定が抜けないなら、定常ゲイン(αβ)が軽くて十分です。起動直後の収束が大事、測定が抜ける、サンプリング間隔が揺れる、センサの精度が途中で変わる、といった場合は時変のカルマンを使います。2 状態なら C の約 30 行で書けます。
Q. カルマンフィルタを入れると制御の位相余裕は減りませんか?
A. 減ります。等速モデルの定常カルマンを #2 のループに入れると、−3 dB 20 Hz で位相余裕は LPF と同じ 48° でした。行き過ぎは 23.5 % から 0.8 % へ減りましたが、ノイズの分散比をそろえると位相余裕は 37° に下がります。対象のモデルと操作量を入れた推定器なら 91° を保てますが、モデルのずれが定常の偏差として出ます。
関連記事
この連載:
- #1 基礎編 — 伝達関数、ボード線図、白色ノイズの測り方、C の骨格
- #2 ローパスフィルタの設計 — 同じカットオフでの比較とナイキスト線図
- #3 ハイパスフィルタの設計 — DC とドリフトを消す
- #4 バンドパスとノッチの設計 — 狙った周波数を扱う
- #6 EKF・UKF の設計 — ヤコビ行列とシグマ点、線形化が破れる条件
センサの入口:
- 加速度センサ KXR94-2050 で作るデジタル水平器 — 重力の向きから角度を計算する
- Arduino の AD 変換とシリアル通信 — ADC の値を読む基本
参考
取得日はいずれも 2026-11-06 です。図と数値はすべて筆者が Python(NumPy 2.4.6、SciPy 1.17.1、Matplotlib 3.11.2)で計算したものです。
カルマンフィルタ
- R. E. Kalman「A New Approach to Linear Filtering and Prediction Problems」(Transactions of the ASME, Journal of Basic Engineering, 82 (Series D), 35–45, 1960)
- Greg Welch, Gary Bishop「An Introduction to the Kalman Filter」(UNC-Chapel Hill TR 95-041、2004 年 4 月 5 日版)
- Leonard A. McGee, Stanley F. Schmidt「Discovery of the Kalman Filter as a Practical Tool for Aerospace and Industry」(NASA TM-86847、1985 年)
- Yaakov Bar-Shalom, X. Rong Li, Thiagalingam Kirubarajan「Estimation with Applications to Tracking and Navigation」(Wiley)
- Dan Simon「Optimal State Estimation」(Wiley)
相補フィルタと αβ フィルタ
- Walter T. Higgins「A Comparison of Complementary and Kalman Filtering」(IEEE Trans. Aerospace and Electronic Systems, AES-11(3), 321–325, 1975)
- Paul R. Kalata「The Tracking Index: A Generalized Parameter for α-β and α-β-γ Target Trackers」(IEEE Trans. Aerospace and Electronic Systems, AES-20(2), 174–182, 1984)
- T. R. Benedict, G. W. Bordner「Synthesis of an Optimal Set of Radar Track-While-Scan Smoothing Equations」(IRE Trans. Automatic Control, 7, 27–32, 1962)
活用事例
- PX4 Guide「Using PX4’s Navigation Filter (EKF2)」
- Gregory L. Plett「Extended Kalman filtering for battery management systems of LiPB-based HEV battery packs」(Journal of Power Sources, 134, 2004)
- cra-ros-pkg/robot_localization
設計ツール(SciPy v1.18.0 Manual)