- Next.js 16.3 / React 19.3 / TypeScript 6.0 / Node.js 22 / Windows 11 で書いています。Jev は Vercel AI Gateway 経由の
typesafe-ai/jevを使い、TypeSafe AI への直接接続は試せていません(早期アクセスが満員だったため) - 実験結果(48 回の審査で見えた 3 つの意外・スコア表・修正実験)は Qiita の実験レポートに書きました → コードを少しずつ壊して Jev の境界を測る ― 0.4 秒で答える審査員を信用する条件(48 回の審査)(Qiita)。この記事はアプリの設計と、実用にするときの設計案が主題で、結果は要点だけ引きます
- ソースコードと実測データ(CSV / JSON)は GitHub の
jev-code-judgeに公開しています。本文で引く行は 2026-09-22 時点のものです - Jev・Vercel AI Gateway の仕様と料金は公式ドキュメントを 2026-09-22 に取得した内容です。Gateway の Jev はプロモーション価格(Free)が 2026-09-25 までと表示されており、その後の単価は未確認です
はじめに:文章を書かない AI に、コードの良し悪しを聞く
先に「何のため」を書きます。目指しているのは、コードを書いた瞬間、あるいは PR を出した瞬間に、本番に出せるかの校正済みの判定が 0.4 秒・ほぼ 0 円で返ってくる状態です。今回の実測は 1 回 382 ms、Gateway 側の費用は 0(プロモーション価格)、TypeSafe の公表単価で 48 回ぶんを計算しても $0.0012 でした。これが成り立つと、レビューは「人が全部読む」から「機械が迷ったところだけ人が読む」に変わります。安いから 1 回で決めず、30 回聞いて分布で判断できる。エディタの横でコードを直すたびに判定が更新されるこのアプリと、後半で書く CI ゲートの設計案は、その原型のつもりで作りました。
ただ、その前に確かめないといけないことがあります。審査員が何に反応し、どこで判定を変え、どれくらいブレるのか。それを知らずに閾値を置けば、境界の上にいるコードを機械的に落とすゲートができあがります。だから今回は、まず審査員の境界と癖を測ることにしました。それがこの実験の目的で、アプリはそのための測定器です。
2026 年 9 月 15 日に TypeSafe AI が公開した「Jev」は、文章を生成しません。状態(テキスト)と型の決まった質問を渡すと、答えと確率だけが返ってきます。「このコードを本番に出していいか」を聞けば、SHIP / CAUTION / REJECT のどれかと、それぞれの確率が 300 ms 台で返る。理由は一言も書かれません。
理由を書かない審査員の頭の中を覗くには、入力を少しずつ変えて反応を見るしかない。そこで、正常な TypeScript の関数に any・入力検証の削除・例外の握りつぶし・SQL 文字列結合・eval() を 1 つずつ足していき、判定が変わる地点を記録する Web アプリ「Jev Code Judge」を作りました。Next.js の Route Handler から Vercel AI Gateway を経由して Jev を呼び、Monaco エディタでコードを見ながら、ボタン 1 つで再審査できます。
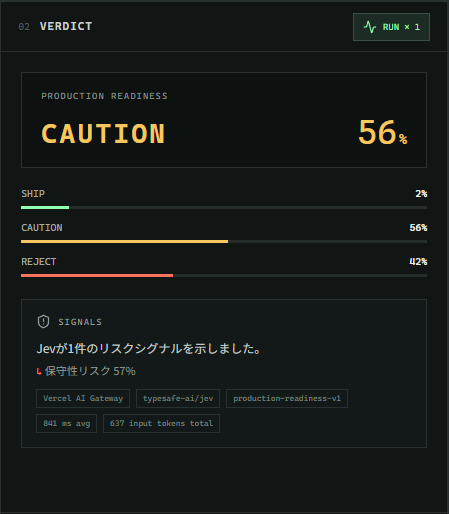
判定パネル。ラベルと 3 つの確率、50% を超えたリスクシグナル、そして接続元・モデル・プロンプト版・所要時間・トークン数のチップ。実験条件が結果と同じ画面に出る
実験そのものの結果は Qiita に書きました。この記事で扱うのは、その裏側です。
- 判断特化 AI とは何で、LLM と何が違うのか
- Jev を試せる 4 つの経路と、Vercel AI Gateway を選んだ理由
- アプリの設計:API キーをどこに置くか、シミュレーターと実測をどう分けるか、実験条件をどう記録するか
- Gateway のキー発行から
JEV LIVE表示までの手順 - 実用にするなら:CI ゲートの構成、閾値の置き方、コスト試算、そして今回の実装で捨ててしまった情報
🧭 判断特化 AI とは:LLM を「型のある関数」に置き換える
Jev を理解するいちばん速い方法は、関数のシグネチャで考えることです。
プロンプト(文字列)"] --> B["LLM
RLHF で訓練"] --> C["出力:文章
トークンを逐次生成"] D["Jev への入力
state + 型付きの質問
Choice / Score / Noul"] --> E["Jev
RLCD で訓練"] --> F["出力:答えと確率
全質問を並列に評価"]
LLM は string → string です。返ってくる文章を JSON に整形させ、パースし、想定外の文字列が混ざっていたら再試行する。「JSON で返して」と頼んだ経験がある人なら、この脆さは体で知っていると思います。
TypeSafe AI が System One モデルと呼ぶ Jev は、入口と出口の型が最初から決まっています。入力は state(文字列・JSON・テキストの配列。画像や音声は 2026-09-22 時点で非対応)と、型を宣言した質問の集合。出力は質問ごとの答えと確率です。
| 質問の型 | 聞き方 | 返ってくるもの |
|---|---|---|
| Choice | 決まった選択肢からどれか(最大 255 個) | choice(最も確率の高い選択肢)・選択肢ごとの probabilities・confidence |
| Score | 段階の定義(rubric)に対してどのレベルか | score・レベルごとの probabilities・confidence |
| Noul | Yes / No の命題 | Yes の確率(0〜1)。confidence は付かない。Vercel AI Gateway では型名が boolean |
名前の由来は Kahneman の「速い思考(システム 1)/遅い思考(システム 2)」で、公式ドキュメントは「速くて焦点の絞られた判断」に重きを置いたモデルだと説明しています。訓練方法は RLCD(Reinforcement Learning for Calibrated Decisions)。文章の好ましさ(RLHF)でも検証可能な正解(RLVR)でもなく、「返した確率が結果の頻度と一致すること」を目標にしたと公式は述べています。0.8 と言った事象は 8 割起きる、という意味の校正です。ただし校正は予測の集団に対する性質で、1 件の答えが正しい保証ではない、とも明記されています。
確信度は「確率の散らばり」から作られる
Choice と Score の答えに付く confidence は、確率分布の形を 0〜1 の 1 つの数字に潰したものです。1 つの選択肢に確率が集中していれば 1 に近く、均等に散らばっていれば 0 に近い。ドキュメントのデモは 3 択の場合を (3 × 最大確率 − 1) / 2 で近似しています。
この数字が効いてくるのは、コードが判断を信じるかどうかを決めるときです。公式ドキュメントは確信度を 3 つの範囲に分けて扱う型を示しています。
| 確信度 | コードの動き |
|---|---|
| 高 | 自動で実行する |
| 中 | 慎重に進める(確認を取る・レビューに回す・情報を足す) |
| 低 | 実行しない(人に回す・別の仕組みに落とす) |
境界の値は用途とリスクで変え、「保守的な閾値から始めて自分のデータで調整する」のが公式の勧めです。これは後半の CI ゲートの設計でそのまま使います。
「同じ形の判断を大量にさばく」ための道具
Jev は 1 リクエストに複数の質問を入れると並列に評価します。公式ブログの数字では応答は 70〜500 ms、料金は入力 $0.042 / MTok で出力は無料。出力トークンが「安すぎて課金できない」のは、文章を生成しないからです。
用途もはっきりしています。公式は「コーディングエージェントの LLM を Jev に置き換えることはできない」と明言していて、Jev が向くのは、決まった行き先へのルーティング、rubric に沿った採点、文書や記録に対する真偽の判定、そして「JSON を返して」と LLM に頼んでいた箇所の置き換えです。同じ形の判断が、毎日、大量に発生する場所。コードレビューの一次判定は、その典型だと思って今回の題材にしました。
- state:判断の対象。今回は
{ language: "TypeScript", code: "...", context: "本番デプロイ直前のレビュー" }という JSON を渡しています - criteria:Choice の各選択肢や Noul の Yes / No に付ける説明文。「
ship= そのまま出せる」「reject= 重大なリスクがある」のように定義します。質問文(instructions)と criteria を変えると同じコードでもスコアが動くので、アプリではpromptVersionとして版管理しました
🧰 試す経路は 4 つ:直接は満員、Gateway で即日
Qiita のイベントページ(2026-09-22 取得)が挙げる経路は 4 つです。本命の TypeSafe 直接は、サインアップ画面に「Whoops, we’re full」と出て入れませんでした(イベントページでは Waitlist 登録が必要と案内されています)。
Next.js
Route Handler"] APP -.->|"満員
Waitlist"| TS["TypeSafe AI 直接
/v1/systemone
jev-latest"] APP ==>|"今回採用"| VC["Vercel AI Gateway
/v1/evaluate
typesafe-ai/jev"] APP -.-> OR["OpenRouter
typesafe/jev-latest"] APP -.-> CF["Cloudflare Workers AI
typesafe/jev(Beta)"] TS --> JEV["Jev"] VC ==> JEV OR --> JEV CF --> JEV
| 経路 | モデル名・エンドポイント | 料金(2026-09-22 取得) |
|---|---|---|
| TypeSafe AI 直接(満員で不可) | jev-latest・api.typesafe.ai/v1/systemone |
入力 $0.042 / MTok・出力無料(公式ブログ) |
| Vercel AI Gateway(採用) | typesafe-ai/jev・ai-gateway.vercel.sh/v1/evaluate |
Free(「Promotional pricing ends on September 25, 2026」)・Free Tier 対象・Context 32K |
| OpenRouter(未使用) | typesafe/jev-latest |
入力 $0.042 / M・出力 $0.00 / M・Context 32,000 |
| Cloudflare Workers AI(未使用) | typesafe/jev・/ai/run(Beta) |
単価はダッシュボード参照(ページに記載なし) |
Vercel を選んだ理由は 3 つです。
- その日のうちに始められる。 ダッシュボードで API キーを 1 本発行し、環境変数に入れるだけ。Jev は Free Tier 対象なのでクレジットを買わずに試せます(無料クレジットの利用には支払い方法の登録が必要、とドキュメントにあります)
- リクエストの形が TypeSafe 直接とほぼ同じ。
stateとquestionsを JSON で送る形は共通で、違いはエンドポイント・モデル名・Noul の型名(Vercel ではboolean)だけ。アプリはJEV_PROVIDERの 1 変数で接続先を切り替えられるように作りました - ログが残る。 Gateway のログ画面に 1 リクエストごとの状態・モデル・トークン数・費用・所要時間が並びます。実験の裏付けを自分で数えなくていい
Vercel AI SDK には experimental_evaluate という Jev 向けの関数も用意されていますが、今回は SDK を入れず fetch で直接叩いています。リクエストの JSON を自分で組む方が、後で TypeSafe 直接に切り替えるときの差分が見えるからです。
🏗️ アプリの設計:キーは外に出さない、実測とシミュレーターは混ぜない
構成は 1 枚に収まります。ブラウザは Jev の存在を知らず、/api/judge にコードを投げるだけです。
Monaco エディタ・Mutation ボタン
履歴・Recharts のグラフ・CSV / JSON 出力"] -->|"POST /api/judge
{ code, perspective }"| R["Route Handler
app/api/judge/route.ts"] R -->|"キー未設定"| L["ローカルシミュレーター
lib/judge.ts(正規表現+重み)"] R -->|"キー設定済み"| J["lib/jev.ts(server-only)
state+3 問の JSON を組む
Bearer キーはここでだけ読む"] J -->|"POST /v1/evaluate
model: typesafe-ai/jev"| G["Vercel AI Gateway"] G --> V["Jev"] V -.->|"answers + usage"| J J -.->|"Judgment
判定・確率・シグナル・ms・tokens"| B
使った部品は Next.js 16(App Router)・React 19・TypeScript、エディタに @monaco-editor/react、グラフに Recharts 3、アイコンに lucide-react。状態管理ライブラリは入れず、JudgeWorkspace という 1 つの Client Component が useState で全部持っています。実験アプリなので、画面遷移も認証もありません。
1. API キーはサーバー側だけが読む
Jev を呼ぶ lib/jev.ts の 1 行目は import "server-only" です。これを付けたモジュールを Client Component から import するとビルド時に落ちるので、キーがブラウザのバンドルに紛れ込む事故が構造的に起きません。
// lib/jev.ts
import "server-only";

export function isJevConfigured() {
  const provider = getProvider();
  return provider === "vercel"
    ? Boolean(process.env.AI_GATEWAY_API_KEY)
    : Boolean(process.env.TYPESAFE_API_KEY);
}
ブラウザに渡すのは「キーが設定されているか」の真偽値だけ。Server Component の app/page.tsx が isJevConfigured() を評価して props で渡します。
// app/page.tsx(Server Component)
export default function Home() {
  return <JudgeWorkspace jevConfigured={isJevConfigured()} />;
}
実際の呼び出しは Route Handler app/api/judge/route.ts の中です。.env.local は .gitignore の .env* で除外してあり、公開リポジトリには .env.example(値が空)だけを置いています。
2. 1 リクエストで 3 問を同時に聞く
Jev の「複数の質問を並列に評価する」性質をそのまま使い、1 回の呼び出しで Choice 1 問と Noul(Vercel では boolean)2 問を投げています。lib/jev.ts の createRequest が組む JSON は、要点だけ抜くとこうです。
{
  "model": "typesafe-ai/jev",
  "state": {
    "language": "TypeScript",
    "code": "…評価対象のコード…",
    "context": "This code is being reviewed immediately before a production deployment."
  },
  "questions": {
    "production_verdict": {
      "type": "choice",
      "instructions": "Is this code ready to deploy to production? Judge the code as provided. Select exactly one verdict.",
      "criteria": {
        "ship": "Safe and sufficiently robust to deploy as-is.",
        "caution": "Deploy only after review or a non-critical improvement.",
        "reject": "Do not deploy because of a material security, correctness, or reliability risk."
      }
    },
    "has_security_risk": {
      "type": "boolean",
      "instructions": "Does this code contain a material security vulnerability?",
      "criteria": {
        "true": "A realistic vulnerability exists in the code as provided.",
        "false": "No material security vulnerability is evident in the code as provided."
      }
    },
    "has_maintainability_risk": {
      "type": "boolean",
      "instructions": "Does this code have a material long-term maintainability risk?",
      "criteria": {
        "true": "The code has a concrete issue likely to make maintenance materially harder.",
        "false": "No material long-term maintainability issue is evident."
      }
    }
  }
}
production_verdict の確率を 0〜100 に丸めたものが画面のスコア、choice が判定です。2 つの Noul は Yes の確率が 0.5 以上のときだけ「セキュリティリスク 97%」のようなシグナルとして記録します(この 0.5 はアプリ側で決めた閾値です)。
質問文と criteria は「観点」として 3 種類用意し、promptVersion の文字列で版を固定しました。観点を変えると同じコードでもスコアが動くので、どの版で取った結果かが記録に残らないと後で比較できなくなります。
| 観点 | promptVersion |
context と質問の主旨 |
|---|---|---|
| Production | production-readiness-v1 |
本番デプロイ直前のレビュー。そのまま出せるか |
| Security | security-risk-v1 |
セキュリティレビュー。重大な脆弱性だけを見る |
| Maintainability | maintainability-risk-v1 |
長期保守のレビュー。保守に耐えるか |
リクエストの形は同じですが、Yes / No の質問の型名が Vercel AI Gateway では boolean、TypeSafe 直接では noul です。答えの形も { type: "boolean", probability } と { type: "noul", noul } で違います。アプリでは JEV_PROVIDER を見て型名を切り替え、答えのパースは両方の形を受けるようにしてあります(lib/jev.ts の booleanType と getNoulProbability)。
3. シミュレーターと実測を同じ履歴に混ぜない
キーが無い状態でも画面を作れるように、正規表現と重みで判定を真似るローカルシミュレーター(lib/judge.ts)を最初に作りました。壊し方ごとに重みを足し、REJECT が 50 以上なら REJECT、20 以上なら CAUTION という単純なルールです。
| 検出する壊し方 | 重み |
|---|---|
id: any |
8 |
id.trim() が無い(入力検証の削除) |
14 |
catch { return null; }(例外の握りつぶし) |
18 |
WHERE id = '${id}'(SQL 文字列結合) |
35 |
eval( |
45 |
便利な反面、実測の履歴にシミュレーターの値が 1 件でも混ざると、その CSV は使えなくなります。そこで 3 つの決まりを入れました。
- API がエラーになってもシミュレーターに落ちない。 Route Handler はキーが設定されていればエラーをそのまま返し、画面に「保存済み 2/3 回」のように出します。黙って模擬値で埋めるより、欠けている方が正直です
- 全レコードに
sourceを持つ。local-simulator/vercel-ai-gateway/jev-directの 3 値で、CSV にもそのまま出ます - 最初の実測が来た瞬間に、シミュレーターだけの履歴を捨てる。
JudgeWorkspaceのcommitResultsは「今の履歴が全部シミュレーター」かつ「新しい結果が実測」のときだけ履歴を置き換えます
setRecords((current) => {
  const containsOnlySimulation = current.every((r) => r.source === "local-simulator");
  const isLiveResult = results[0].source !== "local-simulator";
  return isLiveResult && containsOnlySimulation ? nextRecords : [...current, ...nextRecords];
});
もう 1 つ、ページを開いただけでは API を呼びません。初期表示の判定はモジュール読み込み時に judgeLocally(cleanCode) で作った模擬値で、experimentId は "local-preview"。Run か Mutation のボタンを押したときだけ課金対象のリクエストが飛びます。実験を何度もリロードしながら進めるので、この 1 点で無駄な呼び出しが相当減りました。
4. 実験条件を結果に埋め込む
判定の数字だけ保存しても、後で「これはどの観点で、何回目で、どの順番で壊したときの値か」が分からなければ表にできません。1 試行 = 1 レコードとして、条件を全部同じ行に持たせています。
| フィールド | 中身 |
|---|---|
experimentId |
Reset のたびに振り直す UUID。1 つの実験系列の単位 |
experimentMode / perspective |
cumulative か isolated / production か security か maintainability |
step / trialNumber |
何個目の壊し方か / 同じコードの何回目の試行か(1・3・5 回) |
mutation / mutationOrder |
今回加えた壊し方 / それまでに加えた順序(CSV では > 区切り) |
promptVersion / model / source |
質問の版 / 実際に応答したモデル名 / 接続元 |
verdict / scores / signals |
判定 / SHIP・CAUTION・REJECT の 0〜100 / 50% 以上のリスクシグナル |
elapsedMs / usage |
1 リクエストの往復時間 / 入力・出力トークン数 |
code / createdAt |
評価したコードの全文 / 時刻(ISO 8601) |
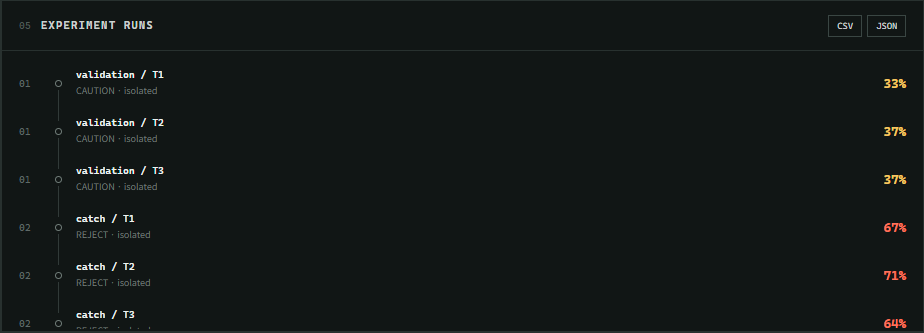
履歴パネル。壊し方・試行番号・判定・モードが 1 行に並び、CSV / JSON ボタンでブラウザ側だけで書き出す(サーバーには何も保存しない)
書き出しは Blob と URL.createObjectURL でブラウザ内だけで完結させました。サーバーに DB を持たないので、実験データの置き場は「ダウンロードした CSV / JSON をリポジトリの docs/article/data/ に入れる」です。1 人の実験にはこれで足ります。
5. 累積と独立を分ける理由
Mutation パネルには Cumulative / Isolated のモード切り替えがあります。違いは 1 行です。
const baseCode = experimentMode === "isolated" ? cleanCode : code;
累積は「今のコード」に次の壊し方を足していき、独立は「壊す前のコード」に 1 つだけ入れます。累積だけでは、5 段目で REJECT になった原因が 5 段目の壊し方なのか、それまでの積み重ねなのかを切り分けられません。独立だけでは、複数の問題が重なったときに判定がどう飽和するかが見えない。実験計画で言えば、順序効果と単体効果を別々に測っておく、という話です。
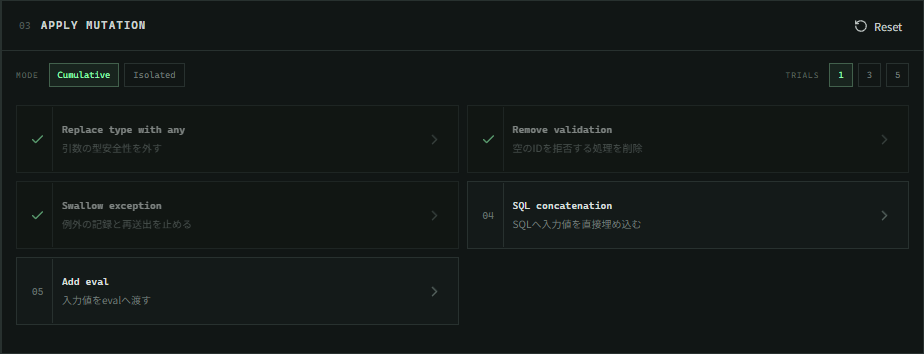
Mutation パネル。モードと試行回数を先に決め、壊し方を上から押していく。適用済みはチェックに変わり、二重適用はできない
TRIALS の 3 と 5 は、同じコードを続けて N 回聞く設定です。画面には平均と、平均が最大のラベルを出しますが、保存するレコードは 1 試行ずつです。平均だけ残すと、後述の「1 点差でラベルが割れる」現象はそもそも観測できません。
6. 失敗の言い分けとリトライ
Gateway に対しては 429(レート制限)と 529 のときだけ 300 ms・600 ms と間隔を広げて最大 3 回試し、それ以外は即座にエラーにします。全体には AbortSignal.timeout(15_000) で 15 秒の上限。エラー文は状態コードごとに分けました。
| 状態 | 画面に出す文 |
|---|---|
| 401 | API キーが拒否された |
| 403(Vercel) | Gateway が推論を拒否。クレジット・API キーの予算・チームのアクセス権を確認 |
| 422 | リクエストの形式が受け付けられない |
| 429 / 529 | リトライ後も不可なら「Jev remained unavailable after retries」 |
403 の文を分けたのは、Vercel の場合はキーが正しくてもクレジット残高や API キー単位の予算で止まることがあるからです。「キーが間違っている」と「予算が尽きた」を同じ文で出すと、確実に間違った場所を探し始めます。
🔑 Vercel AI Gateway の設定手順:キー発行から JEV LIVE まで
手順は 5 段階です。Vercel 側の画面と文言は 2026-09-22 時点のものです。
-
Vercel のチームで API キーを発行する。 ダッシュボードの AI Gateway から「Create API Key」を開き、名前を付けて作成します。キーの値は作成直後にしか表示されず、後から取り出せません。無料の AI Gateway クレジットを使うには、チームに有効な支払い方法を登録しておく必要があります
-
.env.localに 2 行書く。.env.exampleをコピーして、接続先とキーを入れますJEV_PROVIDER=vercel AI_GATEWAY_API_KEY=(発行したキー)モデル名とエンドポイントは省略でき、
typesafe-ai/jevとhttps://ai-gateway.vercel.sh/v1/evaluateが既定値です。TypeSafe 直接に切り替えるときはJEV_PROVIDER=typesafeとTYPESAFE_API_KEYに差し替えるだけです -
開発サーバーを再起動する。
.env.localはプロセス起動時に読まれるので、npm run devをやり直します。画面右上のバッジがLOCAL SIMULATORからJEV READYに変わっていれば、サーバーがキーを認識しています。この時点ではまだ 1 回も API を呼んでいません -
Run か Mutation を押す。 最初の実測が返るとバッジが
JEV LIVEになり、判定パネルの下に接続元・モデル名・プロンプト版・所要時間・トークン数のチップが出ます
右上のバッジ。LOCAL SIMULATOR → JEV READY(キー認識)→ JEV LIVE(実測が 1 回以上ある)の 3 段階
-
Gateway のログで裏を取る。 Vercel ダッシュボードの AI Gateway のログに、1 リクエストごとの状態・モデル・プロバイダー・トークン数・費用・所要時間・ルーティングの試行が並びます。反映まで最大 90 秒かかることがあるので、出てこなければ少し待ってから更新します
課金の単位はトークンです。Jev のモデルページは 2026-09-22 時点で入力・出力ともに Free と表示され、「Promotional pricing ends on September 25, 2026」の注記があります。つまりこの実験の Gateway 側の費用は 0 で、9 月 26 日以降の単価は未確認です。参考値として、TypeSafe 直接の公表単価は入力 $0.042 / MTok・出力無料。Gateway は有料ティアでもトークンに上乗せ(マークアップ)を取らないとドキュメントにあります。
Free Tier のリクエストはモデルごとにレート制限があり、超えると 429 が返ります。アプリ側は 429 を 2 回までリトライしますが、TRIALS を 5 にして Mutation を続けて押すと 1 分間に数十回の呼び出しになるので、止まったら少し待つのが正解です。クレジットを購入すると有料ティアに移り、上限が上がります。
📊 結果の要点:3 行だけ
48 回の審査で何が起きたかは、Qiita のレポートに表と図つきで書きました。ここでは見出しだけ引きます。
- 壊すほど悪くなるとは限らない。
anyを入れると REJECT 判定になったのに、続けて入力検証を消したら REJECT スコアが下がって CAUTION に戻った。累積・独立・修正の 3 つの実験で同じ向きに動いた - 100 に張り付いたら、それ以上は見えない。 SQL 文字列結合で REJECT 100。そこに
eval()を足しても消しても 100 のまま。2 つの重大な問題があるとき、1 つ直した効果はスコアに出ない - 1 点差でラベルが割れる。
any入りのコードを 3 回聞くと 47・48・49 で、判定は CAUTION・CAUTION・REJECT。境界の上にあるコードは、1 回聞いただけでは信用できない
数字の根拠・観点別の比較・修正実験・速度とコストの集計はこちら → コードを少しずつ壊して Jev の境界を測る ― 0.4 秒で答える審査員を信用する条件(48 回の審査)(Qiita)
この 3 つは、そのまま次の節の設計制約になります。単調でないならスコア単体で閾値を切れない。天井があるなら差分を細かく分けて聞く。ラベルが割れるなら N 回聞いて分布を見る。
🚦 実用にするには(設計案):PR のゲートに置くなら
「1 回 300 ms 台・出力は課金されない・確率つきで返る」という性質は、レビューの前段に置く自動ゲートに向いています。実測から導ける範囲で、構成・閾値・コスト・足りない実装を設計案として書きます。動かしてはいません。 実測は「15 行の関数を 47 回」しか無いので、数字は自分のリポジトリで取り直す前提です。
構成:hunk ごとに 3 問 × N 回
git diff -U0 origin/main...HEAD"] D --> Q["hunk ごとに Jev へ 3 問 × N 回
production_verdict
has_security_risk
has_maintainability_risk"] Q --> S{"セキュリティ Noul が
0.5 以上の hunk がある?"} S -->|"Yes"| SEC["セキュリティ担当へ
自動マージは止める"] S -->|"No"| T{"REJECT 中央値と
N 回の一致で 3 段"} T -->|"🔴 高"| STOP["チェック失敗
確率をコメントに貼る"] T -->|"🟡 中"| REV["人のレビュー必須
自動マージ停止"] T -->|"🟢 低"| PASS["自動通過
結果はコメントに"]
PR 全体ではなく hunk 単位で聞くのは、実験 2 の「天井」を避けるためです。1 つの hunk に SQL 結合があれば、その hunk が 100 になるだけで、他の hunk の情報は生き残ります。N 回聞くのは実験 3 の「1 点差」対策で、ラベルの多数決ではなく確率の中央値を使います。ラベルは丸めの結果なので、閾値の材料には向きません。
セキュリティの Noul を最初の分岐に置いたのは、実測でこの質問だけが SQL 結合と eval() に鋭く反応し(97%・93〜94%)、それ以外の壊し方では 50% 未満に留まったからです。反応の幅が大きい質問ほど、閾値が置きやすい。
閾値:3 段と確信度
| 段 | 条件(案) | 動作 |
|---|---|---|
| 🔴 高 | REJECT 中央値 ≥ 0.9、またはセキュリティ Noul ≥ 0.9 | チェック失敗。マージ不可 |
| 🟡 中 | REJECT 中央値がベースライン+0.15 以上/N 回でラベルが割れた/セキュリティ Noul ≥ 0.5 | 人のレビュー必須 |
| 🟢 低 | 上のどれにも当たらない | 自動通過。確率はコメントで残す |
「ベースライン」は、そのリポジトリの正常なコードに同じ質問をしたときの REJECT 確率です。今回の関数では、壊す前でも REJECT が 42〜48 で判定は CAUTION でした。正常なコードが 0 になる前提で閾値を置くと、全部が中に入ります。 ベースラインを先に測り、そこからの上昇幅で切る方が実測に合っています。
TypeSafe の公式ドキュメントは確信度を高・中・低の 3 経路に分け、境界はリスクで変える(低リスクの操作は低めの確信度でも自動、取り消せない操作は高い確信度を要求する)ことを勧めています。今回の質問にこれを当てると、1 つ困ることがあります。3 択の確信度をドキュメントのデモ式 (3 × 最大確率 − 1) / 2 で近似すると、壊す前のコード(SHIP 2・CAUTION 56・REJECT 42)でも 0.34、any 入り(CAUTION 51・REJECT 48)では 0.27 で、正常なコードの時点で「低」に入ります。この質問は CAUTION と REJECT の間で確率が割れやすく、確信度だけを見ると「常に人に回す」になってしまう。
なので設計案では、Choice の確信度は「N 回のラベルが割れたか」の補助にとどめ、閾値は Noul の確率と REJECT の中央値で切っています。もう一段良くするなら、CI 用に質問そのものを Noul 中心に組み直す方が筋がいい。「この差分は本番で問題を起こす変更を含むか」の Yes 確率 1 本なら、閾値は 1 つの数直線の上に置けます。
0.9・0.15・0.5 は、今回の 15 行の関数と production-readiness-v1 の質問文で観測した値の間に置いた案です。質問文を変えれば同じコードでもスコアは 2 割動きました(Qiita の「観点を変えて聞く」)。公式ドキュメントの勧めどおり、保守的な値から始めて自分のコードで調整してください。
コスト試算:月 1,000 PR でも $1 未満(TypeSafe 公表単価)
実測は 1 回 382 ms・入力 619 トークン(15 行の関数+質問文と criteria)・出力 85〜87 トークンです。PR 1 件を「差分 10 箇所 × 3 回 = 30 回」と置くと、直列で約 11 秒、入力は約 1.9 万トークン。TypeSafe 直接の公表単価(入力 $0.042 / MTok・出力無料)なら PR 1 件 $0.0008 です。
| 月の PR 数 | 呼び出し回数 | 入力トークン | 費用($0.042 / MTok) |
|---|---|---|---|
| 10 | 300 | 約 18.6 万 | $0.008 |
| 50 | 1,500 | 約 93 万 | $0.04 |
| 200 | 6,000 | 約 371 万 | $0.16 |
| 1,000 | 30,000 | 約 1,857 万 | $0.78 |
前提が 3 つあります。①619 トークンには質問文と criteria の固定ぶんが含まれるので、hunk が長くなったときの増え方は線形より緩いはずですが、未計測です。②Vercel AI Gateway の Jev は 2026-09-22 時点でプロモーション価格の Free(9 月 25 日まで)で、それ以降の Gateway 単価は未確認。上の表は TypeSafe の公表単価で計算しています。③直列 11 秒は hunk ごとに並列に投げれば数秒に縮みますが、Free Tier のレート制限に当たるので、有料ティアか間隔制御が要ります。
費用よりも、11 秒で 30 回の判断が返る方に価値があります。lint と同じ感覚で毎 push に走らせても、待ち時間がレビューの邪魔になりません。
GitHub Actions の構成案(未検証)
最小の形はこうなります。scripts/jev-gate.mjs は差分を hunk に分け、Gateway へ投げ、3 段の判定で終了コードを返す想定のスクリプトで、まだ書いていません。
name: jev-gate
on: [pull_request]
jobs:
  judge:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      - uses: actions/setup-node@v4
        with:
          node-version: 22
      - run: git diff -U0 origin/${{ github.base_ref }}...HEAD -- '*.ts' > diff.patch
      - run: node scripts/jev-gate.mjs diff.patch
        env:
          AI_GATEWAY_API_KEY: ${{ secrets.AI_GATEWAY_API_KEY }}
キーはリポジトリの Secrets に置き、スクリプトは今回の lib/jev.ts と同じ JSON を組んで https://ai-gateway.vercel.sh/v1/evaluate を叩けば済みます。結果は GITHUB_STEP_SUMMARY に表で書き、🔴 のときだけ process.exit(1)。フォークからの pull_request では Secrets が渡らないので、同一リポジトリのブランチからの PR に限った運用になります。
今回の実装で捨てていた情報:生の確率と確信度
反省点を 1 つ。lib/jev.ts は Jev が返した確率を整数に丸め、合計が 100 になるように再正規化してから保存しています。
function toPercent(value: number | undefined): number {
  if (typeof value !== "number" || !Number.isFinite(value)) return 0;
  return Math.round(Math.max(0, Math.min(1, value)) * 100);
}
この時点で、小数点以下の確率と、答えに付いてくる confidence は消えています(型定義には confidence: number があるのに、どこにも保存していません)。Noul も 0.5 未満の値は記録していません。結果、実験で一番気になった 1 件、つまり画面上は CAUTION 50・REJECT 49 なのに判定が REJECT だった試行と、同じ表示で CAUTION だった試行の違いが、後から追えなくなりました。丸めの前後で順序が入れ替わったのか、choice が最大確率と別の経路で決まっているのかは、生の値があれば 1 行で確かめられた話です。
直すなら、Judgment に raw を足して、そのまま CSV に出すだけです。
export type Judgment = {
  // ...既存のフィールド
  raw?: {
    probabilities: Record<string, number>;  // 丸める前の値
    confidence?: number;                    // Choice の確信度
    securityRisk?: number;                  // Noul の Yes 確率(0.5 未満も)
    maintainabilityRisk?: number;
  };
};
前節の閾値設計は、この raw が無いと動きません。中央値も確信度も、丸めた整数からは作れないからです。表示用に丸めるのは画面の仕事で、保存は生のまま。次に同じ種類のアプリを作るときは、最初にこの 1 行を決めておきます。
ハマりどころ 2 つ
Recharts のグラフは、撮った瞬間まだ動いていた。 記事用のスクリーンショットは Playwright で「Run ボタンが再び押せるようになった直後」に撮っていました。ところが右下の REJECT SCORE グラフの点が、表の値と合いません。42% の点が 9% 付近にある。原因は Recharts の Area の入場アニメーションで、既定の animationDuration は 1,500 ms。判定が確定した直後は、点がまだ最終位置に向かって動いている途中でした。対策は Area に isAnimationActive={false} を付けるか、撮影前に 1.5 秒以上待つかのどちらか。今回はグラフ部分を記事の画像から外す方を選びました。
String.prototype.replace は最初の 1 箇所しか置き換えない。 any の Mutation は code.replace("id: string", "id: any") で実装していて、ボタンの説明は「引数の型安全性を外す」でした。ところが保存された code を見ると、any が入ったのは関数の引数ではなく、その上にある type User = { id: string; ... } のフィールドです。最初に一致したのがそちらだったからで、実験としては「any を 1 箇所入れた」で成立していますが、狙った行ではありませんでした。壊す位置まで含めて意図どおりかは、保存された code を読み返して初めて分かります。全レコードにコード全文を持たせておいたのが、ここで効きました。
💭 所感:「安い判断」は、電子工作のどこに効くか
ここからは意見です。事実として確かめたのは「1 回 300 ms 台・出力は無料・確率つき・理由は返さない」の 4 点だけで、以下はそれを自分の作業に当てはめたときの想像です。冒頭の「機械が迷ったところだけ人が読む」は、コードレビューに限った話ではないと思っています。
ファームウェアの PR ゲート。 このサイトのセンサー基板のファームウェアでは、周期処理の待ちに vTaskDelay を使って送信周期が 60.574 秒に間延びし、グラフに穴が空きました。コンパイルは通り、lint も黙り、でも読めば 1 秒で分かる類の問題です。「この差分は周期処理の待ちに xTaskDelayUntil ではなく vTaskDelay を使っているか」「割り込みハンドラの中でブロッキング呼び出しをしているか」を Noul で毎 push に聞く。Yes の確率が 0.5 を超えた hunk だけ人が見る。上の CI 構成案がそのまま使えます。
シリアルログの一次判定。 ESP32 のブートログを 1 画面ぶん state に渡して「これはリセットループを示しているか」「ブラウンアウトの兆候があるか」と聞く。人が目で追えば分かることを、ログ収集のパイプラインの中で 300 ms で振り分ける。当たり外れは自分のログで測る必要がありますが、Jev の得意分野として公式が挙げる「文書や記録に対する真偽の判定」に、ログはかなり近い形をしています。
センサー値の異常判定は、測ってみないと分からない。 温湿度の 10 分ぶんの系列を文字列で渡して「異常か」と聞くのは、やれば動きます。ただ Jev の入力はテキストで、数列の判断が校正された確率で返るかは今回の実験からは何も言えません。閾値やヒステリシスで書ける異常は先にコードで書き、「閾値では書けないが人が見れば分かる」領域だけ Jev に回す、という順番だと思います。TypeSafe 自身も「コードが主導権を持ち、モデルには狭い判断だけを渡す」設計を勧めています。
3 つに共通するのは、答えが文章でなく確率で返るから、その後ろにコードを書けることです。LLM に頼むと「たぶん大丈夫だと思いますが…」を正規表現で読む羽目になる。Jev は 0.93 を返してくる。if (p > 0.9) が書ける。これは、マイコンのレジスタを読んでビットで分岐するのと同じ手触りです。理由を書かない審査員は、レビュアーとしては物足りないけれど、部品としてはとても扱いやすい。
⚠️ できないこと・確かめていないこと
- TypeSafe 直接接続は未検証。
noul型名や応答の形はドキュメントに合わせて実装しましたが、実際に通したのは Vercel AI Gateway のbooleanだけです - Score 型は使っていない。 今回の 3 問は Choice 1 つと Noul 2 つです
- 評価対象は 15 行の TypeScript 関数 1 種類。 他の言語・長い差分・複数ファイルでのトークン数と応答時間は測っていません
- 生の確率と確信度を保存していない。 3 段閾値の設計案は、
rawを保存する改修が前提で、まだ動いていません - CI ゲートは構成案。 GitHub Actions の YAML は実行していません。
scripts/jev-gate.mjsも未作成です - Gateway の単価は 2026-09-25 以降が未確認。 実験時点ではプロモーション価格の Free でした
- モデルの版は固定できていない。 Gateway のモデル名は
typesafe-ai/jev、TypeSafe 直接はjev-latestで、モデルが更新されれば同じコードでも数字は変わりえます。記事の数字は 2026-09-22 のものです - Jev の入力はテキストのみ。 画像・音声・動画は 2026-09-22 時点で非対応と公式ドキュメントにあります
✅ まとめ
- Jev は
(state, 型付きの質問) → 答えと確率の関数で、文章を生成しない。Choice / Score / Noul の 3 型と、確率の散らばりから作る確信度。RLCD で確率の校正を狙ったと公式は説明している - 経路は TypeSafe 直接・Vercel AI Gateway・OpenRouter・Cloudflare の 4 つ。直接は早期アクセスが満員で、Gateway ならキー 1 本でその日に始められる。リクエストの形は直接とほぼ同じで、Noul の型名だけ
boolean - アプリの設計で守ったのは 4 点。キーは
server-onlyのモジュールだけが読む/シミュレーターと実測はsourceで分け、実測が来たら模擬の履歴を捨てる/実験条件(モード・観点・試行番号・順序・プロンプト版・モデル・ms・トークン)を 1 レコードに全部持つ/ページ表示だけでは API を呼ばない - 結果の 3 つの意外(単調でない・天井で差が消える・1 点差で割れる)は、そのまま CI ゲートの制約になる。hunk 単位で・N 回聞いて・確率の中央値と Noul で切る
- 今回の質問では正常なコードでも確信度が「低」に入る。確信度の 3 経路をそのまま当てるより、Noul 中心に質問を組み直す方が閾値は置きやすい
- コストは TypeSafe 公表単価で月 1,000 PR $0.78。速さの方が価値で、30 回の判断が 11 秒で返る
- 捨てていたのは生の確率と確信度。表示のための丸めは画面で、保存は生のまま
冒頭のゴールに対して、今回どこまで来たか。審査員が何に反応するか(セキュリティの Noul が SQL 結合と eval() で点灯し、それ以外は保守性の Noul が動く)、どこで判定を変えるか(SQL 結合で 100 に張り付く)、どれくらいブレるか(境界の上では 1 点差でラベルが割れる)は測れました。そこから、信用できる使い方の形(hunk 単位で・N 回聞いて・確率の中央値と Noul で切る)も見えています。足りないのは、生の確率と確信度の保存、1 種類しかないサンプル、そして CI で実際に回した経験です。次の一手は順番どおりで、raw を保存する改修 → 自分のリポジトリの正常なコードでベースラインを取る → jev-gate.mjs を書いて同一リポジトリの PR で回す。「機械が迷ったところだけ人が読む」レビューに、測定器の側から近づいていきます。
よくある質問(FAQ)
Q: Jev は Copilot や Claude Code のコードレビューの代わりになりますか?
A: なりません。公式ドキュメントも「コーディングエージェントの LLM を Jev に置き換えることはできない」と明言しています。Jev は理由を書かず、判定と確率だけを返します。向いているのは、LLM のレビューの前段で「人が見るべき差分を絞る」「セキュリティ担当に回すかを決める」といった、同じ形の判断を毎回さばくゲートです。
Q: ブラウザから直接 Gateway を呼んではいけませんか?
A: API キーがブラウザに渡ってしまいます。今回のアプリは Next.js の Route Handler(app/api/judge/route.ts)を挟み、Jev を呼ぶモジュールに import "server-only" を付けて、Client Component から import した時点でビルドが落ちるようにしています。ブラウザが知っているのは「キーが設定済みか」の真偽値だけです。
Q: Vercel を使わず TypeSafe に直接つなぐには?
A: .env.local を JEV_PROVIDER=typesafe と TYPESAFE_API_KEY=… に差し替えるだけです。エンドポイントは https://api.typesafe.ai/v1/systemone、モデルは jev-latest、Yes / No の質問の型名は noul に切り替わります。ただし 2026-09-22 時点で TypeSafe の早期アクセスは満員で、Waitlist 登録が必要でした。直接接続はこの記事では未検証です。
Q: 無料でどこまで試せますか?
A: Vercel AI Gateway の Jev は Free Tier 対象で、クレジットを買わずに使えます(無料クレジットの利用にはチームへの支払い方法の登録が必要)。Free Tier はモデルごとにレート制限があり、超えると 429 が返ります。2026-09-22 時点で Jev の単価はプロモーション価格の Free、「2026-09-25 まで」と表示されており、それ以降は未確認です。
Q: ESLint があれば Jev は要りませんか?
A: 役割が違います。any と eval() は ESLint のルールで確実に拾えますが、入力検証の削除・例外の握りつぶし・SQL 文字列結合はルールが無ければ素通りします。lint で書けるものは lint に任せ、Jev には「ルールに書けないが読めば分かる」判断を渡す分担が、実測の挙動にも合っています。SQL Injection には専用ルールや Semgrep を足すべきで、Jev は静的解析の代わりではありません。
関連記事
- 【Google AI 実験室 #1】準備編|Google AI Studio で記事専用プロジェクトを作り、API キーを発行して Gemini を最初に呼ぶまで:API キーの置き場と課金の考え方は、Gemini でも Gateway でも同じ。あちらは Python、こちらは Next.js
- 【Google AI 実験室 #2】データシート QA|Gemini にデータシート PDF を読ませ、IC実験室の実測値で採点する:AI の答えを自分の測定で採点する、という同じ姿勢。あちらは文章を返す LLM、こちらは確率だけを返す Jev
- Claude Code で使える MCP ツールの作り方|Python で自作サーバを1本通す:AI に渡す道具を自作する側の話。Jev のようなモデルを MCP ツールの裏に置くのも一手
- 候補と残項目を人と AI で管理する自作 Web アプリ|FastAPI+SQLite+htmx で動くまで:もう 1 つの自作 Web アプリ。「誰が書いたかを全部残す」設計は、今回の「実験条件を全部レコードに持つ」と同じ発想
- ESP-IDFで自作するI2Cセンサードライバ|vTaskDelayの罠:所感で挙げた「lint では取れないが読めば分かる」問題の実例
参考
- Jev Code Judge(本記事のアプリ・実測データ・GitHub)
- コードを少しずつ壊して Jev の境界を測る ― 0.4 秒で答える審査員を信用する条件(48 回の審査)(Qiita・実験レポート)
- Introducing System One Models & Jev(TypeSafe AI Blog・2026-09-15) ── 2026-09-22 取得。RLCD・応答 70〜500 ms・入力 $0.042 / MTok・出力無料・Choice の選択肢 255 まで
- TypeSafe AI Docs ── 2026-09-22 取得:System One/Primitives/Confidence/AI primer(RLCD)/Jev with coding agents/How to build with TypeSafe/Confidence-gated routing
- Vercel AI Gateway ── 2026-09-22 取得:Jev モデルページ(Free・Promotional pricing ends on September 25, 2026・Context 32K)/Getting started/Authentication/Pricing
- OpenRouter:TypeSafe Jev Latest ── 2026-09-22 取得($0.042 / M 入力・$0.00 / M 出力・32,000 トークン)
- Cloudflare Workers AI:Jev(typesafe) ── 2026-09-22 取得(Beta)
- Qiita 公式イベント「あなたはもう試した?判断特化AI『Jev』で遊ぼう!」 ── 2026-09-22 取得(4 経路・TypeSafe 直接は Waitlist)
- Next.js:Route Handlers/Server and Client Components
- Recharts:Area(
animationDurationの既定値 1,500 ms は recharts 3.10.1 の実装で確認) - GitHub Docs:Using secrets in GitHub Actions(フォークからの PR には Secrets が渡らない)